Apache Spark 4.3 发布:实时模式迎来有状态处理

Apache Spark 4.3 让 Real-Time Mode 支持有状态处理,随 Databricks Runtime 19 提供。
Apache Spark 4.3 正式发布,并随 Databricks Runtime 19 一同可用。本次更新的核心是 Real-Time Mode 开始支持有状态处理,使低延迟路径不再局限于无状态的数据转换,能够承载聚合、去重、会话窗口等需要跨事件记忆的逻辑。这一变化对风控、实时指标等场景意义明确,也有助于把原本依赖外部流处理引擎的能力收回到 Spark 统一引擎内,简化架构。同时,有状态处理对检查点、状态存储和故障恢复提出更高要求,状态规模与恢复时延之间的权衡仍是生产落地的关键。由于原始发布信息较简短,具体实现细节与性能数据尚待社区实践验证。
Apache Spark 4.3 正式发布,并已在 Databricks Runtime 19 中可用。这次更新的核心信号很明确:Spark 正在把流处理的实时性推进到新的阶段——Real-Time Mode 开始支持有状态处理,这让原本需要额外组件或复杂架构才能实现的场景,有了在 Spark 内部完成的可能。
从无状态到有状态:Real-Time Mode 的关键一步
Spark 的 Structured Streaming 长期以微批(micro-batch)模型为主,延迟虽在持续优化,但真正的实时模式一直受限于状态管理的复杂度。无状态操作可以做到极低延迟,而一旦涉及聚合、去重、会话窗口等需要跨事件记忆的逻辑,往往要回到微批路径。
Spark 4.3 把有状态处理引入 Real-Time Mode,意味着低延迟路径不再只能做“一次性”的数据转换。对于风控、实时指标、事件去重这类典型场景,状态是刚需——没有状态,多数实时业务逻辑无法闭环。这次改动让实时模式的能力边界实质性扩展,也是 4.3 版本最值得关注的演进方向。
需要注意的是,有状态处理对检查点、状态存储和故障恢复提出了更高要求,实际落地时仍需关注状态大小与恢复时延之间的权衡。
微批(micro-batch)模型是 Structured Streaming 的默认执行模式:引擎周期性地把输入数据切分成小批次,逐批触发查询计划执行。这种方式在吞吐和容错上表现成熟,但端到端延迟受批次间隔约束,通常在百毫秒到秒级。Real-Time Mode 则改为持续处理(continuous processing)路径,事件到达即处理,不做批次切分,因而能把延迟压到毫秒级。两者的取舍在于:持续处理路径对状态管理、检查点和故障恢复的要求高得多,早期版本只支持无状态或受限的有状态逻辑,这也是为何有状态能力进入 Real-Time Mode 被视为关键突破。
有状态处理指算子需要跨事件维护记忆,例如聚合要保留累加结果、去重要记住已见键、会话窗口要跟踪窗口边界。Structured Streaming 用**状态存储(State Store)持久化这些中间状态,并通过检查点(checkpoint)**把状态快照与消费位点一起写入可靠存储,供故障恢复时重建。状态大小直接决定检查点开销和恢复时延:状态越大,快照越慢、恢复越久。因此在 Real-Time Mode 下引入有状态处理,工程上的难点不只是延迟,还包括如何控制状态膨胀、如何在不阻塞处理的前提下完成状态持久化。
Databricks Runtime 19 同步可用
新版本随 Databricks Runtime 19 一同提供,用户可以在该运行时中直接使用 Spark 4.3 的能力。对于已经在 Databricks 平台上构建流式管道的团队,这意味着升级路径相对平滑,不必自行维护 Spark 版本与运行时兼容性。
从版本节奏看,Spark 与 Databricks Runtime 的绑定发布已成惯例:Spark 侧的新特性先在运行时中验证可用性,再逐步向更广泛的部署形态扩散。对于自建集群的用户,仍需关注社区版与发行版之间的特性差异。
**Databricks Runtime(DBR)**是 Databricks 平台对 Apache Spark 的封装发行版,除 Spark 本体外还包含优化过的执行引擎、连接器、以及托管服务集成。DBR 与开源 Spark 存在版本映射关系,但并非逐特性完全对齐,部分能力会先在 DBR 中提供或经过平台侧调优。因此“Spark 4.3 在 DBR 19 中可用”意味着平台用户能较早获得该能力,而自建集群用户需要自行升级到对应开源版本,并自行承担兼容性验证与运维工作。
这次更新意味着什么
实时有状态处理的价值在于架构简化。过去要实现低延迟的带状态逻辑,常见做法是引入独立的流处理引擎,或者在 Spark 之外维护一套状态存储。Spark 4.3 的方向是把这部分能力收回到统一引擎内,减少数据在系统间的搬运。
当然,版本发布信息本身较为简短,关于状态后端的具体实现、与现有微批模式的行为差异、以及性能表现的量化数据,还需要等待更详细的技术文档和社区实践反馈。对于生产环境,建议先在非关键链路验证有状态实时模式的行为一致性,再逐步迁移。
升级建议
- 评估现有流式作业中依赖状态的算子,确认其是否适合迁移到 Real-Time Mode
- 关注检查点兼容性与状态恢复表现,尤其是状态规模较大的作业
- 在 Databricks Runtime 19 环境中先行测试,再考虑生产切换
- 持续跟踪社区对 Spark 4.3 有状态实时模式的实践报告
Spark 4.3 的发布延续了 Spark 在流处理实时性上的投入方向,有状态实时模式能否在生产规模下稳定兑现,将决定这次更新的实际分量。
相关推荐
Anthropic推出AI办公套件,企业市场再落一子
Anthropic推出AI办公套件,从编程工具向企业办公平台扩张。本文分析其产品战略、市场竞争格局及对企业用户的意义。
Google Fi推出超级网络:双5G自动切换提升覆盖
Google Fi推出超级网络功能,可在两个5G网络间自动切换以提升覆盖。本文介绍其工作原理、设备限制及对用户的实际意义。
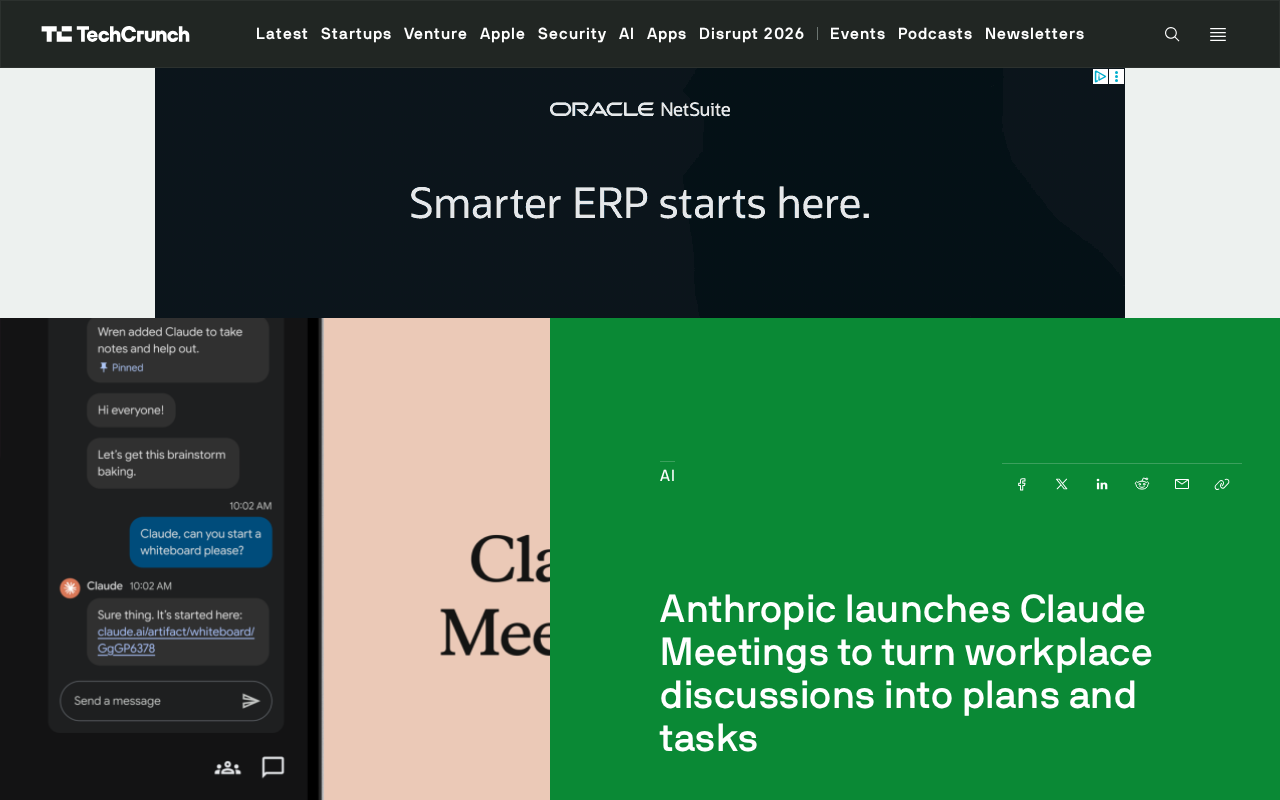
Claude Meetings上线:会议讨论直接生成计划与任务
Anthropic 推出 Claude Meetings,可在会议进行中起草计划、在白板梳理时间线、在聊天中答疑,并调用已连接工作应用检索信息,把讨论直接转化为计划与任务。