ApexW优化器实测:在Unsloth中与8-bit AdamW战平,内存占用更低
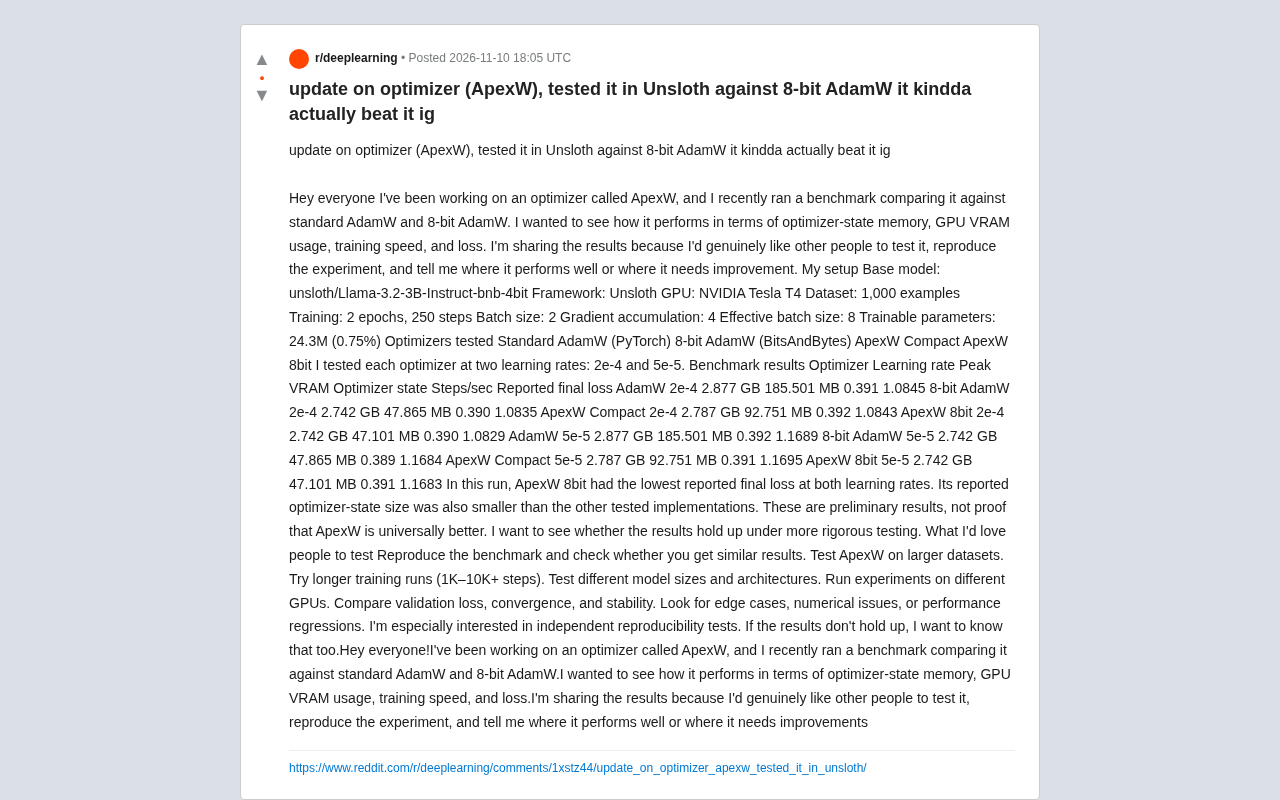
开发者初步测试显示ApexW 8bit优化器状态内存略低于8-bit AdamW,最终损失微弱占优,但速度相当,需独立复现。
一位开发者在Reddit上分享了新型优化器ApexW的初步基准测试,基于Unsloth框架和特斯拉T4 GPU,对比了标准AdamW、8-bit AdamW及ApexW的两个变体。测试固定了小模型(Llama-3.2-3B-Instruct 4bit量化)、1000样本、2个epoch等条件。结果显示,ApexW 8bit在优化器状态内存上为47.101 MB,略低于8-bit AdamW的47.865 MB,远低于标准AdamW的185.501 MB;最终损失在两个学习率下均略低于对比对象,但差距很小;训练速度几乎相同。开发者强调这些是初步结果,呼吁社区进行独立复现,并在更大数据集、更长训练、不同硬件上测试,以验证稳健性。
一位开发者在Reddit上分享了自己对新型优化器ApexW的初步基准测试。该测试基于Unsloth框架和特斯拉T4 GPU,对比了标准AdamW、8-bit AdamW以及ApexW的两个变体。结果显示,ApexW 8bit在最终损失和优化器状态内存占用上表现出微弱优势,但整体训练速度与其他优化器相当。
测试设置:小模型上的受控对比
为了进行公平对比,该开发者固定了以下条件:基础模型为unsloth/Llama-3.2-3B-Instruct-bnb-4bit(Llama 3.2 3B指令微调版,4bit量化),框架为Unsloth,GPU为NVIDIA Tesla T4,数据集包含1,000个样本,训练2个epoch、250步,批大小为2,梯度累积为4,有效批大小为8,可训练参数约24.3M(占总参数的0.75%)。
测试的优化器包括:PyTorch标准AdamW、BitsAndBytes的8-bit AdamW、ApexW Compact和ApexW 8bit。每个优化器在两个学习率(2e-4和5e-5)下运行。
Unsloth框架:Unsloth是一个专注于大语言模型(LLM)高效微调的开源框架,通过手写GPU内核、动态量化与内存优化技术,显著降低训练显存占用并提升训练速度。它特别适合在消费级GPU(如T4)上进行参数高效微调(如LoRA)。Unsloth支持与Hugging Face生态无缝集成,并内置了对4-bit量化模型(bnb-4bit)的加载与训练支持,使得在有限显存下微调3B参数模型成为可能。本次测试即利用Unsloth的优化能力,在Tesla T4(16GB显存)上完成对Llama-3.2-3B-Instruct的微调。
LoRA与可训练参数:LoRA(Low-Rank Adaptation)是一种参数高效微调方法,它冻结预训练模型的主权重,仅在Transformer层的特定线性层旁注入低秩分解矩阵进行训练。文中可训练参数约24.3M(占总参数的0.75%)即指LoRA适配器的参数量。优化器状态内存主要针对这些可训练参数及梯度,因此数值远小于全参数微调。理解这一点有助于解释为何优化器状态内存的绝对差异(如47MB vs 185MB)在整体显存中占比较小,但相对比例仍然显著。
结果:ApexW 8bit内存更低,损失略优
在峰值显存方面,AdamW为2.877 GB,8-bit AdamW和ApexW 8bit均为2.742 GB,ApexW Compact为2.787 GB。优化器状态内存差异更为明显:AdamW占用185.501 MB,8-bit AdamW占用47.865 MB,ApexW Compact占用92.751 MB,而ApexW 8bit仅占用47.101 MB,比8-bit AdamW还略低一点。
训练速度(每秒步数)非常接近:AdamW为0.391,8-bit AdamW为0.390,ApexW Compact为0.392,ApexW 8bit为0.390(学习率2e-4时);学习率5e-5时趋势类似,差异均在0.001-0.002之间。
最终损失方面,在学习率2e-4下,ApexW 8bit报告了最低的1.0829,而8-bit AdamW为1.0835,AdamW为1.0845;学习率5e-5下,ApexW 8bit为1.1683,8-bit AdamW为1.1684,AdamW为1.1689。虽然优势不大,但ApexW 8bit在两个学习率下都略优于对比对象。
开发者本人强调这些是初步结果,尚不能证明ApexW具有普遍优越性。
8-bit优化器与分块量化:8-bit AdamW(来自BitsAndBytes库)通过分块量化(block-wise quantization)将优化器状态(如Adam的一阶矩和二阶矩)从32位浮点数压缩为8位整数存储,从而大幅减少内存占用,同时通过动态缩放保持数值稳定性。ApexW 8bit显然采用了类似的量化策略,但其具体实现细节未公开。优化器状态内存的差异(如ApexW 8bit的47.101 MB vs 8-bit AdamW的47.865 MB)可能源于量化粒度、元数据开销或状态分片方式的不同。需要注意的是,这种微小差异可能受测量误差或实现细节影响,需在更大规模下验证。
峰值显存与优化器状态内存:峰值显存(Peak GPU Memory)指训练过程中GPU显存的最大使用量,包括模型权重、梯度、优化器状态、激活值和临时缓冲区。优化器状态内存仅占其中一部分。在LoRA微调中,由于可训练参数少,优化器状态内存的绝对值较小,因此不同优化器间的峰值显存差异不如全参数微调时明显。本文中AdamW与8-bit优化器的峰值显存差约135MB,与优化器状态内存差(约138MB)基本吻合,说明其他组件(如激活值)的显存占用相近。
开发者呼吁:需要独立复现与更严格测试
该开发者公开邀请社区进行复现和扩展测试,希望验证结果是否稳健。他特别希望:
- 在更大数据集上测试ApexW;
- 进行更长的训练(1K至10K+步);
- 尝试不同模型尺寸和架构;
- 在不同GPU上实验;
- 对比验证损失、收敛性和稳定性;
- 寻找边缘情况、数值问题或性能回退。
他对独立复现尤其感兴趣,并表示如果结果不能成立,也愿意接受。
统计显著性与基准测试严谨性:文中报告的最终损失差异极小(如1.0829 vs 1.0835),在单次运行、小规模数据集(1000样本)下,这类差异可能源于随机种子、数据顺序或数值噪声,未必具有统计显著性。严谨的基准测试通常需要多次重复实验并报告均值与标准差,或使用统计检验判断差异是否显著。此外,训练速度的差异(0.390 vs 0.392步/秒)在测量误差范围内,实际意义有限。开发者呼吁独立复现正是为了排除偶然因素,并建议在更长训练、更大数据集上观察趋势是否稳定。
如何看待这次基准测试
从数据看,ApexW 8bit在优化器状态内存上达到了与8-bit AdamW相当甚至略低的水平,而最终损失略有优势;Compact版本内存占用居中,但远低于标准AdamW。然而,这些差异在统计上是否显著、是否能在更大规模上保持,仍需进一步验证。
对于关注训练效率的从业者,这项测试提供了一个新选项,但在生产环境中采用前,建议等待更多独立复现结果,尤其是在全参数微调或更大模型上的表现。
目前ApexW的代码和更多细节未在帖子中提供,感兴趣的读者可以关注原帖后续更新。
相关推荐
Skykea Showdown:Minecraft飞艇建造赛的爆笑综艺体验
Skykea Showdown是一档Minecraft飞艇建造竞速综艺,本文解析其建造+穿洞双阶段赛制、飞艇模组的升力物理机制、秘密任务设计和队伍对抗的综艺效果,适合游戏内容创作者参考。
美国中期选举向AI数据中心说不?地图揭示真相
美国中期选举后媒体称选民否决AI数据中心,但地图显示限制性投票集中在俄亥俄州少数乡镇,影响不到全美城镇百分之一,所谓全国性反AI浪潮被夸大。
美国计算机专业入学人数骤降12.4%,CS还值得学吗?
计算机科学入学人数下降12.4%,健康类专业增长6.2%。一位CS硕士创作者深入分析:AI时代学CS的真正价值不是写代码,而是系统思维与多路径求解能力。学生为何逃离CS?安全牌为何变成赌博?