API vs 本地部署大模型:成本账与选型指南

API 赢在起步、本地赢在长期,按用量与隐私需求选型。
文章把「用云端 API 还是本地跑模型」拆成一笔成本账,结论是 API 赢在起步、本地部署赢在长期。API 路线零硬件投入、兼容 OpenAI 格式、几行代码即可接入,注册多送免费额度,但存在额度上限、速率限制和超量按 Token 计费的问题;轻度用户每月几千万 Token 用便宜模型仅 2-30 元,API 明显更划算。本地部署的真正成本在硬件:7B 量化版 4-6G 显存可跑,二手 3090 两三千元,70B 需 48G 以上显存、成本过万;一次性投入在重度使用几个月后即可回本,此后接近免费且数据不外传。文章据此把用户分为轻度/原型开发、重度用户、隐私敏感三类给出选型建议,并推荐 Ollama 作为最省事的本地部署路径。
为什么这笔账值得算清楚
面对大模型,很多人第一反应是纠结:用云端 API 还是自己买显卡跑本地模型?B 站一期视频把这个问题拆成了一笔实在账,不聊玄学,只算成本与场景。视频的核心结论很清晰:用 API 赢在起步,本地部署赢在长期。但这个结论背后有几个关键变量——使用频率、硬件投入、隐私需求——值得展开分析。
API 路线:低门槛起步,但有隐性约束
API 的本质是调用大厂开放的接口。DeepSeek广告、智谱、Kimi、Google Gemini 等平台大多注册就送免费额度,不用买硬件,上手也简单:基本都兼容 OpenAI 格式,装个 SDK、填个密钥,几行代码就能把模型调起来。
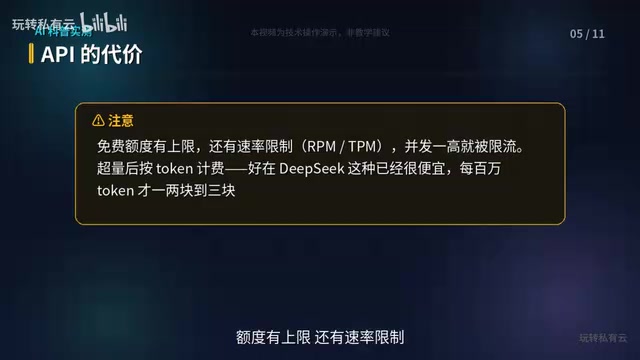
但免费不是没有代价。额度有上限,还存在速率限制,并发一高就会被限流;超量后按 Token 收费。好在 DeepSeek 的价格已经压得很低,视频中提到轻度用户每月几千万 Token 用便宜模型只要 2-30 块,这个量级下 API 完胜本地部署。
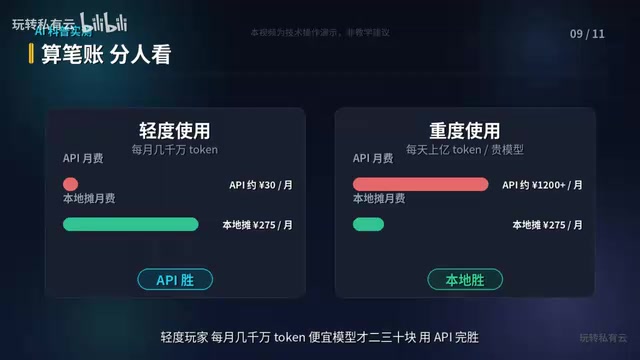
需要留意的是,API 的成本结构是线性的:用多少付多少,长期重度使用会持续累积。视频给出的参照是,每天上亿 Token 或用 GPT Cloud 这类规模化服务,月费轻松上千。
Token 与速率限制是理解 API 成本结构的两个基础概念。Token 是模型处理文本的最小单位,可粗略理解为「字/词片段」:英文一个单词常对应 1 个 Token 左右,中文一个汉字通常约占 1-2 个 Token。API 计费按「输入 Token + 输出 Token」分别计价,因此长上下文、长对话的成本会显著高于短问答。速率限制(Rate Limit)则是平台对单位时间内请求数或 Token 数的配额约束,常见维度包括每分钟请求数(RPM)与每分钟 Token 数(TPM);一旦并发超出阈值,请求会被排队或直接返回限流错误。这也是为什么免费额度适合验证与轻度使用,而不适合高并发生产场景——限流带来的重试与延迟,往往比费用本身更影响体验。
本地部署:一次性投入,长期摊薄
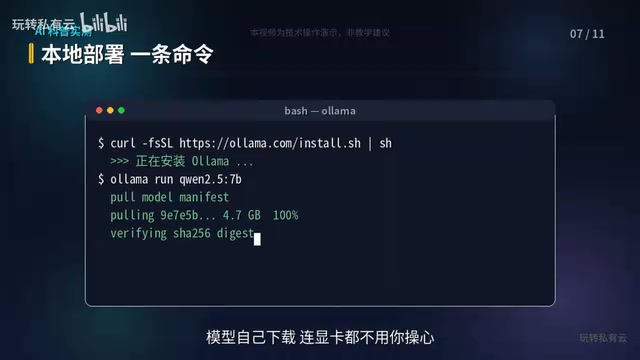
本地部署是把模型下载到自己机器上跑。视频推荐的最省事路径是 Ollama:一行装好,一行启动,模型自己下载,连显卡都不用操心,自动调用直接就能开。
真正的成本在硬件。按视频给出的数据:7B 量化版 4-6G 显存就能跑,8G 更从容;一张二手 3090 两三千块;想跑 70B 需要 48G 以上显存,多卡或专业卡成本瞬间过万。
这笔投入的分摊逻辑很直接:一次性两三千块,重度使用几个月回本,之后等于免费用,而且数据不外传。对长期高负载、在意隐私的用户,这是 API 给不了的价值。
量化是本地部署能在消费级显卡上跑起来的关键。它把模型权重从 16 位浮点压缩到 8 位、4 位甚至更低精度,用少量精度损失换取显存占用和推理速度的大幅改善,因此「7B 量化版 4-6G 显存可跑」才成立。模型名称中的 7B、70B 指参数量(十亿计),参数量越大通常能力越强,但对显存的需求也近似线性上升,这就是 70B 需要 48G 以上显存的原因。此外,Ollama 这类工具封装了模型下载、量化格式选择与 GPU 调用,省去了手动配置推理框架的步骤,但显存不足时仍会自动回退到 CPU 推理,速度会明显下降——这也是评估本地方案时需要提前确认的一点。
分人算账:三类场景的选型建议
视频把用户分成两类,实际决策中可以细化为三类:
轻度玩家/原型开发:每月几千万 Token 的用量,便宜模型只花 2-30 块,买显卡的钱够用很久 API。怕麻烦、要快速验证想法,API 是最省心的选择。
重度用户:每天上亿 Token 或依赖规模化服务,月费轻松上千,本地一次性投入两三千,几个月回本。长期看本地更划算。
隐私敏感型:数据不能出本地,API 路线直接排除,本地部署是唯一解。
结论与下一步
API 赢在起步:零硬件投入、几行代码接入、按量付费。本地赢在长期:一次性成本摊薄后接近免费,数据可控。决策的关键不是哪个技术更好,而是你的使用频率和隐私要求落在哪个区间。视频结尾预告了下一期内容——用 Ollama 搭建自己的知识库,这正好是本地部署的典型落地场景。
常见问题
Q:免费 API 额度够用吗? A:取决于用量。额度有上限且存在速率限制,并发一高会被限流,超量按 Token 收费。轻度使用足够,重度使用需要评估付费成本。
Q:跑本地模型一定要高端显卡吗? A:不一定。7B 量化版 4-6G 显存就能跑,8G 更从容。只有跑 70B 这类大模型才需要 48G 以上显存,成本显著上升。
Q:Ollama 适合新手吗? A:视频给出的评价是最省事的本地部署方式,一行安装、一行启动,模型自动下载,无需手动管理显卡调用。
相关推荐

DeepSeek Harness速通指南:从安装到5个实战案例
DeepSeek Harness 是什么?本文基于 B 站教程,介绍这款 AI Agents 软件的工作原理、安装配置、四种工作模式,并通过 3D 赛车游戏、官网、音乐播放器、科普动画、自开发插件五个实战案例展示其能力,附 Token 省钱技巧。

拆解DeepSeek Super-agent架构:Router+Worker如何破解多会话管理瓶颈
解读DeepSeek Super-agent论文:Router+Worker双层架构如何通过Fast Pass、链式召回、存算分离解决多AI会话管理瓶颈,并分析其对人注意力瓶颈的真实缓解程度与工程取舍。

5天1.9万星!DeepSeek开源AI程序员为何爆火
DeepSeek开源AI程序员5天斩获1.9万星,从零登顶GitHub榜首。它为何爆火?本文分析智能体赛道热潮、AI自写代码的叙事以及从问答工具到AI员工的范式转变,并提醒研究代码仍需谨慎审核。