A卡部署Qwen3实战:Strata引擎本地跑大模型全流程避坑指南

实战记录:在AMD RX 7900 XTX上用Strata引擎完整部署125B MoE大模型,含调优、图像识别与版本升级全链路避坑指南。
本文是一份在AMD RX 7900 XTX 24G显卡上部署Qwen3.8 Flash Next(约125B参数MoE模型)的完整实战记录,覆盖从仓库分支选择、网络下载加速、HipBLASLt调优表对齐、图像识别CPU方案,到0.1.38版本升级的全链路踩坑经验。核心结论是:AMD用户必须选Strata主线分支,调优表版本与GPU架构必须严格对齐(否则Prefill吞吐腰斩),图像识别只能走CPU编码路线但零显存占用反而是优势,升级至0.1.38后Prefill提速2–2.5倍、解码提速3倍,256K超长上下文几乎零代价可用。这套方案证明了A卡本地部署大模型的可行性,打破了CUDA生态垄断的固有认知。
为什么选择在A卡上跑本地大模型
长期以来,本地部署大语言模型几乎是N卡的专属游戏,CUDA生态的成熟让AMD显卡用户望而却步。但这篇实战记录证明了另一条路的可行性:在一张RX 7900 XTX 24G显卡上,基于Strata引擎完整跑起Qwen3.8 Flash Next(约125B参数的MoE模型),不仅能文本推理,还能实现图像识别,并且支持版本持续升级。
整套测试环境为RX 7900 XTX 24G + Ryzen 9 9950X + 62G内存 + 2TB空闲硬盘。模型是Qwen3.8 Flash Next,推理引擎选用Strata。这不是一次简单的"跑通即可"的演示,而是把部署、编译、调优、图像识别到版本升级的全链路都走了一遍,重点落在那些容易忽略的步骤和实际踩过的坑上。
MoE(混合专家)模型简介
Qwen3.8 Flash Next采用的MoE(Mixture of Experts)架构与传统稠密模型有本质区别。稠密模型每次推理都会激活全部参数,而MoE模型将参数分布在若干"专家"子网络中,每个Token只路由给其中少数几个专家处理。125B总参数并不意味着每次推理都要计算125B,实际激活量远小于此——文中提到激活10138个专家,对应的是模型在推理时动态选中的专家数量。这使得MoE模型在显存受限的消费级显卡上具有独特优势:可以把不常用的专家权重暂时驻留在内存或以较低精度缓存,只在需要时调入显存,从而用24G显存撬动名义上远超显存容量的超大模型。
第一个分叉:仓库分支与网络下载
部署的第一步就有一个关键选择。Strata仓库只有Main和RC 0.1.30两条线,RC是9月底的旧候选分支,只携带旧后端,而HIP引擎从V0.1.34才进入主线。因此AMD卡用户必须走Main分支,对应当时的0.1.36版本——走错分支会直接导致后续无法使用A卡后端。
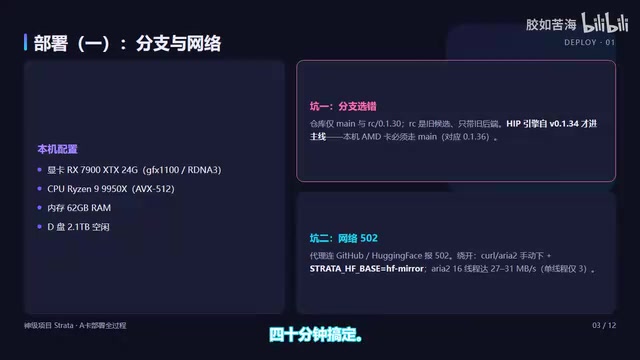
网络是整个流程的第一个大坑。即便环境配置了代理,Python走代理连接GitHub和Hugging Face仍会报502错误。解决办法是绕开Python下载链路,改用Curl或Aria2手动下载发布包,并为下载工具设置STRATA_HF_BASE指向HF Mirror镜像。单线程下载只有3MB/s,66G的模型要耗时约6小时;而Aria2开启16线程后能跑到27–31MB/s,40分钟即可搞定。
还有一个极易遗漏的点:要让Setup跳过模型下载,必须使用GGUF_DIR高级参数指定目录。仅仅把文件放进Models目录是不够的——如果没有正确的标记文件,Setup会判定模型不存在并重新下载一遍,而且这个标记必须在Setup启动前就位。
两档量化模型实测数据:IQ2_XXS短问答48、长文63 Token/s;IQ3_XXS短问答30、长文39 Token/s。显存占用约16.44G,激活10138个专家,IQ2比IQ3快约6成。
编译与调优:HipBLASLt调优表是性能关键
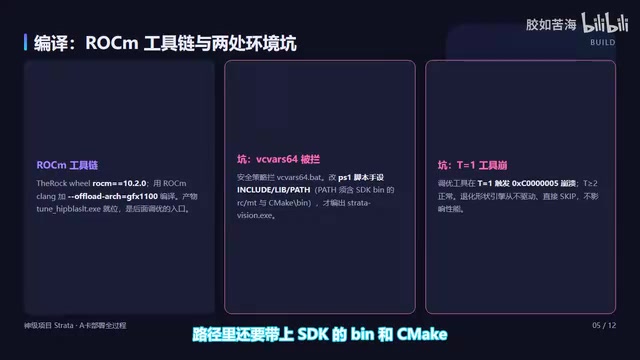
调优前需要先编译工具链。ROCm采用The Rock的Wheel包,版本10.2.0装在本地,编译HipBLASLt调优工具时用ROCm的clang并设置OFFLOAD_ARCH=GFX1100。由于VC Force64被安全策略拦截,MSVC和Windows SDK的头文件、库路径需要用脚本手动注入,最终产物hipblaslt-bench.exe就位。
这里有两个编译坑:调优工具在T=1时会崩溃,T>=2才正常,这是一个退化形状;引擎则直接跳过Vision的编译,同样踩到VC Force64被拦的问题,需改用PS脚本手动注入MSVC和SDK的环境变量,路径里还要带上SDK的bin和CMake的bin,才能编出StrataVision.exe。
调优的核心是HipBLASLt的调优表。根因很清楚:引擎在表头版本或架构不匹配时会整张表拒收,导致16个稠密投影(占Prefill约一半)全部退回慢路径,4–9K提示词只有405–485 Token/s。本机运行时版本是100500,而仓库自带的GFX1100表版本更早,匹配的100500表却是给GFX1201的,所以对不上。
解决思路是让引擎按TypeMKLDY精确匹配,再选最接近实际Token数的T桶。最终标出一张112形的表(16个形状×7个T桶),启动脚本指向它,再开启MMQ、Prefill分块。实测4–9K的Fresh Prefill从405跃升到701–775 Token/s,正好落在社区所说的700–800区间,翻了约1.8倍,解码稳定在52–55。
另一个静默坑是校准脚本。Setup里叫做准直的步骤只对N卡生效,AMD装机时会悄悄跳过。需要手动用虚拟环境补跑,得出的PSI最优Prefill分块Auto 16384能让长提示词再快约2成。AMD缓存默认全长驻显存,这是Prefill最快的路径。
HipBLASLt调优表的工作原理
HipBLASLt是AMD ROCm生态中负责矩阵乘法加速的库,类似于NVIDIA的cuBLAS。大语言模型推理的计算瓶颈几乎全部集中在矩阵乘法(GEMM)上,而不同形状(M×N×K)的矩阵在GPU上有截然不同的最优算法。调优表(tuning table)本质上是一份"形状→最优算法"的预查找手册:离线阶段针对特定GPU架构和驱动版本,对常见的矩阵形状跑遍所有候选算法并记录最优选择;推理阶段引擎直接查表选算法,省去运行时搜索开销。调优表的版本号和架构标识(如GFX1100对应RX 7900系列)必须与实际运行环境严格匹配,否则引擎会整张拒收并退回到未优化的通用路径,导致Prefill吞吐大幅下降。这正是文中405 Token/s与701–775 Token/s之间差距的根本原因。
图像识别:CPU路线是AMD唯一可行方案
官方口径明确:AMD没有GPU图像编码器。Windows的AMD HIP包只携带文本后端,GPU图像编码器需要另行编译。因此原始部署是纯文本的。
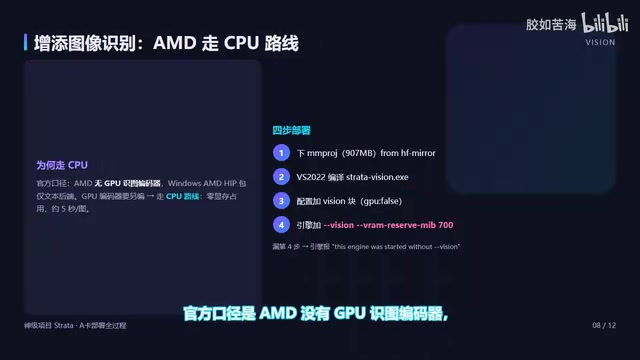
解决方案是走CPU路线:从镜像下载mmproj文件,编译出StrataVision.exe塞进引擎目录,配置里加上Vision参数以及Vision和VRAM Reserve两行。这里要特别注意——VRAM Reserve这行参数一旦漏掉,引擎会汇报"没带Vision"而启动失败。
全链打通后,发送一张本地图片,模型能准确描述内容,CPU编码零显存占用,约5秒识别一张图。对于24G显存已被模型占满的场景,CPU编码零显存开销反而是个优势。
多模态模型的图像编码流程
支持图像输入的大语言模型通常分为两个阶段:首先由一个独立的视觉编码器(Vision Encoder,对应文中的mmproj/StrataVision组件)将图像转换为与文本Token同维度的向量序列,再将这些向量连同文字提示一起送入语言模型主干进行推理。视觉编码器通常基于CLIP或SigLIP等架构,计算量相对较小但需要独立编译和部署。在NVIDIA平台上,视觉编码器可以利用CUDA直接在GPU上运行;而在AMD Windows平台上,由于HIP包目前不包含GPU版图像编码器,只能退而在CPU上执行这一步骤。CPU编码虽然耗时约5秒,但完全不占用显存,对于显存已被125B模型权重占满的场景,这反而是最务实的选择。
版本升级:从0.1.36到0.1.38的变化
升级前先查GitHub,0.1.36之后有0.1.37和0.1.38两个版本。0.1.37改为按WDDM预算统计显存,专家缓存不再一次性全出;0.1.38改了HIP提示词路径并加了Pro Group MTP。
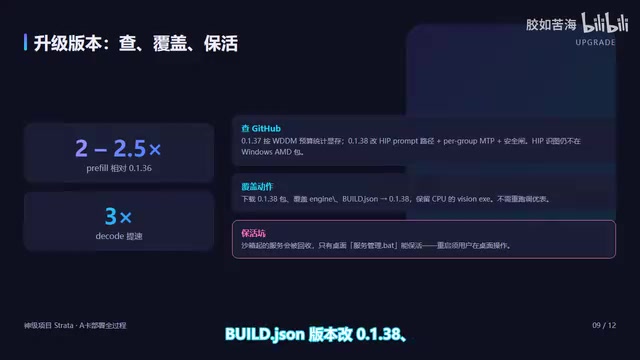
需要提醒:Windows的AMD HIP包仍只带文本后端,GPU图像编码器要另编,因此CPU路线依然是唯一的图像识别方案。0.1.38还加了安全闸,仅本机地址可访问、跨站浏览器请求会被拒绝。本地管理器走127.0.0.1且不带Origin,可正常通行。
升级动作是下载0.1.38的包覆盖引擎目录,Build GSOM版本号改为0.1.38,保留CPU的VisionX。这里有个保活坑:沙箱里拉起的服务会被回收重启,需要靠桌面上的服务管理脚本保持常驻。
升级后实测Prefill相对旧版提升2–2.5倍,解码提升3倍。两个发现值得单说:一是32K的Prefill记录到1931 Token/s,附件场景冷态稳定约1300–1931,这是专家常驻显存的热带峰值,真实算力段在2100–2400;二是把上下文从192000拉到256000时,引擎自爆(Strata独占内存约40G,专家显存24G卡占满),两档模型都稳定运行,只是专家缓存从16.44G降到13.66G、KV从4.31G升到7G,总额仍占满。速度测试显示Prefill曲线重合、解码同区间,原因在于KV全显存加专家缓存自动平衡,拉长上下文几乎是零代价。
WDDM显存预算管理机制
0.1.37版本引入的WDDM预算统计变化值得理解。WDDM(Windows Display Driver Model)是Windows下GPU驱动的统一接口,与Linux的直接内存管理不同,WDDM会动态调度显存分配,应用程序无法像在Linux下那样直接锁定全部物理显存。旧版引擎可能尝试一次性将所有专家缓存写满显存,在WDDM环境下容易触发超额分配或被驱动回收。0.1.37改为按WDDM实际可用预算动态统计,专家缓存分批加载,更符合Windows驱动的调度模型,也使得显存边界行为更加稳定可预测。这一改动是Windows平台AMD卡稳定性提升的重要基础,为0.1.38进一步优化HIP提示词路径创造了条件。
实战经验总结
整趟路跑下来,有五条核心经验值得记住:
- 分支选Main:HIP引擎只在主线,RC分支不带A卡后端。
- 网络走镜像+多线程:绕开Python代理,用Aria2多线程下载HF Mirror。
- 测速看引擎自爆那一行:显存与上下文边界是重要信号。
- 调优表版本架构要对齐:校准脚本AMD必须手动补跑。
- 服务靠桌面脚本常驻:沙箱服务会被回收。
256K上下文可以放心使用。这条A卡上的大模型部署路,已经被完整跑通。对于手握AMD显卡又想本地化部署大模型的用户,Strata引擎加上这套避坑经验,提供了一个此前被严重低估的可行方案。
相关推荐

Cursor低价账号避坑指南:共享号与破解工具的真实风险
深度拆解Cursor低价账号、共享号与破解工具的三种套路及真实风险,分析API中转降质、封号锁设备等问题,帮你理性判断是否选择第三方代充服务。
Vibe Coding零基础实战指南:用自然语言驾驭Codex与Claude Code
零基础Vibe Coding实战教程解析:从施工者模式到业主模式的开发范式转变,详解Codex与Claude Code工具选型、模型搭配与SOP复用,带你用自然语言完成从零到一的Web项目。
Cursor高效实战指南:资深工程师的10倍效率工作流
资深工程师用Cursor实现10倍效率的完整实战指南:拆解Tab、Command K、Chat三种交互模式,Plan与Agent两阶段工作流,规则命令记忆配置,以及并行智能体、后台代理、BugBot与MCP等高级工作流。