ARC-AGI-2竞赛新进展:Kaggle分数持续攀升

有参赛者宣称在Kaggle平台ARC-AGI-2基准上取得突破,折射AI抽象推理能力的最新进展与局限。
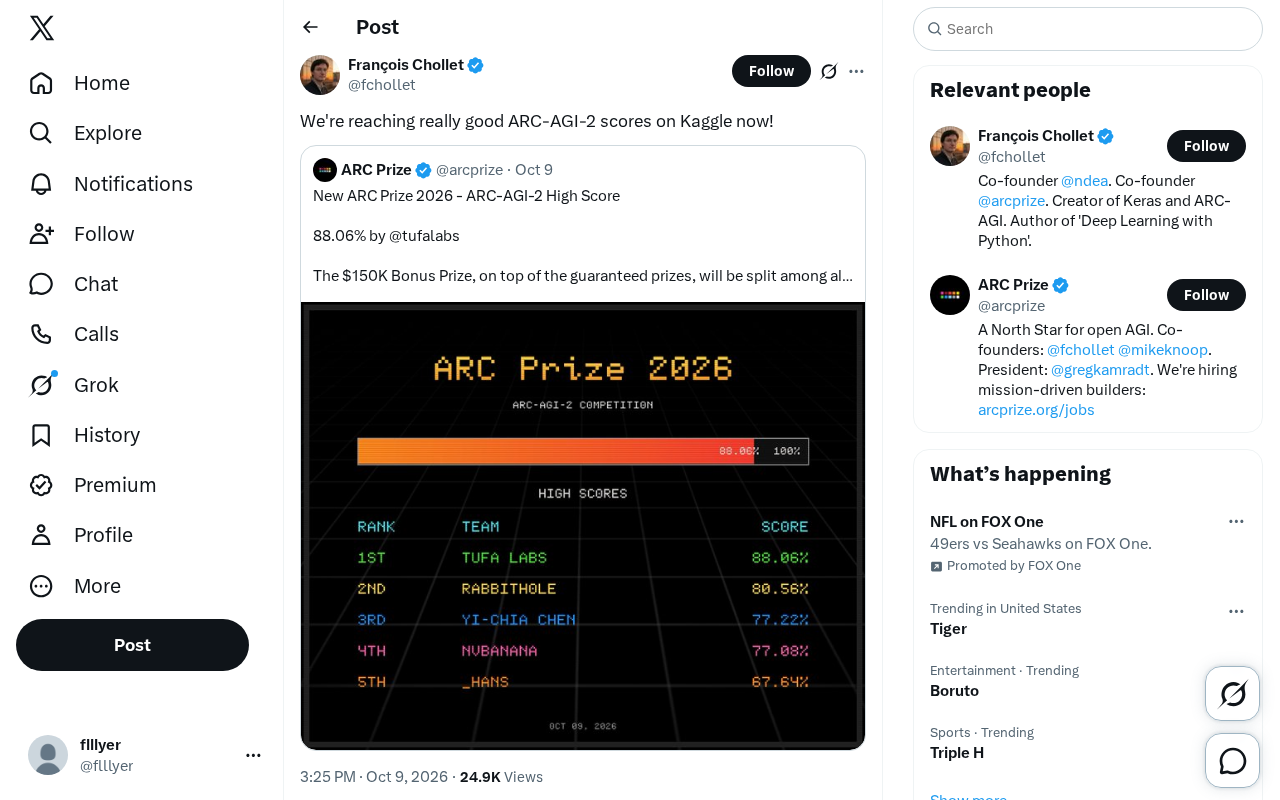
ARC-AGI-2是由François Chollet设计的高难度AI推理基准,专门考察模型在无法依赖预训练记忆的情况下,仅凭少量示例进行即时归纳与泛化的能力。近期有参赛者在Kaggle平台上宣布取得了相当不错的成绩,引发社区关注。由于该基准刻意规避了大模型"背答案"的捷径,任何可见进步都被认为反映了程序合成、测试时推理或神经符号混合架构等技术路线的实质突破。文章同时提醒读者保持清醒:ARC高分并不等同于实现通用人工智能,Chollet本人也多次强调这只是衡量某类抽象推理能力的工具。具体分数与技术方案尚未公开,读者可关注Kaggle官方排行榜获取后续信息。
ARC-AGI-2:衡量通用智能的新标尺
一条来自Twitter的简短动态引发了AI推理社区的关注——有参赛者宣布在Kaggle平台上的ARC-AGI-2测试已经取得了相当不错的成绩。虽然原始信息极为简短,但背后指向的是当前AI领域一个备受争议的核心命题:机器是否正在逼近真正的抽象推理能力。
ARC(Abstraction and Reasoning Corpus)由François Chollet提出,其设计初衷并非考察模型的记忆或模式匹配能力,而是衡量系统在面对全新任务时的泛化与推理表现。ARC-AGI-2作为升级版基准,进一步提高了难度门槛,刻意规避了大语言模型可以通过海量数据预训练"背答案"的捷径。
ARC基准测试的核心设计哲学来自Chollet于2019年发表的论文《On the Measure of Intelligence》。该论文将智能定义为"系统在接触尽可能少先验信息的情况下,高效获取新技能的能力"。每道ARC题目呈现为若干组输入-输出网格示例(通常3-5对),要求模型仅凭这几个样本归纳出变换规则,并将其应用于新输入。网格中的颜色、形状与空间关系构成一套类似儿童智力测验的视觉语言,人类受试者平均正确率可达85%以上,而主流大语言模型长期徘徊在20%以下。ARC-AGI-2在此基础上进一步收紧了规则:题目更强调组合式推理,需要同时运用多条规则才能得出答案,并且刻意减少了与训练数据可能重叠的模式,使"见过类似题型"的优势近乎归零。
为什么Kaggle上的分数提升值得关注
Kaggle作为全球最大的数据科学竞赛平台,长期承载着ARC系列挑战赛。参赛者在这里提交的解决方案需要在受限的算力与时间内,对从未见过的网格谜题给出正确答案。这种设定使得分数的提升具有特殊意义——它不太可能来自单纯的数据堆砌,而更可能反映出推理方法本身的进步。
一句"分数达到相当不错的水平"看似轻描淡写,但在ARC-AGI-2这个被公认为"难啃"的基准上,任何可见的进步都意味着参赛团队在程序合成、神经符号结合或测试时搜索等技术路线上找到了有效突破口。过去很长一段时间,即便是顶尖的通用模型,在这类任务上的表现也远低于人类基线。
技术路线的多元竞赛
当前冲击ARC基准的方法大致分为几类:一是基于程序合成的搜索方法,通过构造DSL(领域特定语言)来枚举可能的变换规则;二是借助大模型进行测试时推理与采样,让模型在推断阶段投入更多计算;三是将符号推理与神经网络相结合的混合架构。
Kaggle竞赛的魅力在于,它用统一的评测标准把这些路线放在同一赛道上比较。分数的攀升往往不是靠某一项技术的孤立突破,而是多种技巧的工程化整合——这也是为什么社区对每一次成绩刷新都格外敏感。
DSL(领域特定语言,Domain-Specific Language)方法是ARC竞赛中历史最悠久的技术路线之一。其基本思路是预先定义一套描述网格变换的原子操作(如旋转、镜像、颜色替换、对象复制等),然后将解题过程转化为在这套操作空间中的程序搜索问题。代表性工作如Michael Hodel的arc-dsl以及Simon Stelling等人开发的ARGA框架,均尝试用组合搜索或遗传算法在DSL空间中自动合成符合示例约束的程序。这类方法的优势在于解释性强、不依赖大规模参数,但面临搜索空间爆炸的挑战——当规则组合复杂度超过一定阈值时,枚举效率急剧下降。测试时推理方法(Test-Time Compute)则代表另一种思路:让大模型在推断阶段通过多次采样、自我评估与迭代修正来弥补单次推理的不足,本质上是用推断算力换取准确率。
距离"AGI"还有多远
需要保持清醒的是,ARC-AGI的命名容易引发误解。即使在该基准上取得高分,也不等同于实现了通用人工智能。Chollet本人多次强调,ARC只是衡量某一类抽象推理能力的工具,而非AGI的终极判定标准。
不过,持续的分数提升确实提供了一个有价值的信号:AI系统在处理需要即时归纳、无法依赖记忆的任务时,正在变得更有能力。这种进步比刷新传统NLP或图像基准更能触及"智能"的本质讨论。
由于本次消息来源信息有限,具体的分数数值、所采用的技术方案以及团队背景尚未公开披露。感兴趣的读者可持续关注Kaggle官方的ARC-AGI-2排行榜以获取权威数据。
相关推荐

2026年AI编程工具横评:Claude、ChatGPT、Gemini谁最强?
2026年五款主流AI编程工具横评:Claude Code、ChatGPT Codex、Gemini、DeepSeek和GitHub Copilot在真实项目、定价与代码质量上的全面对比,帮你决定每月20美元该花给谁。

ChatGPT Codex克隆任意软件?实测风险与真相
YouTube短视频宣称用ChatGPT Codex或Claude Code即可克隆Adobe、Excel、Figma等软件并终身免费使用。本文拆解其技术可行性、法律风险与私信引流套路,说明AI编程工具真正适合的用法。

Kilo Code免费安装但API收费:成本估算与配置指南
Kilo Code 开源 AI 编程代理安装免费,但接入的 AI 模型按 token 收费。本文详解 VS Code 扩展与 CLI 配置步骤,并用假设用量演示 API 成本估算方法,对比按量付费与订阅制的选择逻辑。