ARIVE:解剖引导推理,让AI生成的影像报告可追溯
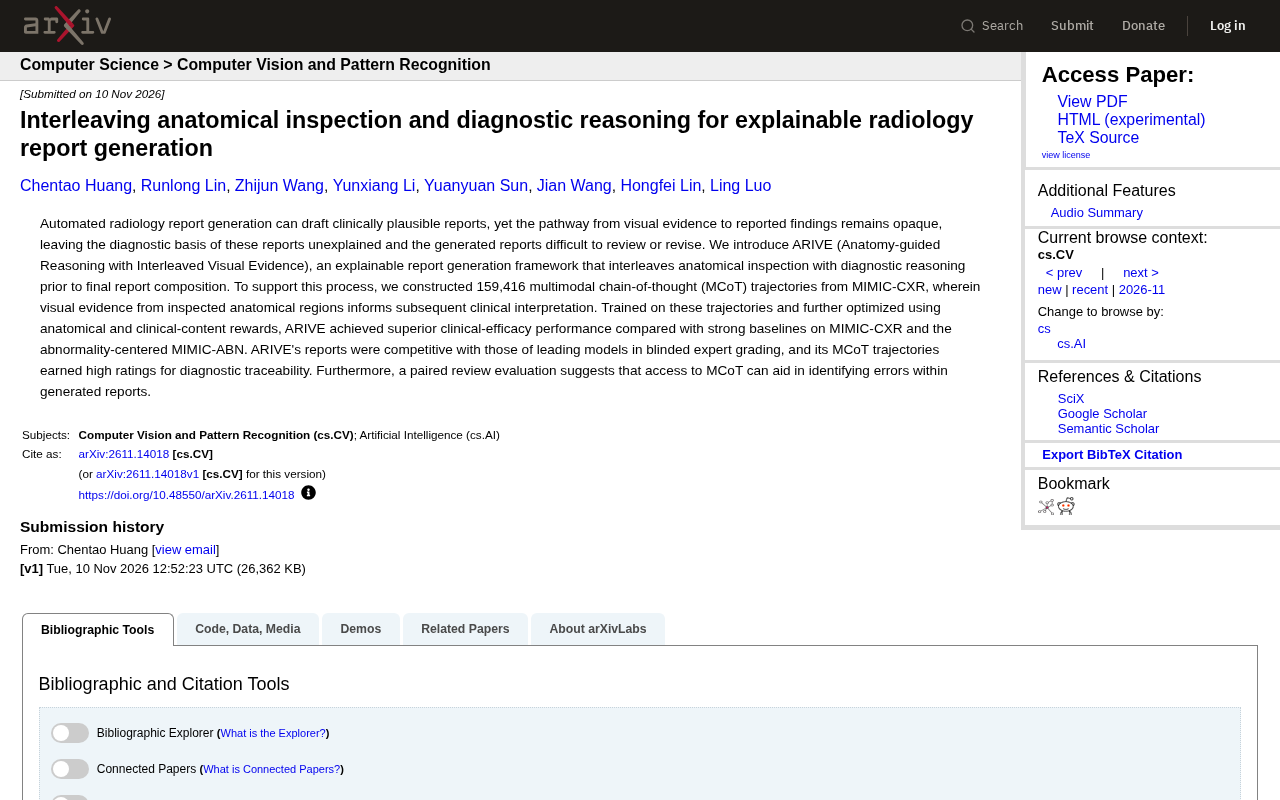
ARIVE 以解剖引导的交错视觉推理生成可追溯的放射学报告,提升临床有效性与错误审查效率。
ARIVE 框架针对放射学报告生成中推理黑箱的问题,提出将解剖区域检查与诊断推理交错进行的多模态思维链方法。研究基于 MIMIC-CXR 构建了 159,416 条包含视觉证据与临床解释的推理轨迹,并用解剖学与临床内容奖励优化模型。在 MIMIC-CXR 和 MIMIC-ABN 上,ARIVE 的临床有效性优于强基线,专家盲评显示其报告质量与领先模型竞争。配对审查评估进一步表明,访问多模态思维链能帮助评审者识别报告错误,使可解释性直接服务于质量控制。文章认为,该方法将可解释性内化为生成结构,但轨迹构建成本与真实临床场景的泛化仍是待解挑战。
自动生成放射学报告的技术已经能写出临床看似合理的文本,但从视觉证据到最终结论的推理路径却像一个黑箱——医生难以审查、修改,更无法判断报告的依据是否可靠。针对这一痛点,研究者提出了 ARIVE(Anatomy-guided Reasoning with Interleaved Visual Evidence)框架,将解剖区域检查与诊断推理交错进行,让报告生成过程变得可解释。
从“黑箱输出”到“交错推理”
传统报告生成模型通常直接输入影像、输出文本,中间缺少可验证的推理步骤。ARIVE 的核心思路是模拟放射科医生的实际工作流:先定位并检查特定解剖区域,基于视觉证据形成初步判断,再进入下一个区域的检查与推理,最终汇总成完整报告。这种“解剖检查—诊断推理”交错进行的多模态思维链(Multimodal Chain-of-Thought, MCoT),把每一步的视觉依据和临床解读显式记录下来。
为了训练这一过程,研究团队从 MIMIC-CXR 数据集中构建了 159,416 条多模态思维链轨迹,每条轨迹都包含被检查解剖区域的视觉证据及其对应的临床解释。模型在这些轨迹上训练,并进一步用解剖学奖励和临床内容奖励进行优化,促使推理步骤既符合解剖结构,又贴合临床意义。
多模态思维链(Multimodal Chain-of-Thought, MCoT) 是思维链(Chain-of-Thought)方法在多模态场景下的延伸。传统思维链主要针对纯文本任务,通过让模型显式生成中间推理步骤来提升复杂问题的求解能力与可解释性。MCoT 则要求模型在推理过程中同时引用视觉证据(如图像中的特定区域、病灶外观)和文本解释,形成“看—思—说”交替的序列。在医学影像报告中,MCoT 的每一步通常对应一个解剖区域的视觉检查及其临床解读,使最终结论可回溯到具体的图像证据。这种结构不仅便于人类审查,也为训练时的过程监督提供了粒度更细的信号。
临床有效性优于强基线
在 MIMIC-CXR 和以异常为中心的 MIMIC-ABN 两个数据集上,ARIVE 的临床有效性指标均优于强基线模型。这意味着它不仅报告写得更“像”,在关键临床信息的覆盖和准确性上也表现更好。
更值得关注的是专家盲评结果:ARIVE 生成的报告与领先模型的报告相比具有竞争力。同时,其多模态思维链轨迹在诊断可追溯性上获得了高评分——评审者能够沿着推理链回溯报告结论的来源。一项配对审查评估还显示,当评审者可以访问 MCoT 时,他们更容易识别生成报告中的错误。这一点对临床落地尤为重要:可解释性不只是为了“好看”,而是直接服务于报告的质量控制。
MIMIC-CXR 与 MIMIC-ABN 是放射学报告生成领域广泛使用的公开数据集。MIMIC-CXR 包含约 37 万张胸部 X 光片及对应的自由文本报告,来源于贝斯以色列女执事医疗中心,是当前规模最大的开放胸部影像-报告配对资源之一。MIMIC-ABN 则是从 MIMIC-CXR 中筛选出的以异常为中心的子集,聚焦于有明确病理发现的病例,常用于评估模型对异常征象的捕捉能力。由于报告文本由放射科医生撰写,这两个数据集既提供了真实的临床语言分布,也保留了报告中的噪声与不完整性,因此在该数据集上的指标提升通常被视为方法有效性的重要参考,但也需注意其单中心来源带来的泛化局限。
可解释性如何辅助错误审查
放射科报告的错误往往隐藏在对某一解剖区域的误读或漏读中。ARIVE 将每个诊断结论与具体的视觉检查步骤关联,评审者可以快速定位是哪个区域的证据支持不足,或者推理跳跃过大。配对审查评估表明,这种追溯能力能帮助评审者发现错误,而不是仅仅依赖最终文本的流畅度来判断可靠性。
从应用角度看,这一框架为 AI 辅助报告系统提供了新的交互可能:医生不再只是接受或拒绝一段文本,而是可以审查推理链、修正特定步骤,从而提升对系统的信任度。当然,MCoT 轨迹的生成和标注成本较高,如何扩展到更多模态和更广泛的异常类型,仍是后续需要探索的方向。
配对审查评估(paired review evaluation) 是一种用于衡量可解释性实际效用的实验设计:评审者同时查看模型输出及其解释性信息(如推理链),并与无解释条件下的审查结果进行配对比较。在放射学报告场景中,这种设计可以量化“访问 MCoT 是否真的帮助评审者更快、更准地发现错误”,而非仅仅主观评价解释是否“看起来合理”。配对设计控制了评审者个体差异和病例难度,使结论更具统计效力。该评估范式源于可解释 AI 领域对“解释有用性”的实证检验需求,强调解释应服务于真实的下游任务(如错误检测、质量控制),而不仅是模型内部的副产品。
编辑观点
ARIVE 的价值在于把“可解释”从附加属性变成了生成过程的内生结构。交错推理让视觉证据与临床结论之间的映射变得显式,这既有利于模型优化,也为临床审查提供了抓手。不过,当前评估仍集中在 MIMIC 系列数据集上,真实临床场景中的多样性和噪声水平可能带来新的挑战。此外,思维链轨迹的质量高度依赖构建方式,如何保证其临床忠实度而非仅仅“看起来合理”,是这类方法共同面对的问题。
相关推荐

智能体与工作流:LangGraph 工作流编排的核心概念解析
基于B站老肖的LangGraph教程,解析工作流与智能体的本质区别:编排权归属、复杂业务选型、StateGraph三大组件及构建流程,帮助开发者合理选择架构方案。
LangGraph工作流与智能体:企业级AI编排新解
LangGraph工作流与智能体的核心区别是什么?本文解析状态图三要素(状态、节点、边),探讨工作流如何编排复杂AI业务,以及LangChain 1.0企业级应用中的协同策略。

4个习惯正在偷走你的Claude Code额度(附诊断提示词)
Claude Code额度消耗过快?本文拆解4个常见烧额度习惯:模糊需求、冗长日志、随意开子代理、长会话不切换。附一个能扫描最近七天日志、自动找出你个人耗电前三名的提示词,并给出针对性修正规则。