Armin Ronacher 锐评 AI:三十年烂软件,如今自食其果

Ronacher 讽刺 AI 正把三十年烂软件的技术债放大成安全风险。
文章围绕 Flask 作者 Armin Ronacher 的一句辛辣评论展开:过去三十年我们写下了太多糟糕的软件,如今 AI 正在替宇宙惩罚我们。作者指出,这句话点中了 AI 与安全领域最尴尬的现实——大模型并未创造漏洞,而是让长期被忽视的输入校验缺失、权限边界模糊、依赖版本随意锁定等问题变得可被自动化发现和利用。文章进一步分析该评论被 Simon Willison 归入 AI 安全语境的合理性:提示注入与 Web 历史上的输入信任问题同构。最后给出开发者层面的应对方向,即修补代码卫生、依赖供应链与开发心态,而非仅仅给模型加护栏。
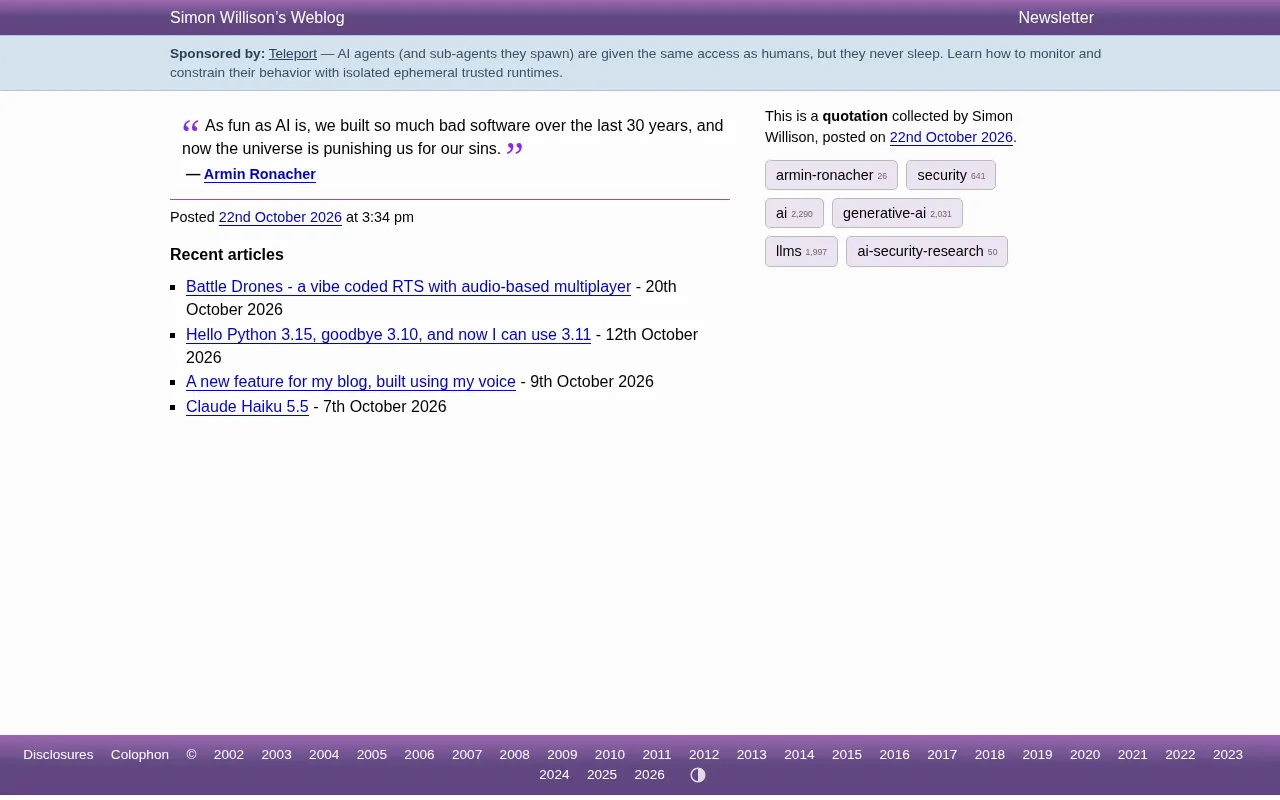
Flask 框架作者、知名开发者 Armin Ronacher 在 Twitter 上发了一句颇为辛辣的感慨,被 Simon Willison 的博客引用后引发了不小的讨论。
As fun as AI is, we built so much bad software over the last 30 years, and now the universe is punishing us for our sins.
翻译过来大致是:AI 固然好玩,但过去三十年我们写下了太多糟糕的软件,如今宇宙正在惩罚我们的罪孽。
这句话看似一句玩笑,却精准点中了当下 AI 与安全领域最尴尬的现实——大模型的能力,正在把软件工程长期积累的技术债,成倍地放大成安全风险。
一句话背后的真问题
Ronacher 的措辞带有调侃色彩,但它指向的并不是"AI 不好用",而是一个更底层的因果关系:AI 之所以能在今天制造出如此多的安全问题,前提是它所面对的系统本身就已经千疮百孔。
过去三十年的软件开发史,是一部持续妥协的历史。为了赶工期,输入校验被省略;为了兼容旧系统,权限边界被模糊;为了快速迭代,依赖库的版本被随意锁定。这些做法在单机时代或封闭网络中还勉强可控,但当 LLM 具备了自动阅读代码、生成请求、组合工具调用的能力之后,任何一个被忽视的边缘情况都可能成为攻击链的起点。
换句话说,AI 并没有"创造"漏洞,它只是让原本沉睡的漏洞变得可被自动化地发现和利用。
为什么这句话出现在 AI 安全语境里
Simon Willison 给这条引用打上的标签包括 security、generative-ai、ai-security-research 和 llms,这个标签组合本身就说明了问题被放置的语境。
当前的 AI 安全研究,很大一部分精力花在了"模型会不会被诱导做坏事"上,但 Ronacher 的视角不同:他关注的是模型所操作的那一层软件基础设施。提示注入之所以难以根治,本质上是因为模型无法可靠区分"指令"和"数据",而这个缺陷恰好与 Web 应用中长期存在的输入信任问题同构。SQL 注入教给我们的教训,在 LLM 时代以新的形式重演了一遍。
据 Simon Willison 博客的引用和标签归类,这条评论被归入 AI 安全研究讨论,说明社区中已有不少人认同这一判断:AI 安全不是一个孤立的新问题,它是软件安全旧账的一次集中清算。
提示注入(Prompt Injection) 是指攻击者在 LLM 的输入中嵌入恶意指令,诱导模型偏离原本任务、执行攻击者意图的行为。它与传统注入攻击的关键相似点在于:系统无法可靠区分「可信指令」与「不可信数据」。在 Web 安全中,SQL 注入的根治方案是参数化查询——把代码与数据在语法层面彻底分离;而 LLM 目前缺乏类似的结构性隔离机制,模型对上下文中的所有文本一视同仁。这使得任何能被模型读取的内容(网页、文档、邮件、工具返回值)都可能成为攻击载体,也让「给模型加一句安全提示」这类缓解措施天然脆弱。理解这一同构关系,是理解 Ronacher 那句评论为何被归入 AI 安全研究的前提。
对开发者的现实含义
如果接受 Ronacher 的框架,那么应对 AI 带来的安全挑战,就不能只靠给模型加护栏。
第一层是代码层面的卫生。那些被搁置多年的输入校验、权限检查、错误处理,在 AI 代理可以自动调用接口的环境下,需要被重新审视。一个在人工操作下"基本不会触发"的分支,对一个不知疲倦的自动化代理来说可能只是常规路径。
第二层是依赖与供应链。LLM 工具链往往引入大量第三方包和远程服务,Ronacher 所说的"三十年烂软件",在依赖树里体现得尤为明显——你继承的不只是代码,还有别人三十年的妥协。
第三层是心态。把 AI 安全问题视为"AI 的锅",容易让人忽略真正可行动的改进点。Ronacher 的"惩罚"一说虽然戏谑,但方向是清楚的:修补的对象是软件本身,而不是抱怨工具太聪明。
AI 代理(AI Agent) 与普通聊天式调用大模型的区别在于:它会自主规划多步操作、调用外部工具与 API、读取执行结果并据此调整下一步行动。这一特性把软件缺陷的暴露面显著放大——人工使用时几乎不会走到的异常分支,代理可能在一次任务中反复触发;原本依赖「用户不会这么操作」的隐式假设,在自动化面前全部失效。更关键的是,代理通常持有一定范围的凭证与权限,一旦被提示注入劫持,攻击者获得的不是一次回答,而是一段可执行的操作链。这也是文章强调「输入校验、权限检查需重新审视」的技术背景:面向人类操作者设计的防护假设,需要按机器速度与机器耐心重新评估。
一句话的传播力
这条引用之所以被单独摘出来,恰恰因为它用极短的篇幅完成了一次视角切换——从"AI 能做什么"转向"我们给它准备了一个什么样的世界"。对于长期与代码打交道的开发者来说,这种自嘲式的表达比长篇安全报告更容易引发共鸣,也更容易被记住。
它不提供解决方案,但提供了一个值得反复回看的提问方式:当 AI 开始替我们操作软件时,我们是否愿意先回头看看那些年欠下的技术债。
相关推荐

Hermes Agent零基础实战:自进化AI助手
Hermes Agent 零基础教程:GitHub 41.7K 星的自进化 AI Agent 怎么装怎么用。本文拆解其学习循环、三层记忆与 Skill 自改进机制,对比 Claude Code 和 OpenClaw 的差异,并附 WSL 安装实操步骤。

RAG面试核心:离线建库与在线检索全流程拆解
拆解RAG检索增强生成的完整工作流程:离线阶段文档加载、切割、向量化、入库,在线阶段问题改写、向量检索、重排、生成,并解析RAG面试核心考点与系统优化方向。

AI大模型零基础入门:原理与API调用实战指南
从AI发展脉络到大模型训练原理,再到Token、Temperature、Top-P等核心概念,本文结合实战课程讲解系统提示词、Function Call、RAG与记忆能力的实现逻辑,并给出四类API调用场景的落地路径,适合零基础开发者入门。