Astra对决Fable:Reddit社区深度评测谁更强

Reddit社区对比AI模型Astra与Fable 5.1,前者在能力、额度和语言自然度上获压倒性好评,但也伴随着水军营销的质疑。
Reddit上一场关于AI模型"Fable vs. Astra"的讨论(两者分别对应主流厂商旗舰产品)在50余条评论后形成明显共识:Astra在规划实现、空间推理、程序化生成等多个维度全面领先,且使用额度更为宽松。用户还高度评价Astra摆脱了Claude系列模型固化的表达习惯,交互自然度显著提升。讨论中最具冲击力的案例是Astra发现了Fable此前辅助撰写的科学论文存在缺陷,但社区也对过度依赖AI处理学术工作的风险保持了清醒认知。另一方面,好评的高度一致性引发了"水军营销"的质疑,部分用户倾向于将两个模型结合使用——以一个规划、另一个验证——而非非此即彼。整体结论是:炒作与怀疑并存,综合评估模型的效率、额度和交互体验比单纯比拼"聪明程度"更具实际意义。
在AI模型竞争日益白热化的当下,Reddit社区一场关于"Fable vs. Astra"的讨论引发了广泛关注。经过50多条评论的激烈交锋,社区舆论呈现出明显倾向——Astra被认为相较于Fable 5.1实现了显著飞跃。本文将梳理这场讨论中的核心观点、真实用户反馈以及不容忽视的质疑声音。
注:Fable 与 Astra 为社区讨论中使用的模型代称,分别对应主流厂商的旗舰产品。
社区共识:Astra在多个维度全面领先
从讨论的整体走向看,Astra获得了压倒性的好评。用户普遍认为它"更聪明、更直观、效率更高",常常能用一次提示(prompt)完成Fable需要多轮修正才能实现的任务。这种效率上的差异,对于依赖AI进行复杂工作流的用户而言,意味着实实在在的生产力提升。
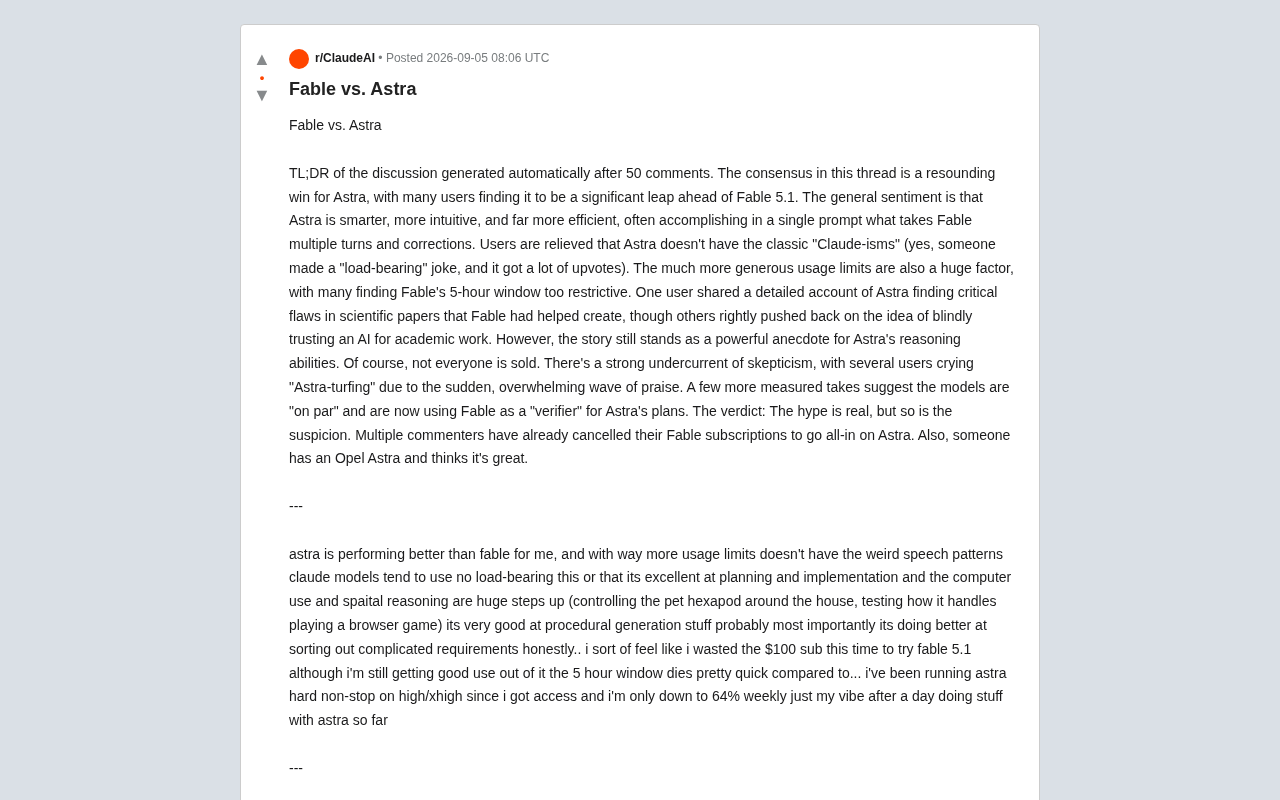
一位深度使用者分享了他的直观体验:Astra在规划与实现(planning and implementation)方面表现出色,而更令人印象深刻的是其在计算机操作与空间推理上的巨大进步。他甚至用Astra控制一只宠物六足机器人在房间里移动,并测试它玩浏览器游戏的表现。此外,Astra在**程序化生成(procedural generation)**任务上也颇为擅长。
最关键的一点在于,用户认为Astra"在梳理复杂需求方面做得更好"。这正是当前大模型应用中最具挑战性的环节之一——理解模糊、多层次的用户意图,并转化为可执行的方案。
告别"Claude式表达":语言自然度的显著提升
讨论中一个有趣的高频吐槽点,是Astra摆脱了所谓的"Claude-isms"。有用户特别提到,Astra不再频繁使用Claude模型那种独特的措辞习惯——比如反复出现的"load-bearing(承重的)"这类表达。
这一话题甚至衍生出社区玩梗:"You have found the gap, it is a load-bearing one(你发现了这个缝隙,它是承重的)",收获了大量点赞。这种玩笑背后反映了一个真实的用户痛点:模型固化的表达模式会让交互显得机械、缺乏灵活性。Astra在语言自然度上的改进,客观上提升了用户体验的舒适感。
使用额度对比:决定实用性的关键因素
除了能力本身,**使用额度(usage limits)**是这场对比中的另一决定性因素。多位用户抱怨Fable的"5小时窗口"限制过于严苛,很快就会用尽。相比之下,Astra的额度慷慨得多。
一位用户提供了具体数据:他自获得访问权限后就"一直在high/xhigh档位高强度运行Astra",一整天下来周额度仅消耗到64%。这一细节颇具说服力——对于重度用户来说,额度的宽松程度直接决定了模型的实用性上限。
有评论一针见血地指出行业内的"额度虚标"问题:"某些标称20x的套餐从来都不是真正的20x,更接近5x。"这提醒我们,评估AI服务时不能只看纸面参数,实际可用量才是硬道理。
AI发现科学论文缺陷:推理能力的有力佐证
讨论中最具冲击力的一则案例,是一位用户描述Astra发现了科学论文中的关键缺陷——而这些论文恰恰是Fable此前帮助撰写的。这个故事被视为Astra推理能力的有力佐证。
不过,社区也保持了应有的理性。有用户明确反对"盲目信任AI处理学术工作"的做法,原帖作者也认同这一批评:"你这么反驳是对的。"这种自我修正的讨论氛围,恰恰体现了社区的成熟——即便对某个模型抱有好感,也不放弃对AI局限性的清醒认知。
无论如何,这个案例作为展示Astra推理深度的"强力轶事"依然成立。它暗示了新一代模型在批判性分析和错误检测上的潜力。
质疑的暗流:好评来得太一致反而可疑
并非所有人都被说服。讨论中存在一股强烈的怀疑情绪,几位用户直言这是"Astra-turfing(Astra水军营销)"——因为这波好评来得如此突然、如此一边倒,反而显得可疑。
更为审慎的观点认为,两个模型其实"势均力敌(on par)"。有意思的是,部分用户已经开始将Fable用作Astra方案的"验证器(verifier)"——让一个模型规划,另一个模型审核。这种多模型协作的用法,或许才是当前AI工具链的务实方向:不必非此即彼,而是让不同模型各展所长、互相制衡。
结语:炒作与怀疑并存,理性选择是关键
这场讨论的最终裁决颇为微妙:炒作是真实的,但怀疑同样真实。 已有多位评论者取消了Fable订阅,全面转向Astra;也有人保持观望,认为热度背后需要更多时间验证。
对于AI从业者和普通用户而言,这场对比提供了几点重要启示:
- 模型能力的比拼已从单纯的"聪明程度"延伸到效率、额度、交互自然度等综合体验;
- 空间推理、计算机操作等"具身智能"方向正成为新的竞争焦点;
- 面对社区的一致好评,保持独立判断永远是明智之举。
当然,讨论最后还有个温馨插曲——有人表示自己开的是一辆欧宝Astra(Opel Astra)汽车,并觉得它很不错。在严肃的技术辩论之余,这份幽默为社区讨论增添了一丝人情味。
相关推荐

腾讯WorkBuddy实测:AI Agent如何碾压传统聊天助手
腾讯WorkBuddy实测对比豆包:AI Agent如何直接操作电脑完成PPT转PDF、文件归档等任务。从安装门槛、国内生态、价格、插件市场四方面分析WorkBuddy优势,并给出AI Agent选择建议。

奥特曼称个人PC囤RAM“相当糟糕”,数据中心利用率更高
OpenAI CEO萨姆·奥特曼在Reddit引发热议的表态中称,个人PC配备大量RAM是“相当糟糕”的资源利用方式,数据中心凭借集中调度能实现更高内存利用率。本文解析这一观点背后的技术逻辑与行业信号。

付费5美元教AI说话:一场关于AI训练本质的社会实验
一位开发者搭建了运行真实语言模型的「假AI实验室」,用户支付5美元即可教模型一句话。这个社会实验揭示了AI训练中数据成本、用户参与和话语权的深层关系。