Athena:让AI智能体学会遗忘的三层记忆系统
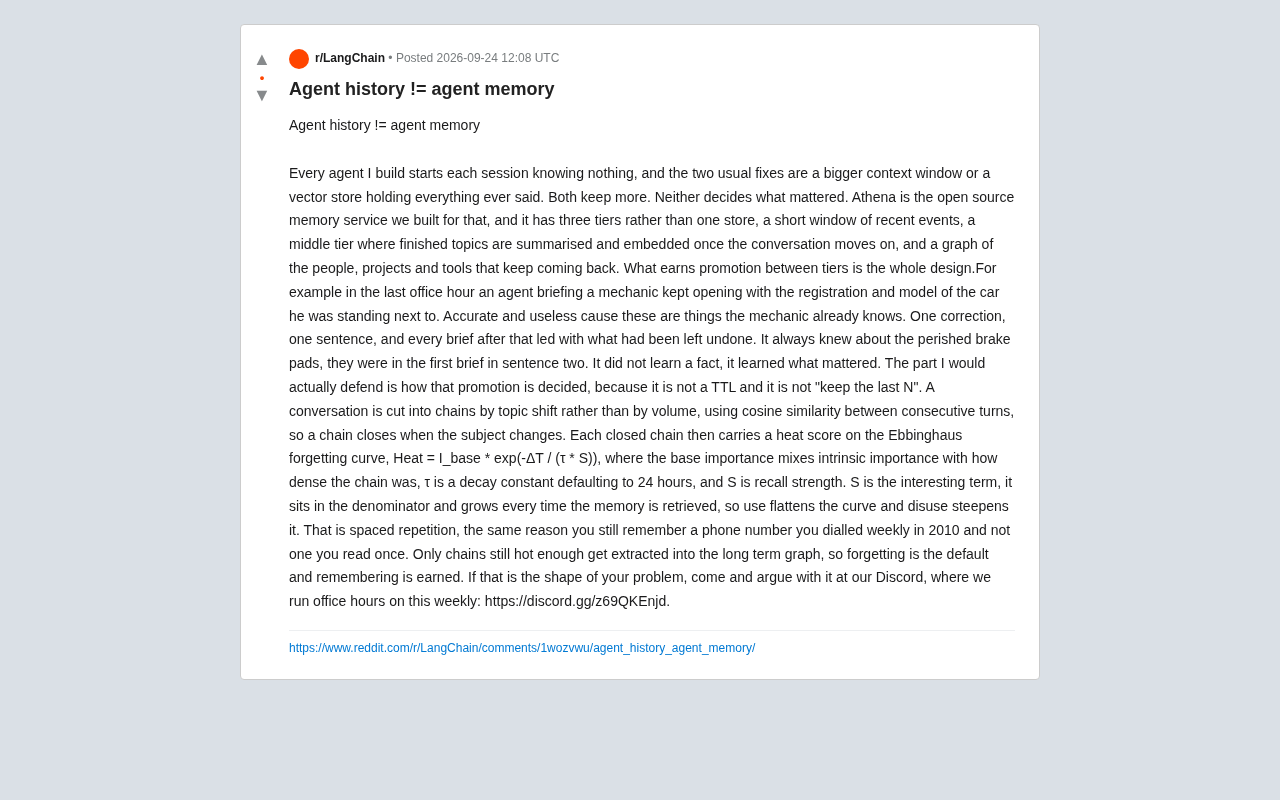
Athena用艾宾浩斯遗忘曲线与话题切链机制,让AI智能体学会「主动遗忘」而非无差别堆积记忆。
AI智能体的常见记忆方案——扩大上下文窗口或向量数据库全量存储——回避了「什么信息才重要」这一根本问题。开源服务Athena提出三层记忆结构(短期窗口、中间总结层、长期图谱),并以余弦相似度按话题切链、用艾宾浩斯遗忘曲线公式为每段记忆打热度分,频繁被检索的记忆热度衰减慢、得以晋升进长期图谱,长期弃用的则自然淡出。其核心洞察是:遗忘应是默认状态,记住需要通过重复使用来争取。汽车维修师傅的例子清晰说明了这一点——智能体学到的不是新事实,而是「什么才重要」的判断。这一方向对需要长期服务固定用户的智能体应用具有较强的参考价值。
智能体的历史记录不等于记忆
每一个AI智能体在新会话开始时几乎都是一张白纸——它对过去发生的事一无所知。开发者常见的两种补救方案,要么是扩大上下文窗口,要么是搭一个向量数据库把说过的每句话都塞进去。这两种做法的共同点是「留下更多」,但它们都回避了一个更本质的问题:什么才是真正重要的。
一位Reddit开发者分享了他们的开源记忆服务Athena,正是为解决这个痛点而生。它的核心理念很直接:记忆不该是无差别的堆积,而应该像人类大脑一样,主动决定哪些信息值得被记住,哪些可以被遗忘。
三层记忆结构:从短期窗口到长期图谱
Athena没有采用单一存储,而是设计了三个层级:
- 短期窗口:保存最近发生的事件,相当于工作记忆;
- 中间层:当对话转向新话题后,已经结束的旧话题会被总结并一次性嵌入(embed);
- 长期图谱:记录反复出现的人物、项目和工具,形成一张持续演化的关系网络。
关键不在于分了几层,而在于信息如何在层级之间「晋升」。这套晋升机制才是整个设计的灵魂。
一个真实的例子:修车师傅的简报
作者举了一个在近期office hour里出现的例子,很能说明问题。一个智能体在给汽车维修师傅做简报时,每次都以「车辆的牌照和型号」开头。这些信息准确无误,却毫无价值——因为师傅正站在车旁边,这些他早就知道。
经过一句话的纠正后,之后的每份简报都改为以「还没处理完的事项」开头。有意思的是,它并非新学到了「刹车片老化」这个事实——这条信息一直都在第一份简报的第二句里。它学到的是什么才重要(what mattered),而不是多记住了一个事实。这正是记忆与历史记录的本质区别。
晋升机制:既不是TTL,也不是保留最近N条
作者最愿意为之辩护的,正是这套晋升决策逻辑。它拒绝了两种主流做法:既不用TTL(存活时间)来定期清理,也不用「保留最近N条」这种简单粗暴的窗口。
按话题切分,而非按数量切分
一段对话会根据话题转移被切分成若干「链」(chain),而不是按体量硬切。具体做法是计算相邻对话轮次之间的余弦相似度——当主题发生变化时,相似度下降,一条链就此闭合。这让记忆的边界更符合语义的自然分段。
余弦相似度是衡量两段文本在向量空间中方向差异的指标,取值范围为−1到1,越接近1代表语义越相近。在实际实现中,系统会将每一轮对话编码为高维向量(通常通过嵌入模型完成),再计算相邻轮次向量之间夹角的余弦值。当连续几轮对话围绕同一主题时,向量方向保持相近,余弦值维持高位;一旦用户话题跳转——例如从讨论代码架构转向询问上线时间——向量方向偏转,余弦值骤降并触发链的闭合。这种方式比简单的关键词匹配更能捕捉语义层面的「话题边界」,但也依赖嵌入模型本身的质量,主题转变若发生得过于渐进,边界识别可能出现偏差。
用遗忘曲线给记忆打「热度分」
每条闭合的链都会带上一个基于艾宾浩斯遗忘曲线的热度分数:
Heat = I_base * exp(-ΔT / (τ * S))
其中各项含义为:
- I_base(基础重要性):混合了内在重要性与这条链的信息密度;
- τ(衰减常数):默认24小时;
- S(回忆强度):这是最精妙的一项。
S位于分母,每当这段记忆被检索一次,S就增长一分。这意味着频繁使用会拉平遗忘曲线,长期弃用则让曲线变陡。这正是间隔重复(spaced repetition)的原理——就像你至今还记得2010年每周都要拨的那个电话号码,却记不住只看过一眼的号码。
只有热度仍然足够高的链,才会被提取进长期图谱。换句话说,遗忘是默认状态,记住是需要争取的。
间隔重复(Spaced Repetition)是认知心理学中的一项记忆强化技术,其核心发现是:在记忆即将消退之前进行复习,所需的复习次数最少,记忆留存效果却最好。商业应用中最典型的例子是Anki等间隔重复闪卡工具,它会根据用户的上次复习时间和历史准确率,动态调度下一次复习的最佳时间点。Athena将这一机制反向移植进智能体系统:每次检索相当于一次「复习」,S值的增长拉平了遗忘曲线,让该记忆在更长的时间跨度内保持足够的热度。这意味着系统的记忆并非静态的数据库,而是一个随使用模式持续调整权重的动态结构——经常被调用的上下文自然浮出水面,从未被提及的信息则逐渐沉底消失。
为什么这个思路值得关注
当前主流的智能体记忆方案,本质上都在与「存储成本」和「检索精度」做权衡,却很少直面「取舍」这个认知层面的问题。Athena把人类记忆的经济学——用进废退、语义分块、主动遗忘——搬进了工程实现,这是一个有价值的方向转变。
对于长期运行、需要持续服务同一用户或团队的智能体来说,无差别的记忆堆积不仅昂贵,还会让检索被无关噪声淹没。一个懂得遗忘的系统,反而可能给出更相关、更有用的输出——正如那位修车师傅的例子所展示的。
需要说明的是,以上内容来自单一开发者在Reddit上的分享,具体效果和适用边界仍有待更多实践验证。作者也开放了Discord社区,每周举办office hour来讨论这套设计。感兴趣的开发者可以去实际验证和质疑这些设计选择。
相关推荐
jev-seo:免费开源的 Rust CLI SEO/GEO 审计工具
jev-seo 是一款免费开源的 Rust CLI SEO/GEO 审计工具,无需订阅即可完成站点抓取、meta 标签检查、schema 校验、robots 与 sitemap 检查,还支持 GEO/AI 引用评分和 MCP 服务器,可被 AI 编程代理调用,是 Semrush、Ahrefs 的低成本替代方案。
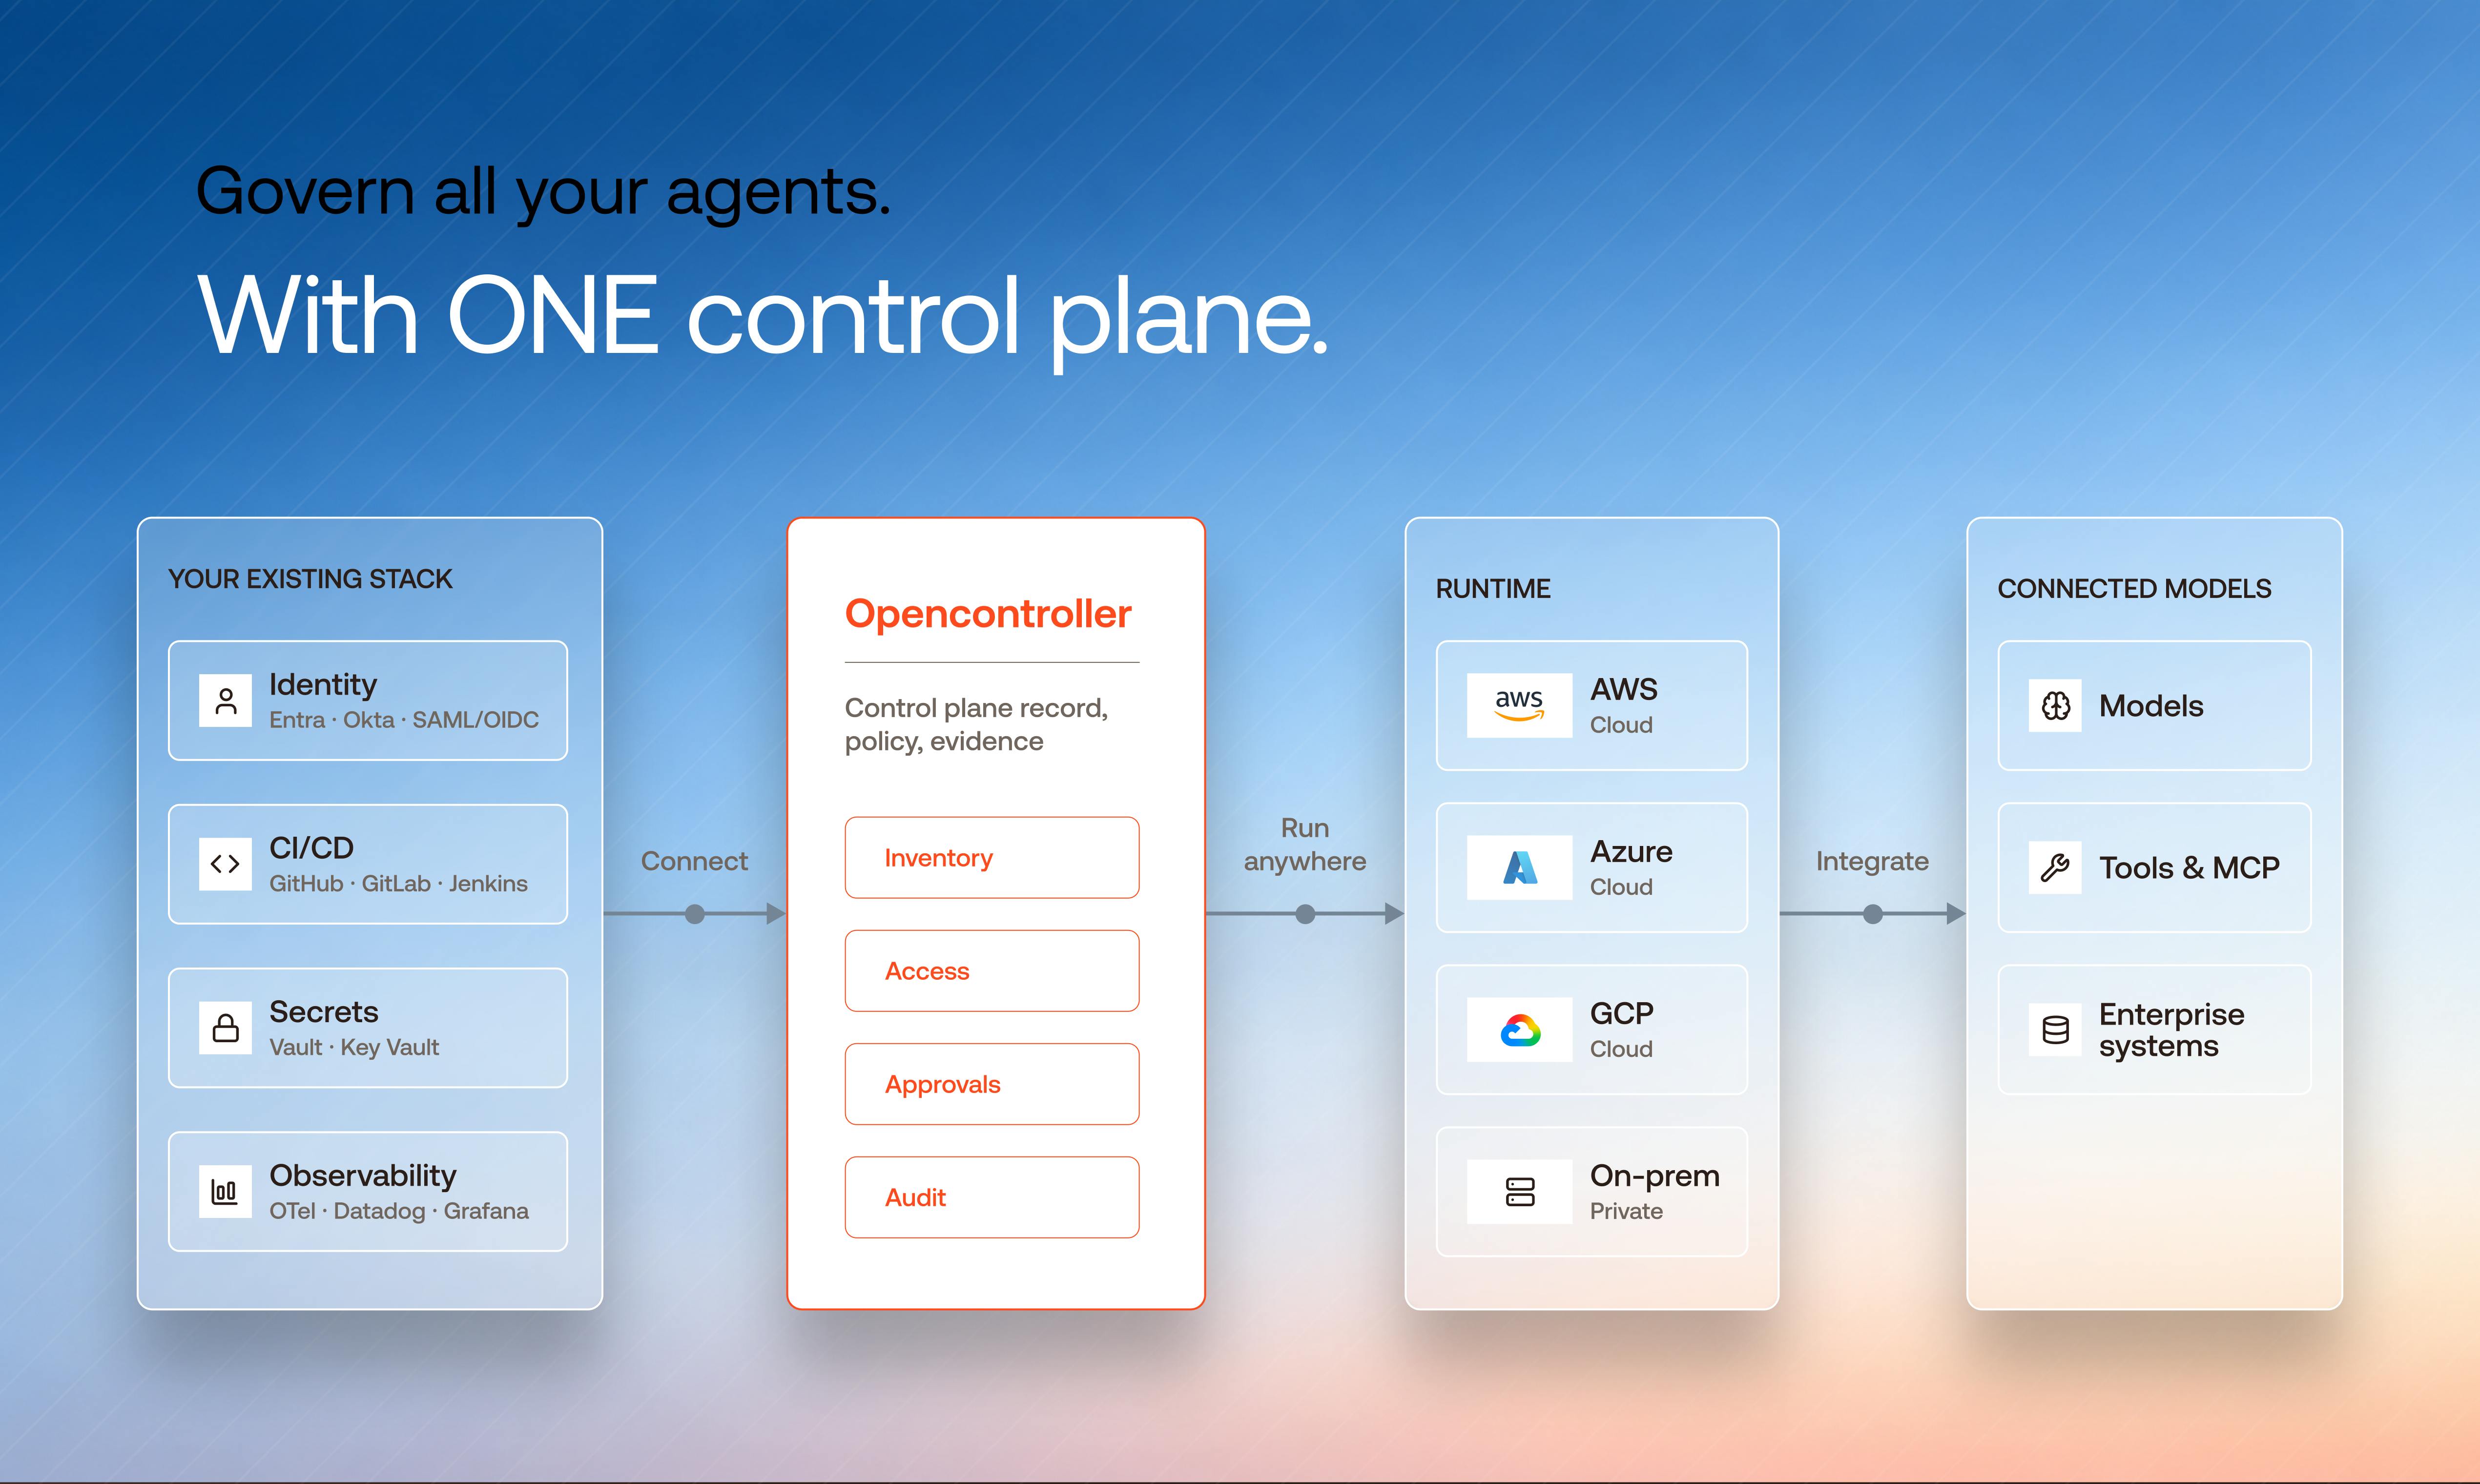
OpenController:统一控制平面治理所有AI Agent
OpenController by Lyzr是一个统一控制平面,用于治理企业内所有AI Agent、模型和工作流。它支持自动发现、安全交付、实时监控,并能在请求路径中直接拦截违规调用,部署于企业自有集群,实现真正的内联式Agent治理。
Gemini 3.8 TTS发布:定制角色语音与场景对话直达全线Google工具
谷歌发布Gemini 3.8 Flash TTS与Flash-Lite TTS两款文本转语音模型,支持定制角色语音和场景对话,全面接入Google AI Studio、Gemini API、Enterprise、Notebook和Vids。解析双模型定位与全线整合策略。