Atlas世界模型解析:下一视角预测如何统一生成与重建
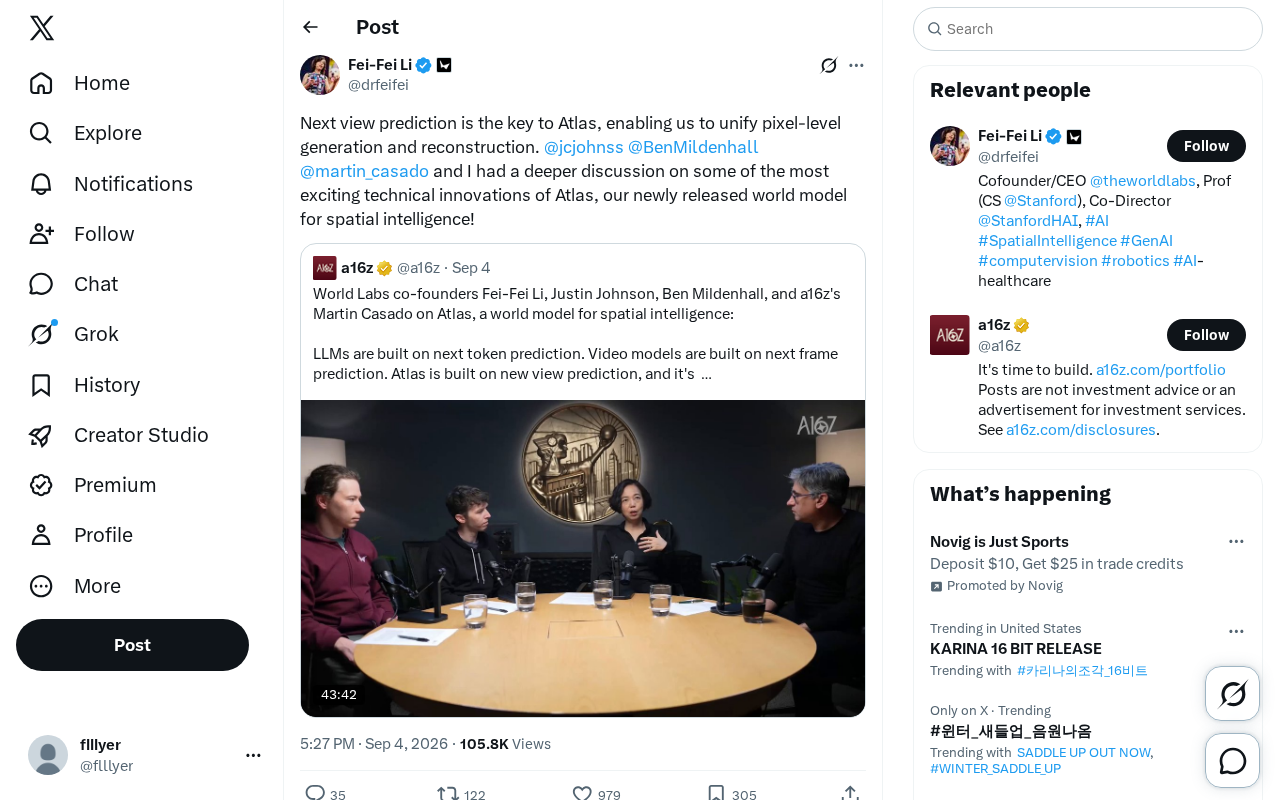
Atlas世界模型以"下一视角预测"为核心,将三维场景的像素级生成与重建统一于同一框架。
Atlas是一个面向空间智能的世界模型,其核心创新在于将"下一视角预测"作为统一的训练目标,同时覆盖像素级生成与重建两大任务。传统三维视觉中,生成与重建通常由两套独立机制处理;Atlas则类比语言模型的"下一token预测"范式,将二者归结为同一问题:在已有视觉上下文下预测下一视角的像素内容。这种统一使模型能够在一个连续能力谱系上工作——观测充分时偏向精确重建,观测稀疏时调用生成先验补全场景。该设计契合真实智能体永远面对不完整观测的现实,同时降低了工程复杂度。目前相关信息主要来自团队成员的公开讨论,完整技术论文尚未发布。
Atlas世界模型的核心:下一视角预测
空间智能(Spatial Intelligence)正在成为AI研究的重要前沿方向。近期发布的Atlas世界模型提出了一个颇具启发性的技术思路——将"下一视角预测"(Next View Prediction)作为整个模型架构的核心枢纽,从而在同一个框架内统一像素级生成(generation)与重建(reconstruction)两大任务。
据参与研发的团队成员(包括 @jcjohnss、@BenMildenhall、@martin_casado 等)的公开讨论,这一设计理念被视为Atlas最令人兴奋的技术创新之一。本文将基于这些公开信息,梳理该思路背后的意义与潜在价值。
为什么"下一视角预测"是关键
在传统的三维视觉与图形学中,生成与重建往往被当作两类独立的问题来处理。重建关注的是从已有观测数据中还原出场景的几何与外观结构;而生成则强调从潜在表示或先验知识中"创造"出新的画面内容。二者在方法论和模型结构上通常存在明显割裂。
Atlas的做法是将这两类任务都归结为对"下一个视角"的预测问题。换言之,无论是补全一个尚未被观测到的角度,还是重建一个已知视角下的细节,本质上都可以被建模为"在给定已有视觉上下文的前提下,预测下一帧/下一视角应当呈现的像素内容"。
这种统一带来的直接好处是:模型不再需要为生成和重建分别设计两套机制,而是共享同一套底层表示与预测能力。这与近年来在语言与多模态领域盛行的"下一个token预测"范式有异曲同工之处——用一个简洁而通用的预测目标,撬动多种下游能力。
统一生成与重建的技术意义
将像素级生成与重建纳入同一框架,意味着Atlas可以在一个连续的能力谱系上工作:当输入观测充分时,模型偏向精确重建;当观测稀疏或缺失时,模型则调用其生成先验来"想象"出合理的视觉内容。
这种连续性对于空间智能尤为重要。真实世界中的智能体(无论是机器人还是虚拟代理)几乎永远无法获得对环境的完整观测,它们必须在"看到的"与"没看到的"之间不断做出推断。一个能够同时胜任重建与生成的世界模型,恰恰契合了这种需求——它既能忠实还原可见部分,又能对不可见部分给出合乎物理与语义常识的补全。
从工程角度看,统一的架构也降低了系统复杂度。开发者不必维护多个专用模型,也更容易实现能力之间的迁移与协同。
世界模型与空间智能的走向
Atlas被定位为面向空间智能的世界模型,这一定位本身反映了当前AI研究的一个趋势:从对二维图像和文本的理解,逐步走向对三维空间、几何结构与动态场景的建模。
世界模型的价值在于,它试图让AI系统建立起对物理世界运作规律的内部表征,从而支持预测、规划与推理。而"下一视角预测"作为训练目标,天然地迫使模型学习空间一致性、视角变换关系以及场景的隐含结构——这些正是空间智能所依赖的核心能力。
需要说明的是,目前公开的信息主要来自团队成员在社交平台上的讨论,尚缺乏完整的技术论文细节来支撑更深入的评估。因此本文所述更多是对其设计理念的解读,而非对具体性能的定论。
值得关注的后续问题
围绕Atlas这类以下一视角预测为核心的世界模型,有几个问题值得持续跟踪:其一,在极端稀疏观测条件下,生成与重建之间的平衡如何被自动调节;其二,这种统一框架在计算效率和可扩展性上的表现;其三,模型学到的空间表征能否有效迁移到机器人控制、导航等下游任务。
随着更多技术细节的披露,我们将能更清晰地判断Atlas在世界模型赛道中的实际位置。就目前而言,"用下一视角预测统一生成与重建"这一思路,无疑为空间智能的建模提供了一个简洁而富有想象力的方向。
相关推荐

Medicare 花5万治心梗,花100防心梗:医疗体系的错位
Medicare 为一次心梗治疗支付约5万美元,却不愿花100美元预防。本文解读 MedPage Today 观点文章及 Hacker News 热议,分析医疗支付体系为何偏向治疗而非预防,以及激励错配的深层原因。

英伟达或为Nscale西弗吉尼亚AI数据中心贷款联署担保
英伟达正考虑为Nscale在西弗吉尼亚州的AI数据中心贷款提供联署担保。本文分析芯片厂商介入数据中心融资的信号意义、风险分担逻辑及项目不确定性。
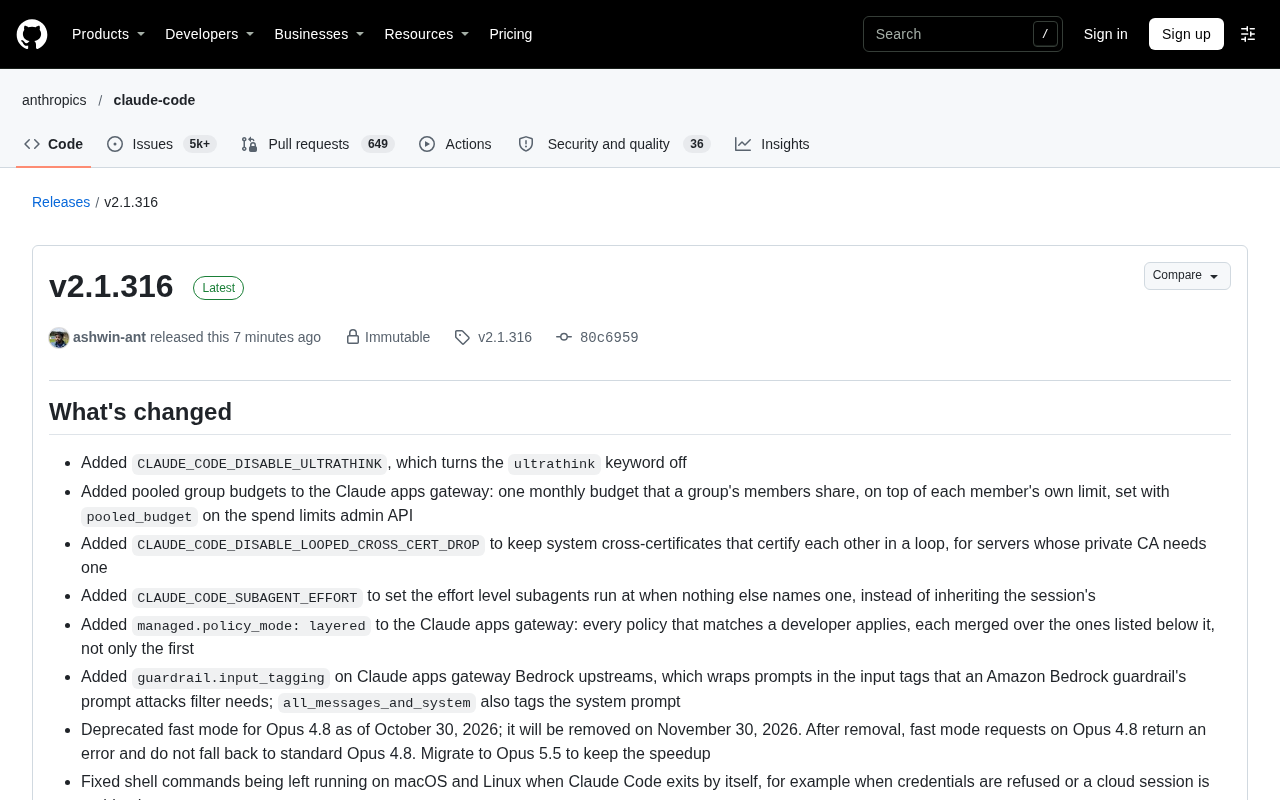
Claude Code v2.1.316 更新解析:企业级网关与多项稳定性修复
Claude Code v2.1.316 发布:新增企业网关池化组预算、分层策略模式、子智能体 effort 控制,修复 Shell、网络与会话恢复等数十项问题,并弃用 Opus 4.8 fast 模式。