Auto Researcher能否复现人类研究决策?AutoHRS框架给出答案
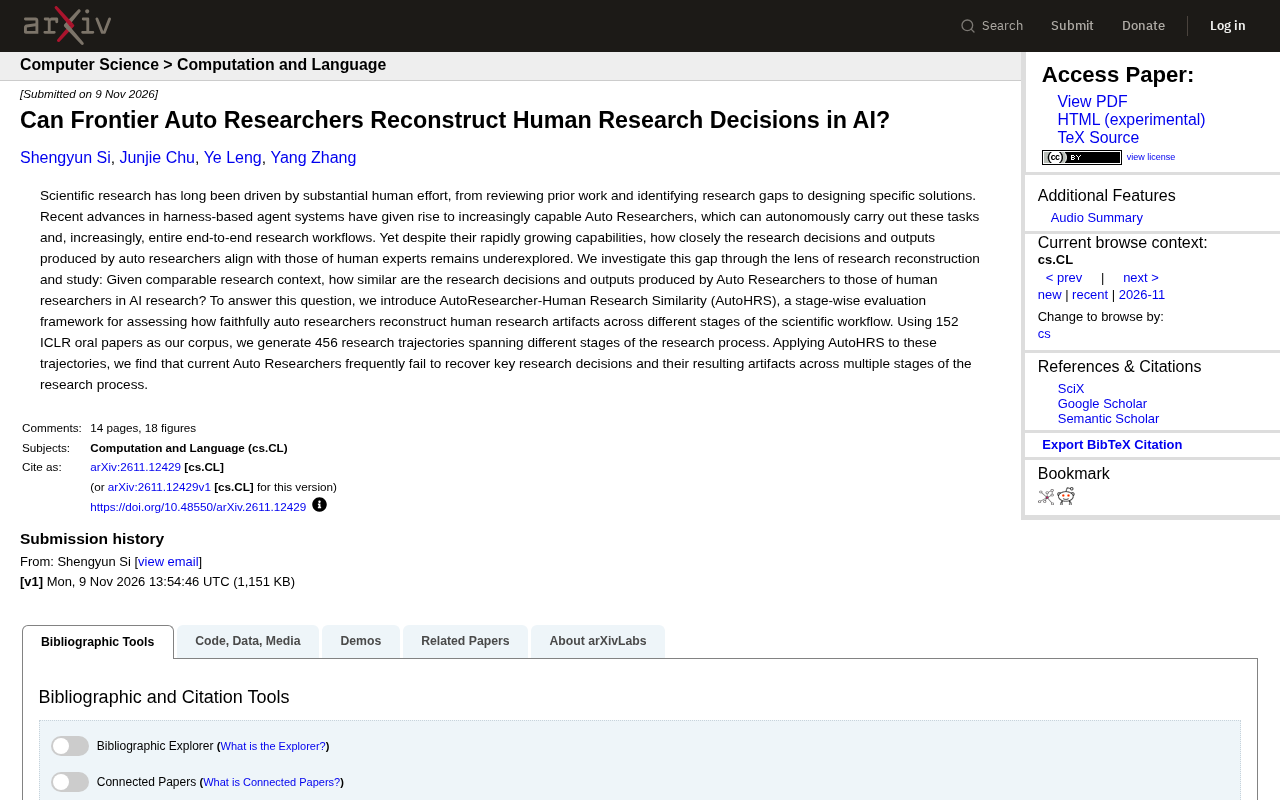
AutoHRS分阶段评估显示Auto Researcher常无法复现人类关键研究决策。
文章介绍了一项关于Auto Researcher(自动研究员)与人类研究决策对齐程度的研究。研究者提出AutoHRS分阶段评估框架,将科研工作流拆解为多个阶段并设计相似性度量,基于152篇ICLR oral论文生成456条研究轨迹进行系统评估。核心发现是:当前Auto Researcher在多个研究阶段频繁无法恢复人类的关键研究决策及其成果,重建失败并非个例。文章指出,这提示评估应转向过程导向而非仅看最终输出,并讨论了决策可对齐性对系统可信度的重要性。AutoHRS框架与轨迹数据集为后续系统改进提供了可复用基准,也为AI for Science领域划出了下一阶段的重点方向。
引言:当AI开始做研究,它真的像人类吗?
科学研究长期依赖人类的大量努力——从回顾文献、发现研究空白,到设计具体解决方案。近年来,基于harness的agent系统催生了能力越来越强的Auto Researcher(自动研究员),它们能够自主执行这些任务,甚至覆盖端到端的完整研究流程。然而,尽管能力快速提升,Auto Researcher产出的研究决策和成果与人类专家的对齐程度,仍缺乏深入探索。
一篇最新研究正是从这个缺口切入,通过"研究重建"的视角,系统评估了Auto Researcher在AI研究中对人类决策的复现能力。
Auto Researcher(自动研究员) 是指能够自主执行科研工作流的AI系统,通常基于大语言模型与外部工具(检索、代码执行、实验平台)构建。其典型流程包括:文献调研与空白识别、研究问题定义、方法设计、实验实现与调参、结果分析与论文撰写。与传统的“AI辅助工具”不同,Auto Researcher强调端到端自主性——人类只给出高层目标,系统自行拆解并推进。近年来的代表性工作多采用“harness”架构:用一个控制器调度多个专用子agent(如检索agent、编码agent、评审agent),并通过记忆与反馈循环迭代。这类系统的能力提升很快,但也带来评估难题:最终论文的流畅度容易掩盖中间决策的偏差,因此需要过程级、可对齐的评估方法。
AutoHRS框架:分阶段评估研究相似性
为了回答"在可比的研究背景下,Auto Researcher产生的研究决策和输出与人类研究者有多相似"这一问题,研究者提出了AutoResearcher-Human Research Similarity(AutoHRS),一个分阶段的评估框架。该框架用于衡量Auto Researcher在科学工作流的不同阶段,对研究成果的复现忠实度。
AutoHRS的核心思路是将研究过程拆解为多个阶段,并针对每个阶段设计相应的相似性度量。这使得评估不再停留在最终论文的层面,而是深入到研究决策的中间环节——比如问题定义、方法选择、实验设计等。这种细粒度的评估方式,能够揭示Auto Researcher在哪些环节更接近人类,在哪些环节偏离较大。
研究语料与轨迹生成
研究团队以152篇ICLR oral论文作为语料库,并生成了456条研究轨迹,覆盖研究过程的不同阶段。ICLR oral论文通常代表领域内的高质量工作,以其为基准可以确保评估的参考标准具有足够的严谨性。
通过将AutoHRS应用于这些轨迹,研究得出了一个关键发现:当前的Auto Researcher在多个研究阶段中,经常无法恢复关键的研究决策及其产生的成果。
ICLR oral论文 指在国际学习表征会议(ICLR)中被接收为口头报告(oral)的论文。ICLR是机器学习与人工智能领域的顶级会议之一,采用开放评审制度;oral 论文通常只占接收论文的很小比例,代表评审分数最高、社区关注度最强的一批工作。以oral论文作为语料库,意味着基准的研究问题、方法创新性和实验严谨性都处于较高水平,从而对Auto Researcher的复现能力提出更严格的要求。研究轨迹(research trajectory) 则指从初始研究背景到最终成果的完整决策序列,包括问题界定、方法选择、实验配置、结果解释等中间步骤。将一篇论文拆解为多条轨迹,可以覆盖不同阶段与不同决策路径,使相似性评估不局限于最终文本,而能定位到具体失败环节。
核心发现:重建失败并非个例
研究结果表明,Auto Researcher在复现人类研究决策方面存在系统性不足。具体而言,在多个研究阶段上,Auto Researcher未能捕捉到人类研究者在相同背景下做出的关键决策,从而导致最终产出的成果与人类存在显著偏差。
这一发现具有两层含义。一方面,它说明当前Auto Researcher的能力边界仍然明显——尽管可以自主执行研究流程,但在决策的"人类相似性"上还有很长的路要走。另一方面,它也提示我们,评估Auto Researcher不能只看最终输出是否像模像样,而需要深入过程,检查其决策逻辑是否与人类专家一致。
为什么重建人类决策如此重要?
如果Auto Researcher的目标是辅助甚至替代部分人类研究工作,那么其决策的可解释性和可对齐性就至关重要。一个无法复现人类关键决策的系统,很难在需要专业判断的研究场景中被信任。AutoHRS框架的价值在于,它提供了一种可操作的方式来量化这种对齐程度,为后续改进指明方向。
决策可对齐性(decision alignment) 是AI安全与可靠性研究中的核心概念,指AI系统在相同情境下做出的判断与人类专家的一致程度。在科学研究场景中,可对齐性不仅关乎“结果对不对”,更关乎“推理路径是否可被专家理解和信任”。一个Auto Researcher即便偶然产出看似合理的论文,如果其方法选择、实验设计缺乏可追溯的人类相似逻辑,评审者就难以判断其可靠性,也难以在关键环节进行干预和纠错。研究重建(research reconstruction) 是一种评估范式:给定人类研究者的初始背景与约束,要求系统重建其关键决策与产出,再与真实轨迹比较。相比只看最终产物的黑箱评估,重建范式能暴露系统在问题定义、假设生成、实验取舍等环节的系统性偏差,为改进提供可操作的诊断信号。
对Auto Researcher发展的启示
这项研究为Auto Researcher的未来发展提供了几个重要启示。
评估需要过程导向
仅以最终论文或成果作为评估对象,会掩盖研究过程中决策的差异。AutoHRS的分阶段评估表明,过程导向的评估能够暴露更多问题,也更能指导系统改进。
当前系统在决策复现上仍有明显短板
研究结果直接指出,现有Auto Researcher在多个阶段频繁失败。这意味着,尽管端到端研究流程的自动化令人兴奋,但在可靠性达到人类专家水平之前,仍需大量工作。
为后续研究提供了基准
AutoHRS框架和基于152篇ICLR oral论文的456条轨迹,为后续研究提供了一个可复用的评估基准。未来的Auto Researcher系统可以在这一基准上进行比较,推动领域向更高的人类相似性迈进。
结语
Auto Researcher的能力进步有目共睹,但这项研究提醒我们,真正的挑战不在于能否自主完成研究流程,而在于能否做出与人类专家相似的关键决策。AutoHRS框架的提出,为衡量这一差距提供了系统化的工具,也为Auto Researcher的下一步发展划出了重点。对于关注AI for Science的研究者和开发者而言,这是一个值得深入关注的方向。
相关推荐
Starlink Mini 2 发布:便携卫星上网再进化
Starlink Mini 2 在 Hacker News 引发热议,帖子获 285 点、291 条评论。本文梳理便携卫星终端的迭代方向、社区讨论焦点及实际使用场景。
PewDiePie自搜趣谈:退休、自研AI模型Ajax与Linux日常
PewDiePie发布自搜视频,回应退休传闻,透露自研AI模型Ajax已达60 tokens/s、仍处BF16训练阶段,并分享Arch Linux日常、OpenAI封禁经历与对YouTube生态的疲惫感。
PewDiePie自曝失败:两年喂乌鸦计划为何翻车?
PewDiePie分享两年失败经历:试图与日本乌鸦交朋友,从喂花生到拯救倒吊乌鸦,最终被一位日本爸爸“抢走”荣耀。视频展现了与野生动物互动的真实挑战,以及创作者坦诚失败的一面。