AWS MCP让AI帮你调试Lambda:真实后端上下文有多重要

AWS MCP Server让编码Agent接入运行中的AWS后端,聚合真实证据辅助排查,但判断权仍留给人。
文章介绍了 AWS MCP Server 如何通过 Model Context Protocol 让 AI 编码助手突破代码仓库边界,接入运行中的 AWS 后端,检查 Lambda 及其关联的 API Gateway、数据库等服务。Agent 会将当前错误信号与 7 天基线对比以识别真正异常,并进一步核查配置状态、延迟指标与近期变更,最终把部署时间戳、错误率曲线、配置差异等证据聚合呈现,而非直接下结论。这种设计保留了 human-in-the-loop 约束:开发者需审查诊断结果后再批准修复,因为分布式系统故障归因本身充满不确定性。文章认为这标志着 AI 编程工具正从「代码补全」走向「运行时感知」,值得关注的不是它能否替人修 bug,而是能否更快呈现更完整的证据链。
当AI编程助手开始读你的生产环境
大多数AI编程工具的视野止步于代码仓库。它能帮你写函数、补测试、解释报错栈,但一旦问题发生在运行中的云环境里——Lambda冷启动异常、API网关超时、数据库连接池耗尽——它就只能靠猜。
AWS MCP Server 改变了这个边界。通过 Model Context Protocol,编码Agent可以接入正在运行的AWS后端,直接检查Lambda函数及其关联服务(API Gateway、数据库等),而不只是盯着本地代码。
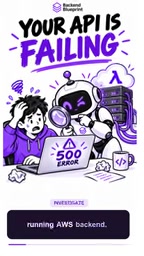
这个能力的核心价值不在于"AI自动修bug",而在于让AI获得真实的后端上下文。正如原视频所强调的:AI调试需要真实的后端上下文,而不只是你的代码。
Model Context Protocol(MCP) 是由 Anthropic 于 2024 年底主导提出的开放协议,旨在为 AI 应用与外部数据源、工具之间建立统一的通信标准。它常被类比为「AI 世界的 USB-C 接口」:在 MCP 出现之前,每个 AI 助手想接入数据库、代码仓库或云服务,都需要单独定制集成层,碎片化严重;MCP 把这些集成抽象成标准化的 Server 与 Client 角色——数据源或工具方实现一个 MCP Server,暴露资源、工具和提示模板,Agent 侧则以 MCP Client 身份发现并调用它们。协议底层通常基于 JSON-RPC,支持本地 stdio 或远程 HTTP/SSE 传输。AWS MCP Server 正是把 AWS 的各类服务封装成一个 MCP Server,让编码 Agent 通过标准协议访问运行中的云资源,而无需为每一种 AWS 服务写一次性适配代码,这也是它能快速扩展检查面的关键。
它具体怎么工作
错误信号对比7天基线
Agent不会孤立地看待一条报错。它会将当前的错误信号与过去7天的基线进行对比,判断这是"一直存在的已知问题"还是"刚刚出现的异常"。
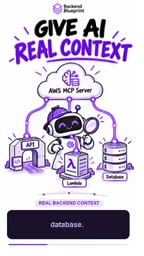
这个基线对比的机制很关键。没有基线,任何错误看起来都很严重;有了基线,Agent才能识别出"这个错误率突然从0.1%跳到5%"这种真正值得关注的信号。
基线(baseline) 在可观测性领域指系统在正常运行时各项指标的典型取值分布,通常以滑动时间窗口(如 7 天、30 天)的统计量来刻画,包括中位数、P95/P99 分位、方差等。之所以常见 7 天窗口,是因为它覆盖了一个完整的工作日/周末周期,能吸收流量日内波动和周期性业务峰值,避免把「周一早高峰的正常升高」误判为异常。基线的价值在于把「绝对阈值告警」升级为「相对偏离检测」:固定阈值(如错误率超过 1% 就报警)在业务增长或季节性波动下容易误报或漏报,而与基线比较则能识别出「相对自身历史异常」的偏移,例如错误率从稳定在 0.1% 突然跳到 5%。这也解释了为何 Agent 需要拿当前信号与 7 天基线对照——它实际上是在自动执行一次离群点检测,而非简单读取一个数字。
检查配置、延迟和近期变更
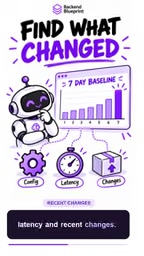
在识别异常信号后,Agent会进一步检查三个维度:
- 配置状态:Lambda的环境变量、内存分配、超时设置是否被改动过
- 延迟指标:函数执行时间、API网关响应时间是否出现劣化
- 近期变更:是否有新的部署、配置更新或依赖升级
这三项检查构成了一个基本的因果排查框架。
变更管理(change management) 是 SRE 和运维实践中的核心议题。Google SRE 的统计经验表明,生产环境故障中约七成由某种变更引发——新部署、配置推送、依赖升级、扩缩容策略调整都算。因此故障排查往往遵循「先看最近改了什么」的原则,这也是变更审计日志(如 AWS CloudTrail)存在的原因。文章提到的「三件套」——配置状态、延迟指标、近期变更——本质上是在做相关性收敛:变量越少,归因越可靠。其中「延迟」是分布式系统中最敏感的探针之一,因为连接池耗尽、下游依赖抖动、冷启动都会先在 P99 延迟上留下痕迹,往往早于错误率飙升。把它们与错误率时间线对齐,能帮助人快速判断是「新引入」还是「慢性积累」的问题。
把证据串起来,而不是下结论
设想一个典型场景:一次部署之后,错误率出现尖峰。
Agent会把部署时间戳、错误率变化曲线、配置差异、延迟波动这些证据聚合在一起,呈现给你。注意用词——它"帮助你调查",而不是"告诉你原因"。
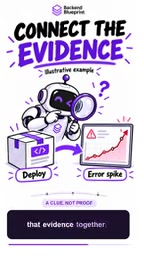
这不是谦辞。分布式系统的故障归因本身就充满不确定性,一个部署之后出现错误尖峰,可能是因为新代码,也可能是同时段流量突增、下游依赖抖动、或者某个配置项的连锁反应。Agent提供的是证据聚合,不是因果证明。
人仍然在回路里
这个工具的设计中有一个明确的约束:你需要在批准修复之前审查诊断结果。
这个约束不是技术限制,而是产品哲学。让AI自主修改生产环境配置的风险极高,而让AI整理证据、人来做判断,是一个更务实的协作模式。
从工程实践角度看,这个定位是合理的。AI擅长的是:快速拉取多个数据源、自动对比时间线、发现人可能忽略的相关性。人不擅长的是:在凌晨三点被告警叫醒后快速完成上述所有操作。两者互补。
Human-in-the-loop(人在回路) 是自动化系统中让人类在关键决策点保留审批或干预权的设计模式,在核电站控制、自动驾驶、医疗 AI 与现在的 AI Agent 中都有应用。它的核心权衡是:完全自动化决策效率最高,但一旦出错影响面巨大;完全人工则效率低下。折中方案是把 AI 定位为「证据整理者」而非「决策者」,在高风险动作(如修改生产环境配置、回滚部署)前设置人工确认关卡。另一种相关概念是「human-on-the-loop」,即人只做事后监督,AI 自主执行——这适合低风险、可逆的操作。文章强调的「批准修复前审查诊断」正属于典型的 human-in-the-loop:Agent 承担取证与聚合,人承担判断与担责,既利用了 AI 的速度,又把不可逆操作的风险留在人类可控范围内。
对AI编程工具的一点思考
这个方向揭示了一个趋势:AI编程助手正在从"代码补全"走向"运行时感知"。
只懂代码的AI,就像一个从没进过机房的架构师——理论功底再好,也缺少对真实系统行为的第一手认知。而当Agent能读取Lambda的运行指标、API网关的延迟数据、数据库的连接状态时,它的建议才开始有工程意义上的重量。
AWS MCP Server 是朝这个方向走的一步。它的当前形态还比较克制——检查、对比、聚合、呈现,把判断权留给人——但这种克制恰恰是它在生产环境中可用的前提。
对于已经在用AI编码助手的团队,值得关注的问题不是"它能不能替我修bug",而是"它能不能帮我在更短时间内看到更完整的证据链"。
相关推荐

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。

Anthropic IPO前,早期投资人账面回报有多高?
Anthropic IPO前早期投资人账面回报引发关注。本文分析其纸面收益来源、资本结构、IPO预期下的博弈与风险,以及对AI创业生态的启示。