Azure HorizonDB+VS Code:AI应用开发新工作台
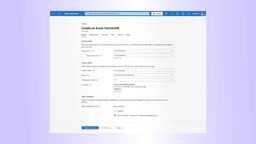
微软 Horizon DB 以 VS Code 深度整合和企业级底座,把事务、向量与 AI 能力收进同一 Postgres 平台。
Azure Horizon DB 是微软推出的企业级 Postgres 托管服务,采用 AMD EPYC 计算、区域冗余高可用,存储可自动扩展至 128 TB,并默认开启 Entra ID 认证与 Private Link 私有网络。其核心特色是与 VS Code 的深度整合:Copilot 代写 SQL、Object Explorer 浏览结构、Visual Query Plan 把 Explain Analyze 输出转为可读执行树,备份、参数调优与监控也在同一界面完成。AI 能力内建于数据库层,向量索引支撑语义搜索,AI 管道与内置模型覆盖数据分块与嵌入生成,减少 RAG 应用的跨系统集成。扩展方式为点击式只读副本横向扩展,无需重构且无停机。文章认为其方向契合数据栈碎片化痛点,但实际体验仍取决于生态成熟度。
微软正在把数据库从"后端基础设施"变成"开发者工作台的一部分"。Azure Horizon DB 是微软推出的企业级 Postgres 托管服务,而它与 VS Code 的深度整合,勾勒出一套面向 AI 应用开发的完整工作流:写代码、调 SQL、管运维、做向量检索,都在同一个编辑器里完成。
企业级底座:从硬件到网络的开箱即用
Horizon DB 的定位很明确——企业就绪,同时为开发者优化。计算层采用 AMD EPYC 处理器,提供区域冗余的高可用架构,存储可自动扩展至 128 TB。这些配置意味着团队不必在项目初期纠结容量规划,数据库会跟随业务增长自动伸缩。
安全能力默认开启,而不是事后加装。Entra ID 身份认证与 Private Link 私有网络连接构成了访问控制的基础,数据在默认配置下就处于企业级保护之中。
部署入口也很灵活:既可以从 Azure 门户创建实例,也可以直接在 VS Code 中完成配置。对于习惯"不离开编辑器"的开发者来说,后者省去了在浏览器和 IDE 之间来回切换的摩擦。
区域冗余高可用指数据库的主副本与同步副本分布在同一 Azure 区域内的不同可用区(Availability Zone),每个可用区拥有独立的供电、冷却和网络。当单个可用区发生故障时,服务可自动切换到另一可用区的副本,RPO 接近于零。这与跨区域(geo-redundant)复制不同,后者用于灾难恢复而非日常高可用,延迟更高。
Private Link 是 Azure 的私有终结点机制,它把 PaaS 服务的访问入口映射到用户虚拟网络内的一个私有 IP,流量走微软骨干网而不经过公共互联网。配合 Entra ID(原 Azure AD)做身份认证,可以实现“网络不可达 + 身份不可冒用”的双层防护,这也是企业合规审计中最常要求的组合。
VS Code 内的数据库工作流
这套整合的核心理念是消除上下文切换。在 VS Code 中,GitHub Copilot 可以代写 SQL,Object Explorer 让你无需离开编辑器就能浏览表、索引和属性。
对很多开发者来说,最实用的是 Visual Query Plan:它把 Explain Analyze 的输出转成一棵可读性强的执行树,原本需要经验才能解读的查询计划,现在可以直观定位性能瓶颈。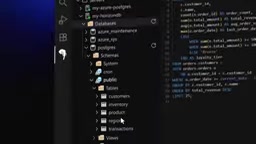
面向 DBA 的能力同样收进了这个工作区:备份管理、服务器参数调优、实时监控,全部在同一个界面内完成。数据库运维与代码编写共享同一块屏幕,减少的正是那种"改一行代码要切三个工具"的低效。
Visual Query Plan 所基于的 EXPLAIN ANALYZE 是 PostgreSQL 的执行计划分析命令:EXPLAIN 展示优化器选择的执行路径(顺序扫描、索引扫描、嵌套循环、哈希连接等)及预估代价,加上 ANALYZE 后会真实执行语句并回填每步的实际耗时与行数。原始输出是缩进文本树,节点多时难以阅读。可视化工具把每个节点渲染为图形节点,并按耗时或代价着色,帮助快速定位全表扫描、行数预估偏差(estimated vs actual rows 差距大)等典型性能问题。
Object Explorer 则是 IDE 内的数据库元数据浏览器,通过查询系统目录(如 pg_catalog)列出库、schema、表、索引、约束与函数,使结构浏览不必依赖独立客户端工具。
把 AI 能力下沉到数据库层
Horizon DB 的差异化在于,AI 不是外挂,而是数据库的内建能力。磁盘与向量索引支撑高性能语义搜索,这对 RAG 类应用是基础能力。
更进一步,AI 管道、AI 函数和内置 AI 模型提供了一套完整方案,覆盖数据分块与向量嵌入生成。应用从传统系统演进为智能系统时,团队不再需要单独搭建一套向量数据库和嵌入服务,数据准备与检索可以在同一个平台内闭环。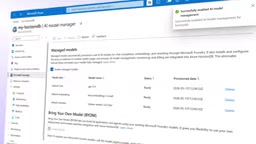
这套设计的价值在于降低集成复杂度:事务、向量、AI 与编排共享同一平台,减少了跨系统同步数据带来的一致性问题。
向量索引用于加速近似最近邻(ANN)检索。PostgreSQL 生态中常见的是 pgvector 扩展,支持 IVFFlat 与 HNSW 两类索引:前者把向量聚类分桶以减少扫描范围,构建快但召回率受桶数影响;后者构建多层可导航图,查询延迟低、召回率高,但内存占用与建索引时间更大。语义搜索把文本经嵌入模型转成高维向量,再按余弦相似度或内积排序,这是 RAG(检索增强生成)中“检索”一环的标准做法。
RAG 与嵌入生成:RAG 指在调用大模型前,先从知识库检索相关片段拼入提示词,以缓解模型幻觉和知识过期问题。其前置步骤是数据分块(chunking)与向量嵌入(embedding)——把长文档切成语义完整的片段,再逐块调用嵌入模型生成向量并写入向量列。将这些步骤内置到数据库,意味着分块、嵌入、存储、检索共享同一事务边界与权限体系,避免外部管道与主库之间的数据同步延迟。
扩展方式:点击即横向扩展
当应用负载上升时,Horizon DB 支持通过几次点击在副本之间横向扩展,无需重新架构,也不产生停机。对 AI 应用这类流量波动明显的场景,这种扩展方式降低了容量规划的负担。
只读副本横向扩展指在主实例之外创建一个或多个只读副本(read replica),通过流复制持续同步数据,再把报表、分析、向量检索等读密集负载路由到副本,主库专注写入。PostgreSQL 的流复制分为异步与同步两种模式:异步模式主库提交不等副本确认,吞吐高但故障切换可能丢少量事务;同步模式保证副本已收到 WAL 才提交,数据更安全但写延迟上升。
需要注意,只读副本扩展的是读能力而非写能力——写吞吐仍受单主库限制。若业务需要写扩展,通常要引入分区、分片或队列削峰。此外,副本上的查询会带来复制延迟(replication lag),对强一致读取的场景需显式路由回主库。
一点冷静的判断
从官方演示看,Horizon DB 的野心是成为"交易+向量+AI+编排"的统一平台。这个方向契合当前 AI 应用开发的实际痛点——数据栈碎片化。不过,这类整合型服务的实际体验取决于生态成熟度:Copilot 生成 SQL 的准确率、Visual Query Plan 对复杂查询的解析深度、内置模型的可选范围,都需要在真实项目中检验。对已经在 Azure 体系内的团队,它降低了工具链复杂度;对多云团队,迁移成本仍需权衡。
要点回顾
- Horizon DB 是企业级 Postgres 托管服务,存储自动扩展至 128 TB,区域冗余高可用
- 与 VS Code 深度整合,Copilot 写 SQL、Object Explorer 浏览结构、Visual Query Plan 可视化执行计划
- 向量索引与内置 AI 模型支持语义搜索、数据分块与嵌入生成
- 支持点击式横向扩展,无需重构、无停机
相关推荐

美国AI机密正在泄露:安全漏洞比中国间谍更可怕
Vox分析指出,英伟达、OpenAI、Anthropic等美国AI公司频发安全漏洞,从CEO丑闻到内部系统被快速攻破,以“防中国”为名的信息管控反而掩盖了基础安全的缺失,危及自身技术领先地位。

苹果为macOS加装AI安全阀:新权限控制如何应对智能体隐私风险
苹果披露macOS 27.3全新Mac安全控制:针对AI智能体的细粒度权限、运行时警告与操作透明度功能,如何应对智能体动态访问敏感数据的隐私风险,以及对开发者和用户的影响分析。

民主党挡不住数据中心?美国最大核电商不担心
Constellation Energy CEO Joe Dominguez在财报电话会上表示不担心民主党放缓数据中心开发,本文分析核能行业为何对数据中心电力需求保持长期信心,以及政治周期与基础设施投资之间的博弈。