Azure SQL Hyperscale架构解析:解耦计算与存储的云原生数据库

Azure SQL Hyperscale通过解耦计算与存储,实现存储、计算、读取、可用性和日志吞吐的独立伸缩,并集成向量检索与AI能力。
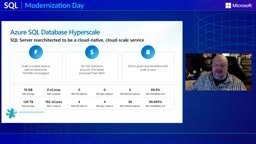
Azure SQL Database Hyperscale是一种云原生数据库架构,其核心是将SQL引擎与事务日志处理、持久化存储解耦,使计算、日志和存储三条路径能够独立伸缩。该架构支持单库自动增长至128TB,计算最高192个vCore,读取扩展最多30个命名副本,并提供高达99.995%的可用性SLA。通过分层缓存和页面服务器设计,Hyperscale优化了读写性能,同时将备份恢复下沉到存储层,实现多TB数据库的快速恢复。此外,Hyperscale内置向量检索能力,支持AI应用与运营数据同库共存。成本模型包括弹性池和Serverless选项,适应不同负载形态。总体而言,Hyperscale在保持SQL熟悉性的同时,提供了传统架构难以复制的弹性与扩展性。
Azure SQL Hyperscale架构解析:解耦计算与存储的云原生数据库
当数据库从几十GB增长到几十TB,传统SQL Server架构往往要求在早期就为峰值容量买单——预配大量计算和存储资源,其中相当一部分在数年内处于闲置状态。微软Azure SQL Database Hyperscale试图从根本上改变这个等式。在微软官方技术分享中,项目经理David Plus系统讲解了这套架构的设计逻辑:不是让每个数据库都变成巨型系统,而是让存储、计算、读取和可用性各自按需伸缩。
有意思的是,Hyperscale并不是MPP数据仓库,也不是多主写入架构。它仍然是Azure SQL Database,仍然是开发者熟悉的T-SQL编程模型,改变的是底层的分布式云原生架构。
计算与存储分离:Hyperscale的架构基石
Hyperscale的核心设计是将SQL数据库引擎与事务日志处理、持久化存储解耦。计算层的主副本运行熟悉的SQL引擎,处理读写负载,使用内存缓冲池和本地SSD缓存保持热数据就近访问。当请求的页面不在本地时,计算副本从对应的页面服务器(Page Server)获取——页面服务器各自管理数据库的一部分,维护自己的SSD缓存,而持久化数据文件则冗余存储在Azure Storage中。
这种分层设计让存储容量可以独立于计算规模增长。单个数据库可自动增长至128 TB,无需因为数据库变大而被迫提升计算规格。事务日志走独立路径:主副本产生日志记录,日志服务负责持久化并分发给页面服务器和次级计算副本。计算、日志、存储三条路径各司其职,是后续所有弹性能力的基础。
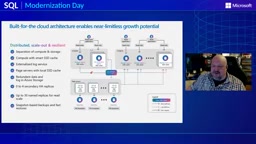
页面服务器(Page Server)是Hyperscale架构中的核心存储组件,它负责管理数据库的一部分数据页,并维护自己的SSD缓存以加速读取。每个页面服务器只处理特定范围的数据页,这种分片设计使得存储层可以水平扩展。当计算副本需要某个数据页时,它会根据页面的日志序列号(LSN)向对应的页面服务器发起请求,页面服务器首先检查自己的缓存,若未命中则从Azure Storage的持久化文件中读取。页面服务器还负责消费事务日志,将日志记录应用到自己的数据页上,确保持久化数据与日志一致。这种设计将存储的读写负载分散到多个页面服务器,避免了单点瓶颈,同时通过本地SSD缓存降低了远程存储的访问延迟。
五维伸缩能力:存储、计算、读取、可用性与日志吞吐
Hyperscale的伸缩性体现在多个独立维度上。存储方面,单库自动增长至128 TB,无需预配容量。计算方面,最高可扩展至192个vCore,且扩展计算不需要移动数据库。读取方面,最多支持30个命名副本(Named Replica),每个副本可独立配置计算资源,将报表、分析和AI等读密集型负载与主副本的事务负载隔离开。
可用性方面,采用区域冗余配置时,Hyperscale提供最高99.995%的可用性SLA。事务日志吞吐方面,日志服务可提供最高150 MB/s的吞吐量,且独立于主副本的计算规格。需要强调的是,并非每个应用都需要触及这些上限——Hyperscale的价值在于让你从当前需求起步,随需求增长独立扩展各个维度。
三种服务层级怎么选
Hyperscale是Azure SQL Database vCore模型三个服务层级之一。通用型(General Purpose)是成本均衡的选择,使用远程持久化存储;业务关键型(Business Critical)面向事务密集、要求低延迟IO和高可用性的场景,使用本地SSD多副本;Hyperscale则采用分布式云原生架构,提供独立伸缩的计算与存储、自动存储增长和独立读取扩展。
选择层级时不应只看数据库大小。一个较小的数据库可能需要业务关键型的低延迟性能,而一个正在增长的数据库可能更适合Hyperscale的独立伸缩和读取隔离。另外,Serverless不是第四个服务层级,而是通用型和Hyperscale都可用的计算选项。
命名副本(Named Replica)是Hyperscale中用于读取扩展的只读计算副本,每个命名副本拥有独立的连接端点,应用程序可以将只读工作负载定向到特定的命名副本。与高可用副本不同,命名副本不参与自动故障转移,而是专为隔离读密集型负载(如报表、分析和AI推理)而设计。命名副本共享主副本的页面服务器和存储层,因此创建命名副本不需要复制数据,只需配置独立的计算资源(CPU、内存和缓存)。每个命名副本可以独立设置计算规格,并且可以随时添加或删除。这种架构允许读取能力随需求线性扩展,而不会影响主副本的写入性能,同时由于共享存储,数据一致性由日志服务保证。
读写路径拆解:分层缓存如何避免“每次读取都走远程存储”
理解Hyperscale的关键在于区分“事务何时持久化”与“所有分布式组件何时应用变更”。写入路径上,主副本的SQL引擎执行请求、修改内存中的页面并生成日志记录。日志服务提供持久化路径——事务不需要等待每个变更页面写穿所有层,只要日志持久化,下游组件就可以继续应用变更。页面服务器消费自己负责的数据范围的日志,高可用副本和只读副本同样消费日志以保持同步,最终页面服务器将更新持久化到Azure Storage。
读取路径则依赖分层缓存。查询在选定的计算副本上执行——可以是主副本、用于读取扩展的高可用副本,或命名副本。引擎需要数据页时先查内存缓冲池,未命中则查本地SSD上的弹性缓冲池扩展(Resilient Buffer Pool Extension),仍未命中才按所需的日志序列号向对应页面服务器请求,页面服务器再视情况从Azure Storage的持久化文件中读取。返回的页面会填充各级缓存,使后续请求更靠近计算层完成。
弹性缓冲池扩展(Resilient Buffer Pool Extension)是Hyperscale计算副本上的一种本地SSD缓存机制,用于扩展内存缓冲池的容量。当内存缓冲池未命中时,数据库引擎会检查本地SSD上的弹性缓冲池扩展,其中缓存了从页面服务器获取的数据页。这种分层缓存设计显著减少了向页面服务器发起远程请求的次数,因为频繁访问的页面会被缓存在本地SSD上,即使它们不在内存中。弹性缓冲池扩展的大小与计算副本的本地SSD容量相关,并且可以根据计算规格进行调整。通过将热数据保留在计算层附近,Hyperscale能够在保持存储分离的同时提供接近本地存储的读取性能。
高可用副本与命名副本:共享存储层带来的弹性
主副本、高可用副本和命名副本共享同一套存储架构。可配置0到4个高可用副本作为热备计算用于自动故障转移,由于与主副本共享页面服务器,添加高可用副本不需要创建另一份完整的数据库拷贝。命名副本最多30个,每个都是只读的,拥有独立连接端点和可独立配置的CPU、内存与缓存。应用仍通过单一主副本写入,只读负载可定向到命名副本。
备份与恢复也被推到了存储层,使用文件快照完成。备份几乎是瞬时的,不消耗主副本或次级副本的计算资源。同区域恢复在使用相同存储配置时可在数分钟内完成,即使数据库达到多TB级别——恢复时间不再随数据库大小线性增长。
性能故事:日志吞吐、缓存与计算扩展多路并行
Hyperscale的性能设计原则是让数据库增长和性能不再作为一个紧密耦合的整体同步扩展。写入侧依赖外置日志架构提升事务日志吞吐;读取侧通过分层缓存减少远程页面获取,弹性缓冲池扩展利用计算副本和页面服务器上的本地SSD;读取能力可独立扩展,命名副本让报表、分析和AI工作负载使用自己的计算资源。需要更多计算时,Premium系列配置最高可达192个vCore、843 GB内存和816,000本地SSD IOPS。
一个容易被忽略的细节是“连续预热”(Continuous Priming)。故障转移时,高可用副本可能已完全追上日志、随时可以成为主副本,但其工作集仍是冷的——连接恢复了,查询性能却没恢复。连续预热让Hyperscale跟踪主副本访问的活跃页面,由页面服务器将这些活跃页面回供给高可用副本,提前填充其缓冲池和本地SSD缓存。目标不是复制整个数据库,而是让活跃工作集更靠近高可用副本,缩短故障转移后的性能恢复时间。
成本模型:弹性池与Serverless对应不同负载形态
成本效率的关键不是少用计算,而是选择匹配负载的消费模型。Hyperscale弹性池面向多个使用模式不同的数据库,典型场景是多租户SaaS应用——不是为每个数据库的个体峰值单独配足资源,而是在池内共享计算和日志资源,利用峰值时间差提升利用率。Hyperscale Serverless则面向单个数据库的间歇性或不可预测需求,可定义最小和最大计算范围自动伸缩,符合条件的数据库还支持自动暂停与自动恢复,暂停期间计算计费停止而存储费用继续。
AI与向量检索:让语义搜索与运营数据同库共存
Azure SQL将向量能力直接内置到数据库中。可以在关系数据旁生成并存储嵌入向量,将向量相似度与熟悉的SQL谓词和过滤条件结合,基于磁盘的近似最近邻(ANN)提供索引化的向量搜索。在RAG模式中,应用从SQL检索相关上下文提供给语言模型,生成更有依据的响应。SQL仍是运营事实的权威来源,模型基于这些事实生成体验。
演示环节展示了一个生物医学证据检索应用:每篇文章被切分为段落并生成嵌入向量,向量索引覆盖全部内容。搜索同时执行向量检索(找语义)和关键词检索(找基因名、药物代码等精确字符串),用倒数排名融合(RRF)合并排名。该查询运行在Hyperscale Serverless上,在设定的vCore范围内自动伸缩,闲置一小时后自动暂停。随着应用增长,数据库扩展到192个vCore、约8 TB规模、全表超过10亿行,同一个向量索引和同一条搜索仍能在毫秒级完成。再进一步,命名副本与主副本共享页面服务器和向量索引,无需数据拷贝、无需重建第二份索引,几分钟内即可完成配置。
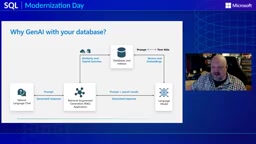
这意味着应用不必在每个增长阶段更换搜索架构:从Serverless试点起步,数据库扩张时保留同一套混合搜索模式,读取需求增长时再添加独立规格的命名副本。AI检索因此不必与事务负载直接竞争资源。
倒数排名融合(Reciprocal Rank Fusion, RRF)是一种用于合并多个检索结果列表的算法,常用于混合搜索场景。在Hyperscale的演示中,向量检索和关键词检索各自返回一个按相关性排序的结果列表,RRF通过计算每个文档在各自列表中的排名的倒数之和来生成综合排名。具体公式为:对于每个文档,将其在不同列表中的排名取倒数后相加(通常加上一个常数k以避免除零),然后按总分降序排列。RRF的优点是不需要调整不同检索方法的分数权重,能够平衡语义相似性和精确匹配的贡献。在生物医学证据检索应用中,RRF将向量搜索(捕捉语义相似性)和关键词搜索(捕捉基因名、药物代码等精确术语)的结果融合,提供更全面的排名。
安全:迁移的是安全模型,不只是数据
Hyperscale的安全能力是分层的,但安全态势取决于如何组合配置。身份与访问层由Microsoft Entra ID处理认证,SQL角色、权限和行级安全决定已认证身份能看到什么、能做什么——Azure RBAC治理的是Azure资源,数据库权限治理的是数据访问。数据保护层包括传输层安全、透明数据加密(静态数据和日志文件)、Always Encrypted(客户端加密,密钥对数据库引擎不可见)、动态数据掩码和Ledger防篡改完整性。网络层通过防火墙规则、虚拟网络控制和Private Link控制应用如何到达数据库。治理与可见性层包括数据分类和SQL审计,威胁防护层由Microsoft Defender for SQL检测SQL注入、暴力破解等异常活动。
对于现代化迁移,重点在于迁移安全模型而非仅迁移数据:验证授权身份能成功访问、未授权身份被拒绝、网络访问符合预期、依赖加密的操作正常、审计确实被捕获。
四个支柱的收束
Hyperscale的故事可以归结为四个支柱。熟悉性:保留SQL引擎、T-SQL和SQL专业人员已有的技能。AI:向量与受治理的运营数据保持同库,语义检索与SQL过滤结合,需要隔离时使用独立读取计算。安全:平台提供能力,但身份、权限、加密、网络、审计和威胁防护仍需刻意配置和验证。可扩展性:从小规模起步,随应用增长扩展存储、计算、可用性和读取能力,无需在第一天就部署最大配置。
Hyperscale不是永远正确的选择,但当这些能力与应用的性能、可用性、安全和成本要求匹配时,它提供了传统数据库架构难以复制的弹性空间。
相关推荐

一句提示词引发的全球PHP安全风暴:AI是救星还是隐患?
一句AI提示词竟引发全球PHP安全危机,维基百科、互联网档案馆受波及。本文梳理事件脉络,解析OpenAI与亚马逊的争议,探讨AI时代漏洞发现门槛降低带来的安全悖论与开发者应对策略。

当AI被拿走:依赖捷径如何削弱你的解题韧性
一项涉及1,222人的研究发现:使用AI答题后,一旦AI被移除,人们放弃解题的比例高于从未使用AI的对照组。文章分析AI依赖对学习韧性和元认知的影响,并探讨AI学习工具的设计启示。

Carta联手NewView:让创业公司员工提前套现股权
Carta 与 NewView Capital 合作推出新计划,简化创业公司 tender offer 流程,帮助员工提前出售股权套现。本文分析该合作的核心机制、员工股权流动性痛点及对创业公司股权激励的影响。