八大文生图模型横评:写实、吉卜力、日漫风格谁更强

文生图模型技术背景
在深入横评之前,有必要了解这些模型的共同底层逻辑。文生图(Text-to-Image)模型本质上是基于**扩散模型(Diffusion Model)**的深度学习系统。其工作原理是:训练阶段,模型学习将真实图像逐步"加噪"至纯噪声的过程;推理阶段,模型从随机噪声出发,根据文本提示词的语义引导,逐步"去噪"还原出符合描述的图像。
扩散模型的理论基础可追溯至2020年前后的去噪扩散概率模型(DDPM),其核心思想借鉴了非平衡热力学中的随机过程。早期DDPM的一大痛点是推理速度慢——生成一张图像往往需要数百次迭代去噪步骤。为此,学术界先后提出了DDIM(去噪扩散隐式模型)等加速采样方案,将步数压缩至数十步乃至个位数。而近两年兴起的Flow Matching技术则从根本上改变了训练范式:它不再学习随机扩散轨迹,而是直接拟合从噪声到图像的最优传输路径(Optimal Transport Flow),使训练更稳定、推理路径更短,这正是Flux系列模型能够在保持高质量输出的同时显著提升推理效率的核心原因之一。
CLIP、T5等文本编码器负责将自然语言转化为模型可理解的向量表示,是决定提示词遵从度的关键模块——这也解释了为何不同模型在"是否遗漏元素"上表现差异显著。具体而言,CLIP编码器以对比学习方式训练,擅长捕捉图文间的全局语义对齐,但对长句中的细粒度语义(如多个并列属性)处理较弱;T5等自回归或编码器-解码器架构的文本模型则更擅长理解复杂句法结构与词序关系。Flux系列同时使用CLIP与T5两种编码器的输出进行条件注入,正是为了兼顾全局语义理解与细节属性捕捉,这也是其提示词遵从度相对均衡的技术原因。
AI绘图领域:开源模型群雄并起
在AI绘图领域,开源模型层出不穷,从近期热度颇高的Krea2到阿里的Qwen Image系列,再到黑森林(Black Forest)的Flux系列,每个模型都有自己的拥趸。面对如此众多的选择,普通用户往往难以判断:究竟哪个模型适合哪种风格?本文基于B站UP主的一次系统性横评,对八大主流文生图模型在四大画面风格下的本体能力进行深度解析。
值得注意的是,当前AI绘图生态已形成"基础模型—社区微调—工作流封装"的三层结构。基础模型由大型实验室或科技公司训练发布,社区则围绕这些基础模型衍生出海量的LoRA微调权重、ControlNet控制网络以及定制化ComfyUI工作流。这种开放生态极大地降低了普通用户进入AI创作的门槛,但也带来了选择困难——面对同一基础模型的数十种社区衍生版本,如何选择本体能力最强的底座模型,成为理性决策的前提。
参与横评的八大文生图模型
本次测评涵盖了开源社区几乎所有主流的文生图模型,核心原则是只使用官方原始工作流,不做任何参数优化和复杂后处理,目的是纯粹展现模型的本体能力。

主流模型定位一览
-
Krea2:当前热度最高的模型之一,众多创作者围绕它制作了图片重绘、深度图等多种工作流。本次测评采用双彩(噪点增强)工作流,通过增加噪点输出更多画面细节。所谓"噪点增强",本质上是在去噪推理的初始阶段保留更高的噪声强度,强制模型在更大的探索空间中进行细节生成,从而丰富纹理表现,但代价是可能引入轻微的颗粒感。
-
Boogu:侧重设计领域,可视为知名设计模型IDL的简化版,在文字编辑、文本生成和提示词遵从度上表现出色。Boogu的高遵从度特性来源于其训练数据的构成——设计领域数据集通常包含大量图文强对应的样本(如海报、信息图),这使模型在对齐文字与视觉元素方面具备天然优势。
-
Qwen Image(通义千问广告绘图):阿里推出的文生图模型,质量较为稳定,刚发布时颇为惊艳,随着更强模型涌现,如今表现中规中矩。Qwen Image的技术路线与阿里多模态大模型体系深度绑定,在中文提示词的语义理解上具备一定优势,但在国际化美学风格的内化程度上相对保守。
-
AIO模型:在Qwen Image基础上做了破限处理,并对画面质量进行优化。所谓"破限",是指通过移除安全过滤组件或使用无审查数据集继续训练,解除内容限制的技术手段,是开源社区二次开发生态的典型产物。破限操作通常会带来两面性:一方面内容自由度提升,另一方面若继续训练的数据质量参差不齐,可能导致部分风格的泛化能力下降,这在一定程度上解释了AIO在吉卜力风格测试中失败的原因。
-
DMD:发布以来热度持续,生成质量和美感在线,尤其擅长生成真实感人物。DMD(Distilled Model Diffusion)类模型通常通过对抗蒸馏(Adversarial Distillation)技术训练,能够以极少的采样步骤(甚至单步)生成高质量图像,推理速度相较标准扩散模型有数量级的提升。
-
Z Image:基于原模型的破限版优化,支持NSFW内容生成,同步对画面质量进行了提升。
-
Flux2 Clean(F2K):黑森林基于Flux2推出的小型化版本。黑森林实验室由前Stability AI核心团队创立,其Flux系列采用了Transformer与扩散模型融合的Flow Matching架构——具体而言,Flux以多模态Transformer(MMDiT)替代了传统扩散模型中的UNet骨干网络,使文本与图像特征在每个注意力层中相互交叉融合,而非仅在Cross-Attention层单向注入,这从架构层面提升了文本语义在图像生成全过程中的影响力。F2K通过**知识蒸馏(Knowledge Distillation)**技术压缩模型体积——即用大型"教师模型"的输出指导小型"学生模型"训练——在保留强大能力的同时降低推理成本,功能全面,支持纹身图和图生图,综合效果较好。
-
锐Image(小红书版):小红书基于Z Image蒸馏训练,重点强化了文本生成能力,尤其是汉字生成。汉字笔画复杂、字形多变,是扩散模型的公认弱项,根本原因在于:扩散模型在像素空间(或潜变量空间)中通过连续的概率分布建模,对笔画结构这类需要精确离散拓扑关系的内容天然不友好,而且主流训练数据集中高质量汉字图文对的比例远低于拉丁字符。针对这一问题,需要专项数据增强(大量汉字渲染图像)和针对性损失函数设计(如加强笔画区域的重建权重)才能有效改善,这也是锐Image的核心差异化方向。
写实风格测评:Krea2一骑绝尘
在写实人物的测试中,Krea2表现最为出色。人物美感在线,姿态自然,背景中墙壁上的艺术画像、踢脚线处斑驳老化的墙面、人物投影与画面反光的呼应关系,都处理得相当到位。不过偏写实的特性导致暗色调(如黑色衣服)没能很好地体现。

其他模型各有短板:Qwen Image的人物在画面中占比过远,手指出现崩坏;AIO虽有加强,但AI感偏重;DMD陷入"万年网红脸"困境,缺少人物多元性;Flux2 Clean与Qwen Image走向两个极端——前者人物占比过大,后者过小。Z Image继承了网红脸但增加了多元性,暗色调有所体现,略带AI感。
值得一提的是,"手指崩坏"是早期扩散模型的标志性缺陷,根源在于手部结构在训练数据中的表征复杂度远高于其他人体部位——手部在不同姿态、遮挡角度下呈现出高度非线性的形变,且手指数量固定这一先验知识无法通过简单的像素级损失函数有效约束。近期模型普遍通过引入姿态估计先验(如OpenPose骨骼点)和专项手部数据增强来缓解这一问题,这也是各模型在手部细节上表现差异显著的深层原因。综合来看,写实人物生成的第一梯队是Krea2和Z Image。
吉卜力风格测评:考验模型的色彩控制力
吉卜力风格的测试完全通过提示词控制,不加LoRA,更能考验模型本体能力。LoRA(Low-Rank Adaptation)是一种参数高效微调技术,由微软研究院于2021年提出,核心思想是:预训练大模型的权重矩阵在微调过程中的更新量具有低秩特性,因此可以用两个小矩阵的乘积来近似表示权重变化量(ΔW = A×B,其中A、B的秩远小于ΔW的维度),从而将可训练参数量从数十亿压缩至数百万甚至更少。在AI绘图社区,一个针对吉卜力风格训练的LoRA文件通常仅有几十至几百MB,却能显著改变模型的风格输出倾向。刻意剥离LoRA的目的,正是测试模型在预训练阶段是否已充分内化该风格的视觉语言——包括吉卜力标志性的柔和色调、手绘质感笔触、自然环境的细腻表达——从而评估其真实的泛化能力。
这一轮暴露出不少问题:Krea2虽然美食感强,但生成吉卜力画幅时色彩过于杂乱,墙面斑驳和衣服细节"太脏",墙上阴影也显得怪异。
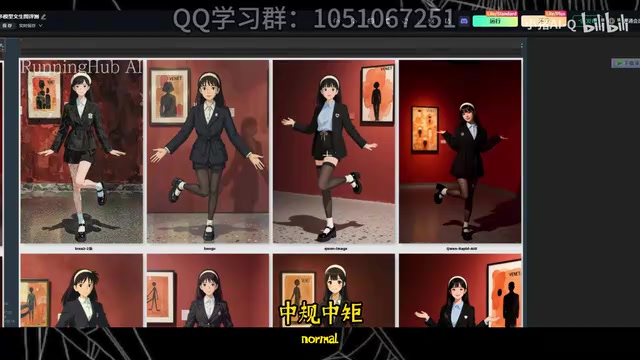
AIO直接生成失败,完全没有吉卜力风格,输出的是写实图像。这一结果从侧面印证了"破限微调"可能对模型风格泛化能力造成损伤的担忧——当继续训练的数据分布过于集中于写实或特定内容类型时,模型对动画类风格的响应能力会出现退化。表现较好的是Z Image及其变体锐Image,吉卜力风格已经体现出来,墙面正常生成,只是脸型仍是熟悉的网红脸。总体而言,吉卜力风格上Z Image系列可圈可点,Krea2中规中矩,其余模型均有明显缺陷。
3D动漫与日漫风格测评:两强争霸
在3D动漫风格中,Flux2 Clean(F2K)意外表现突出,3D效果完整呈现,背景和墙面画作都做了艺术化处理,只是略缺美感且遗漏了提示词中的部分元素。Krea2和Z Image依然稳定,前者背景做了摄影级虚化,后者整体优化到位。

Flux2 Clean在3D动漫风格上的意外优势,可能与其MMDiT架构的跨模态注意力机制有关——相比传统UNet架构,MMDiT在处理"3D渲染感"这类需要全局光照一致性的风格时,能够在更大感受野范围内协调图像不同区域的光影关系,从而产生更具立体感的输出。
到了日漫风格环节,Krea2和Z Image对其他模型形成了明显优势。Krea2在墙面红色油漆的光影、艺术画作、衣服色彩搭配上表现最舒适,唯一遗憾是遗漏了提示词中的部分元素,画面略显死板。Z Image生成的画面则与真实日本漫画风格高度贴近,网红脸再次登场但效果依然优秀。
文生图模型选型建议
综合四大风格的表现,给出以下选型参考:
- 写实人物:首选Krea2,Z Image次之
- 吉卜力风格:Z Image及锐Image变体表现最佳
- 3D动漫:Flux2 Clean有惊喜,Krea2/Z Image整体稳定
- 日漫风格:首选Krea2,若不考虑人物多样性可选Z Image
需要特别注意的是,提示词遵从度与美学生成能力之间存在天然权衡:高遵从度模型(如Qwen Image、Boogu)倾向于将每个关键词都落实为视觉元素,可能导致画面拥挤;而高美感模型(如Krea2)则会对提示词进行"艺术再诠释",主动取舍元素以获得更舒适的构图——这正是Krea2整体美感领先,却对提示词的遵从度存在一定缺失的根本原因。
这一权衡在技术层面有其深刻根源:高遵从度模型通常采用更强的分类器自由引导(CFG,Classifier-Free Guidance)权重,将条件生成的方向大幅放大,确保每个语义元素都被"强制"映射到图像区域;而高美感模型则倾向于使用较低的CFG值,给予模型更大的自由度去做构图层面的"审美决策",其训练数据中也往往包含更多经过人类审美筛选的高质量图像,形成了隐式的美学先验。
实际选型时需根据创作目的权衡:商业设计场景对元素完整性要求高,应选Boogu等高遵从度模型;艺术创作场景则可优先考虑美感表现。
此次测评存在一定局限:所有模型均使用官方原始工作流,未做优化。实际使用中,通过双彩加噪、风格控制等复杂工作流,普通模型也能跑出更好的画面。但评测模型应回归本体能力,结果仅作选型参考。对AI绘图用户而言,与其盲目追新,不如根据自身风格需求,选择最匹配的模型。
相关推荐

用n8n打造AI每日新闻简报:20秒告别信息过载
一位 YouTube 创作者用 n8n 搭建 AI 每日新闻简报工作流:RSS 抓取路透社头条、AI 去标题党并摘要、写入 Supabase 数据库、推送 Telegram,20 秒读完全球资讯。本文拆解其实现逻辑与借鉴价值。

Zapier、Make、n8n实测对比:同一AI工作流三次翻车
Zapier、Make、n8n三款自动化工具实测对比:用同一个AI线索分类工作流各搭一遍,三者全部翻车。深度拆解搭建时间、运行速度、计费逻辑及各自的静默失败陷阱,帮你选对AI自动化平台。

用n8n搭建AI内容引擎:全自动运营Facebook主页实战
一位创作者用开源工具n8n搭建AI内容引擎,实现Facebook主页全自动运营:选题、写作、配图、审核、发布五步流水线,287篇写出238篇发布,拆解其人机分工逻辑与可复制性。