AI Agent生态周报:Harness插件爆发、GLM 5.3护栏争议与Stripe收购OpenRouter

一周AI圈信息差速览
八月第三周的AI圈延续了近期的高密度节奏——从Agent工具生态的插件化爆发,到大模型跑分与安全护栏的博弈,再到支付巨头Stripe以75亿美元收购OpenRouter的重磅交易。本文基于B站UP主Orin的一周信息梳理,结合行业背景对三条核心事件做深度解读。
这三件事看似分散,实则勾勒出同一条主线:AI Agent正在从概念走向真实的工作流与商业结算,而围绕它的工具、模型与基础设施,正在快速重构。
Harness插件生态爆发:Agent工具平台拼的不是数量而是留存
本周最热闹的动向是围绕Harness的插件生态爆发。OpenRouter发放优惠券鼓励开发者参与,PTC和Cordis随后放出实测,社区很快整理出多达11个插件,DSH(DeepSeek广告 Harness)甚至被称作「Agent Store」。
这波繁荣背后,是Agent工具生态从「单点能力」向「插件化平台」演进的信号。当一个Harness能够挂载各类插件,它就不再只是一个调用入口,而更像一个可扩展的应用商店。这也是为什么它被冠以「Agent Store」之名。
要理解这一趋势的意义,需要先明确Harness在AI语境中的定位。Harness本质上是一种可编排、可扩展的Agent运行框架,开发者可以在其中挂载各类功能插件(如代码执行、数据检索、API调用等),让Agent具备更丰富的工具使用能力。这一模式与早期Chrome扩展商店、Slack App Directory的思路一脉相承——通过标准化的接口协议,降低第三方开发者的接入成本,从而快速扩充平台能力。所谓「Agent Store」的类比,本质上是将移动互联网时代App Store的平台逻辑复刻到AI Agent领域:平台提供运行环境和分发渠道,开发者贡献垂直能力,用户按需组合。回顾历史,这一模式的成败往往取决于「飞轮效应」能否启动——足够多的开发者带来足够丰富的插件,吸引足够多的用户,用户活跃度反过来激励更多开发者加入。Chrome Web Store在2010年上线初期也经历了类似的「数量爆发→质量筛选→头部集中」的过程,最终形成了少数高频扩展(如广告拦截、密码管理)占据绝大多数安装量的稳态格局。Harness生态能否走出同样的成熟曲线,取决于接下来几个月是否能涌现出真正嵌入开发者日常工作流的「杀手级插件」。
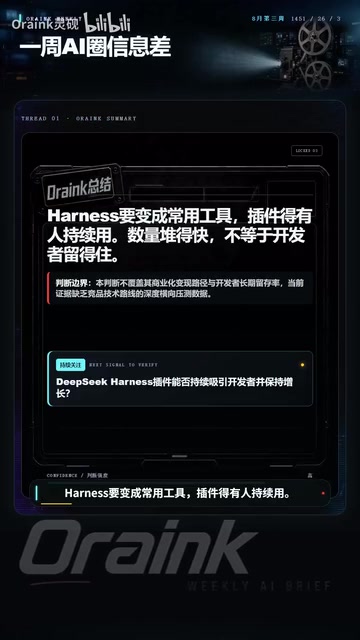
不过,Orin在总结中给出了一个冷静的判断:Harness要真正变成常用工具,关键不在插件数量堆得多快,而在于是否有人持续使用。数量堆得快,不等于开发者留得住。插件生态的繁荣往往伴随大量「一次性」尝鲜,真正决定平台命运的是长期活跃度与留存率。历史经验也印证了这一点:插件生态的存活率通常呈幂律分布,少数高频插件占据绝大多数使用量,长尾插件的活跃度往往在上线数周后急剧衰减。以Slack App Directory为例,其上架应用数一度超过2400个,但据第三方统计,超过60%的应用月活跃安装量不足100,真正被团队日常使用的集中在Jira、Google Drive、GitHub等不到50款核心集成上。这种「二八分化」几乎是所有插件生态的宿命,AI Agent工具平台也不太可能例外。
这一观察对整个AI工具赛道都有借鉴意义:在Agent工具爆发期,评价一个生态的健康程度,不应只看SKU数量,而要看核心插件的复用频率和开发者的持续投入。
GLM 5.3跑分亮眼,安全护栏过度敏感成最大短板
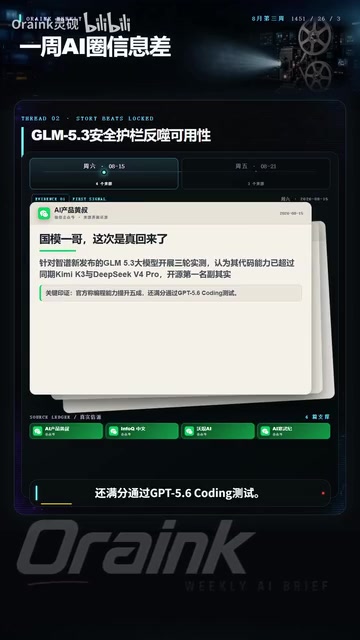
第二条值得关注的是新模型GLM 5.3。官方宣称其编程能力提升五成,并满分通过了GPT 5.6 Coding测试,随后进入Code Arena的网页开发前沿榜单。
然而社区实测却发现了一个尴尬的问题:在处理正常任务时,模型也会被安全护栏(safety guardrail)意外截断。也就是说,明明是合理的开发请求,却因过度敏感的安全策略被拦下,导致任务无法完成。
这里有必要解释一下安全护栏的技术原理。安全护栏是大模型部署中的一套过滤与拦截机制,通常包括输入端的提示词分类器(prompt classifier)和输出端的内容审核模型(output moderator)。其工作原理是在模型推理的前后各设置一道「检查站」:输入端判断用户请求是否涉及敏感主题(如暴力、违法、隐私泄露等),输出端则检测生成内容是否符合安全策略。从技术实现上看,这些分类器通常是独立于主模型的轻量级分类网络,经过专门的安全数据集训练,对输入文本进行多标签分类(如「暴力」「色情」「自残」「非法活动」等维度),每个维度输出一个概率值,当任一维度超过预设阈值时即触发拦截。部分厂商还会在模型的RLHF(基于人类反馈的强化学习)阶段直接将安全偏好注入模型权重,使模型「从内部」倾向于拒绝敏感请求,这就是所谓的「内置护栏」。
问题在于,这些分类器本身也是概率模型,存在误报(false positive)和漏报(false negative)的权衡。当厂商为了降低风险将阈值设得过低时,就会出现GLM 5.3遇到的「过度拦截」问题——正常的代码生成、技术讨论甚至包含特定关键词的合法请求都可能被误判为危险内容。这在行业中被称为「对齐税」(alignment tax),即为了安全对齐而牺牲的可用性。这个概念由AI安全研究者Paul Christiano等人提出,用于描述安全措施对模型实际效用的折损。对齐税的大小取决于护栏的精度——理想状态是实现「精准拦截」(只拦真正有害的内容),但现实中由于语言的模糊性和上下文依赖性,完美的精度几乎不可能达到。OpenAI在GPT-4发布初期就因护栏过严遭到开发者大量投诉,随后在多个版本中逐步放宽了拒绝策略;Anthropic的Claude系列也经历了从「极度保守」到「适度放开」的多轮调整。这始终是一个需要持续优化而非一次性解决的工程问题,本质上是在「降低社会风险」与「保障用户体验」之间寻找动态平衡点。
Orin对此的总结相当到位:
榜单证明他会做护栏,但决定他能不能「做完」——开发者真正接近工作流时,后者更重要。
这句话点出了当前大模型评测与实际落地之间的鸿沟。跑分能证明模型「有能力」,但过于保守的安全策略会直接破坏工作流的连贯性。对开发者而言,一个动不动就中断任务的模型,即便跑分再高,也难以成为日常生产力工具。这也引出了一个更深层的行业议题:现有的模型评测体系(如HumanEval、MBPP等编程基准测试,以及各类Arena排行榜)几乎都只衡量模型的「能力上限」,而很少将「任务完成率」——即在真实工作流中从头到尾不被中断地完成一个完整任务的概率——纳入评估维度。未来,随着Agent应用场景的深入,「端到端任务完成率」很可能成为比跑分更有实际参考价值的指标。
如何在安全与可用性之间找到平衡,是所有大模型厂商都要面对的长期课题。GLM 5.3的案例提醒我们:安全护栏的「精度」和模型能力的「上限」同样重要。
Stripe 75亿美元收购OpenRouter:布局Agent时代的支付基础设施
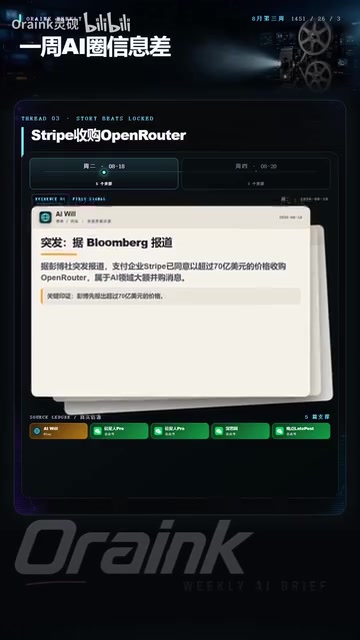
本周最重磅的交易,是支付巨头Stripe以75亿美元收购OpenRouter。彭博社率先爆出超过70亿美元的价格,两天后交易正式落地。
这个估值增长速度令人咋舌——OpenRouter在今年5月的估值还只有13亿美元,短短几个月便翻了近六倍。这一估值飙升的背后,是OpenRouter平台调用量的爆发式增长:随着AI Agent应用在2024-2025年间快速普及,越来越多的开发者和企业选择通过OpenRouter作为统一入口来管理多模型调用,其日均API请求量据报道已达到数亿级别,月度交易流水增长迅猛。在风险投资市场对AI基础设施层的估值逻辑中,这类「管道型」资产往往享有高溢价——因为它们的收入与整个AI调用量呈线性甚至超线性增长关系,具备极强的网络效应和切换成本。
OpenRouter作为一个统一的大模型路由与调用平台,允许开发者通过单一接口访问多家厂商的模型。具体来说,OpenRouter是一个统一的大模型API路由平台,开发者只需接入一个API端点,就能在OpenAI GPT系列、Anthropic Claude、Google Gemini、Meta Llama、Mistral等数十家模型之间灵活切换。其核心价值在于「抽象层」——将不同厂商各异的API格式、计费方式、速率限制统一封装,让下游应用无需为对接每一家模型单独编写适配代码。从技术角度看,OpenRouter本质上是一个「模型网关」(Model Gateway),类似于云计算领域的API Gateway(如AWS API Gateway、Kong等),但专门针对大模型推理场景做了优化,包括自动fallback(某模型不可用时自动切换备选)、成本优化路由(根据任务复杂度选择性价比最高的模型)、以及用量计量与账单聚合。在实际使用中,开发者可以设置路由策略,例如「优先使用Claude 3.5 Sonnet,若响应延迟超过3秒则自动降级到GPT-4o-mini」,或者「对简单查询使用最便宜的模型,对复杂推理使用最强模型」。正是这种「每一次调用都经过我」的管道位置,使其天然具备了结算基础设施的属性——它不仅知道每次调用用了哪个模型、消耗了多少token,还能精确计算每次调用的成本并向用户收费。
Stripe为何愿意为它开出如此高价?Orin给出了一个精准的解读:
Stripe看重的是每次模型调用背后的「选择」和「结算」。
支付巨头为何要收购模型路由平台?
这里的逻辑非常清晰。随着AI Agent的普及,未来越来越多的模型调用将由Agent「替用户」发起——模型由谁来选、调用费用如何计算和结算,都将成为核心命题。
对于Stripe这样一家支付基础设施公司来说,OpenRouter恰好卡在了「模型选择」与「调用结算」这两个关键环节的交汇点。值得一提的是,Stripe成立于2010年,由Patrick Collison和John Collison兄弟在爱尔兰创立,是全球最大的在线支付基础设施公司之一,估值曾在2021年超过950亿美元(此后经历估值回调,2024年内部估值约700亿美元)。其核心业务是为互联网企业提供支付处理、订阅管理、发票、欺诈检测等全套金融基础设施,客户包括Amazon、Google、Shopify、Zoom等科技巨头以及数百万中小企业。Stripe的技术护城河在于其开发者友好的API设计——几行代码即可完成支付集成——以及覆盖135个国家、支持超过135种货币的全球结算网络。
Stripe此前已通过推出Billing(订阅计费)和Usage-based Billing(按用量计费)等产品,深度布局SaaS和API经济的结算层。2022年,Stripe推出的Meter Events API专门用于支持按用量计费的商业模式,允许SaaS厂商实时追踪客户的API调用次数、存储用量等消费指标并自动生成账单。收购OpenRouter的逻辑,正是将这一能力延伸到AI Agent经济:当Agent自主决策调用哪个模型、调用多少次、每次消耗多少token时,这些微粒度的消费行为需要一套实时、精确、可审计的结算系统。传统的按月订阅模式无法适配这种「每秒可能产生数十笔微交易」的场景——想象一个企业级Agent在执行复杂任务时,可能在几分钟内依次调用Claude进行推理、GPT-4o生成代码、Gemini分析图像,每次调用消耗不同数量的token、对应不同的单价,最终需要将这些碎片化的消费汇总为一张统一账单。而Stripe+OpenRouter的组合恰好能同时解决「调用路由」和「实时结算」两个问题,构建起Agent时代的支付管道。
当Agent经济成型,每一次模型调用都是一笔微支付,而谁掌握了路由与结算,谁就掌握了AI时代的「收银台」。这一格局与移动互联网时代Apple和Google通过应用商店掌控30%「苹果税」的逻辑如出一辙——只不过在Agent时代,「税」的征收点从应用下载转移到了每一次模型调用。
这笔收购本质上是Stripe对「Agent支付基础设施」的提前卡位,也从侧面印证了行业对Agent商业化前景的强烈预期。
AI技术生态快讯:流量迁移、小模型下沉与多模态补齐
除了上述三件大事,本周还有几条值得留意的快讯:
-
Stack Overflow问答流量持续被AI分流。Stack Overflow自2008年由Jeff Atwood和Joel Spolsky创立以来,一直是全球开发者最核心的技术问答社区,巅峰时期月活跃访问量超过1亿,累计收录超过5800万个问答对,几乎覆盖了所有主流编程语言和技术框架的常见问题。但自2023年ChatGPT等大模型广泛普及后,其流量出现了显著且持续的下滑,据Similarweb等第三方数据监测平台估算,2023年至2025年间Stack Overflow的月访问量下降了约35%-50%,部分技术类关键词的搜索点击已有超过30%被AI工具截流。这一趋势的本质是「知识获取路径的压缩」——开发者过去需要在Google中搜索问题、点击进入Stack Overflow、浏览多个回答、对比评分和评论、最终自行综合判断出最佳方案,整个过程可能需要10-30分钟;现在只需在ChatGPT或GitHub Copilot Chat中提出问题,即可在数秒内获得针对具体上下文的直接可用答案。这对Stack Overflow的商业模式(主要依赖广告收入和Stack Overflow for Teams企业版订阅)构成根本性挑战,也促使其在2023年推出了OverflowAI等AI辅助功能试图转型,包括AI搜索摘要和对话式问答体验。然而讽刺的是,Stack Overflow上的高质量问答数据本身正是训练这些AI模型的重要语料来源之一,形成了一个「数据反哺AI、AI反噬数据源」的循环。技术知识的获取方式正在被彻底改写。
-
小模型能力持续下沉至端侧设备。一款约27B参数的模型在笔记本上跑出了52分的成绩,说明高质量模型正在向端侧和轻量化设备渗透,本地部署的门槛越来越低。端侧部署(On-device Deployment)的核心技术挑战在于如何在有限的内存和算力条件下保持模型质量。近年来,量化技术(Quantization,如GPTQ、AWQ、GGUF等格式将模型权重从16位浮点数压缩到4位甚至2位整数,在模型大小缩减75%-87.5%的同时仅损失极少的推理质量)、知识蒸馏(Knowledge Distillation,用大模型的输出作为「教师信号」训练小模型,使小模型学到大模型的推理模式)和稀疏化(Sparsity,通过剪枝去掉模型中对输出贡献最小的参数连接)等技术的成熟,使得27B参数级别的模型能够在消费级笔记本的16-32GB内存中流畅运行。以GGUF格式的4bit量化为例,一个27B参数模型的原始大小约为54GB(FP16),量化后可压缩到约15GB,完全可以装入一台配备32GB内存的MacBook Pro中。Apple MLX、llama.cpp、Ollama等开源框架进一步降低了本地推理的工程门槛——Ollama甚至做到了「一条命令即可下载并运行模型」的极简体验。端侧部署的意义不仅在于降低成本(无需支付云端API调用费用)和延迟(本地推理通常在数百毫秒内即可开始生成),更在于数据隐私——敏感的代码、商业文档和个人数据无需上传云端即可完成AI处理,这对金融、医疗、法律等数据合规要求严格的行业尤为重要。
-
DeepSeek发布首个视觉模型,开始补齐Agent的视觉能力。DeepSeek此前以纯文本大模型闻名,尤其是其DeepSeek-V2/V3系列凭借创新的MoE(Mixture of Experts,混合专家)架构,在代码生成和数学推理任务上表现突出,且推理成本远低于同级别竞品,迅速赢得了开源社区和企业用户的广泛采用。此次发布视觉模型,标志着其向多模态(Multimodal)方向迈出的关键一步。多模态模型能够同时理解和处理文本、图像甚至视频输入,这一能力通常通过在语言模型基础上接入视觉编码器(如ViT、SigLIP等)实现,将图像信息转化为语言模型能理解的token序列。对Agent应用而言,视觉能力至关重要——一个只能处理文本的Agent无法「看到」用户的屏幕截图来诊断UI问题、读取图表中的数据趋势、识别网页上的按钮和表单元素,也无法理解用户上传的文档扫描件或手写笔记。在Agent自动化操作的场景中(如RPA流程自动化、网页操作、文档理解),视觉能力是从「能对话」进化为「能操作」的前提条件。OpenAI的GPT-4o(原生多模态,文本、图像、音频统一处理)、Google的Gemini(天然多模态架构)和Anthropic的Claude 3系列(支持图像理解和分析)都已具备成熟的多模态能力。DeepSeek此举是在补齐国产开源模型在这一关键维度上的短板,为Agent「看得懂界面、看得懂图像」奠定基础,也使其在与闭源模型的竞争中不再存在明显的能力盲区。
结语:AI Agent正在从工具层走向基础设施层
综合本周三条主线,可以看到一个清晰的趋势:AI Agent正在经历从「工具尝鲜」到「工作流落地」再到「商业结算」的完整链路演进。
Harness的插件繁荣代表工具层的扩张,GLM 5.3的护栏困境揭示了落地层的挑战,而Stripe收购OpenRouter则标志着基础设施与商业结算层的成型。当这三层同时加速,Agent经济的雏形已然显现。
对开发者和从业者而言,值得持续关注的不是短期的跑分与插件数量,而是哪些工具能沉淀为长期工作流、哪些基础设施能真正承接Agent时代的调用与结算。
相关推荐

Arsaze:把Cursor的Tab补全带到视频剪辑
Arsaze是一款AI原生视频编辑器,把Cursor的Tab补全交互带入视频剪辑:剪一次按Tab即可重复风格,还能删除转录文字来裁剪片段。本文解析其工作流、账户限制与评测结论。

GitHub会消亡吗?开源维护者倦怠与AI时代的协作危机
Lex Fridman播客讨论开源维护者倦怠与GitHub的困境:海量拉取请求压垮核心维护者,AI加剧代码膨胀。文章以数学期刊审稿与庞加莱猜想验证为类比,剖析知识生产中验证环节为何必须刻意缓慢,以及开源社区如何避免维护者退出的失败模式。

别再做千篇一律的AI网站:3个工具让编码Agent脱胎换骨
介绍三个提升AI编码Agent能力的工具:FFmpeg skill让Claude Code和Cursor本地剪辑视频,Hallmark用50套设计主题解决AI网站千篇一律的问题,Jailbreaks提供25种以上模型的提示词配置,并分析技能化扩展的共同逻辑。