Bagging方法实现CoT长度无关的最优学习
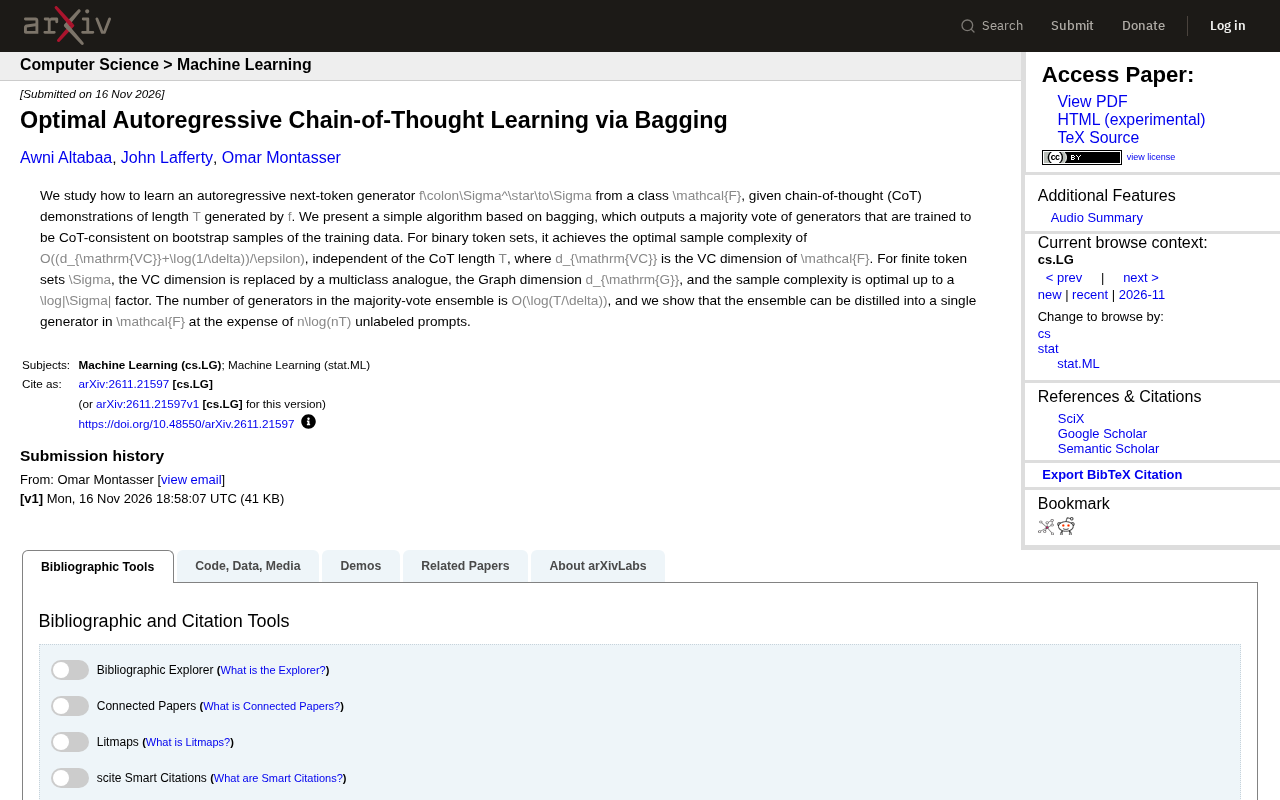
Bagging算法实现CoT学习最优样本复杂度,且与推理长度无关。
论文《Optimal Autoregressive Chain-of-Thought Learning via Bagging》研究如何从CoT演示中高效学习自回归生成器,提出一种简洁的Bagging算法:对训练数据Bootstrap采样,训练多个CoT一致的生成器,再通过多数投票集成。理论证明,在二值token集下样本复杂度为O((d_VC+log(1/δ))/ε),完全独立于CoT长度T,达到最优;有限token集下以Graph维替代VC维,仅多一个log|Σ|因子。集成规模仅O(log(T/δ)),且可通过n log(nT)个无标签提示蒸馏回假设类内的单一生成器。该工作首次证明CoT学习无需样本量随推理长度增长,为高效CoT训练提供了理论依据。
引言:CoT学习的样本复杂度难题
思维链(Chain-of-Thought, CoT)已成为提升大模型推理能力的关键技术,但如何高效地从CoT演示中学习自回归生成器,一直是理论研究的难点。近期一篇论文《Optimal Autoregressive Chain-of-Thought Learning via Bagging》提出了一种基于Bagging的简单算法,在理论上实现了与CoT长度无关的最优样本复杂度。本文将深入解读该研究的核心贡献、技术细节与潜在影响。
问题设定与核心挑战
论文研究的问题形式化如下:给定由未知自回归下一词生成器 $f\colon\Sigma^\star\to\Sigma$ 生成的、长度为 $T$ 的CoT演示,如何从假设类 $\mathcal{F}$ 中学习一个逼近 $f$ 的生成器?这里的CoT演示是指一系列中间推理步骤,最终导向答案。
关键挑战在于,传统学习理论通常要求样本量随序列长度 $T$ 增长,因为长序列意味着更多的依赖关系。然而,CoT的本质是逐步推理,理论上可能不需要随 $T$ 线性增长的样本。论文的目标是设计算法,使样本复杂度对 $T$ 的依赖最小化。
VC维(Vapnik-Chervonenkis Dimension) 是统计学习理论中衡量假设类复杂度的一个核心概念。直观地说,它表示假设类能够“打散”(shatter)的最大样本点集的大小:若对某个大小为 (d) 的点集,假设类中的函数能实现所有 (2^d) 种可能的标注方式,则称该点集被假设类打散,而VC维就是能被假设类打散的最大点集大小。在样本复杂度分析中,VC维刻画了学习问题本身的“难度”:假设类越复杂(VC维越大),需要的样本就越多。本文中样本复杂度 (O((d_{\mathrm{VC}}+\log(1/\delta))/\epsilon)) 正是经典VC理论形式的体现,其中 (\epsilon) 是需要达到的泛化误差精度,(\delta) 是失败概率。理解这一点有助于把握为什么该界被称为“最优”——它匹配了已知的下界。
Bagging算法:简单而有效
作者提出的算法异常简洁:对训练数据进行Bootstrap采样,在每个采样上训练一个与CoT一致的生成器(即该生成器在给定前缀时能正确预测下一个token),最后通过多数投票集成这些生成器。
算法输出的是 $O(\log(T/\delta))$ 个生成器的多数投票,其中 $\delta$ 是置信参数。这个数量仅随 $T$ 对数增长,远低于训练单个生成器所需的样本量。集成规模的对数依赖意味着,即使CoT长度很大,所需的基学习器数量也保持在可控范围内。
Bootstrap采样与Bagging 是统计学习中经典的集成技术。Bootstrap指从原始训练集中有放回地随机抽取与原数据集等大小的样本,从而生成多个略有差异的训练子集。Bagging(Bootstrap Aggregating)则是在每个Bootstrap子集上训练一个基学习器,再通过投票(分类)或平均(回归)将它们的预测集成起来。Bagging的主要作用是降低方差、提升稳定性,其理论分析通常依赖于基学习器的独立性和投票的集中效应。本文的巧妙之处在于将Bagging用于序列生成:每个基学习器只需在给定前缀时正确预测下一个token(即CoT一致),而多数投票的集中效应使得集成规模仅需随 (T) 对数增长,从而绕开了序列长度对样本量的线性依赖。
理论保证:最优样本复杂度
论文的核心理论结果针对二值token集 $\Sigma={0,1}$:Bagging算法的样本复杂度为 $O((d_{\mathrm{VC}}+\log(1/\delta))/\epsilon)$,其中 $d_{\mathrm{VC}}$ 是假设类 $\mathcal{F}$ 的VC维,$\epsilon$ 是精度参数。说个细节,该复杂度完全独立于CoT长度 $T$,这是首个达到此最优界的结果(下界匹配,因此最优)。
对于有限token集,VC维被替换为多分类类比——Graph维 $d_{\mathrm{G}}$,样本复杂度为 $\tilde{O}((d_{\mathrm{G}}+\log(1/\delta))/\epsilon)$,仅比最优界多一个 $\log|\Sigma|$ 因子。这一扩展使得算法适用于实际的自然语言词表。
Graph维(Graph Dimension,有时记作 (d_{\mathrm{G}})) 是多分类学习理论中对VC维的自然推广,由Natarajan等人提出。对于标签数大于2的多分类问题,VC维的原始定义不再直接适用,Graph维通过允许多分类假设类对样本进行“图式”打散来刻画其表达能力:它考虑假设类能否实现某种有向图结构所定义的标注模式。与二分类情形类似,Graph维也出现在多分类样本复杂度的紧界中,通常形式为 (\tilde{O}(d_{\mathrm{G}}/\epsilon))。本文用Graph维替换VC维,将二值token集的最优结果推广到有限token集,代价仅多一个 (\log|\Sigma|) 因子,这正是多分类学习理论中的经典现象。
从集成到单一生成器:蒸馏
集成模型虽好,但部署时往往希望返回单一模型。论文证明,多数投票集成可以通过蒸馏压缩回假设类 $\mathcal{F}$ 中的单个生成器,代价是需要 $n\log(nT)$ 个无标签提示(unlabeled prompts),其中 $n$ 是集成中生成器的数量。这一蒸馏过程保证了最终模型仍在原假设类内,维持了理论一致性。
蒸馏所需的无标签数据在实际中容易获取(如未标注文本),因此该步骤具有实践可行性。
蒸馏(Distillation) 最初由Hinton等人提出,指让一个较小的“学生”模型学习一个较大“教师”模型(或集成模型)的输出分布,从而在部署时用单一模型近似集成的效果。在本文的设定中,教师是 (n) 个CoT一致生成器的多数投票集成,学生则被限制在原假设类 (\mathcal{F}) 内。由于学生必须属于 (\mathcal{F}),蒸馏过程本质上是在假设类内寻找一个能模仿多数投票行为的生成器。论文证明,这可以通过在 (n\log(nT)) 个无标签提示上查询集成的预测并训练学生来完成。这类需要无标签数据、仅在教师输出上学习的方式常被称为“无标签蒸馏”或“查询式学习”,其优点是无需额外标注,只需能向教师提问,因而在实际中数据获取成本很低。
意义与展望
这项工作的贡献在于揭示了CoT学习并不需要样本量随推理长度增长,Bagging作为一种简单的集成方法即可达到理论最优。这为设计更高效的CoT训练算法提供了理论依据,也暗示了集成方法在序列生成任务中的潜力。
未来方向可能包括:将分析扩展到更复杂的生成模型(如Transformer),研究自适应CoT长度下的学习,以及探索Bagging与其他正则化技术的结合。
结论
《Optimal Autoregressive Chain-of-Thought Learning via Bagging》通过严谨的理论分析,证明了Bagging算法在CoT学习中的最优性,样本复杂度与CoT长度无关,且集成可蒸馏为单一模型。这一结果为CoT的高效学习提供了新视角,值得AI理论研究者与 practitioners 关注。
相关推荐
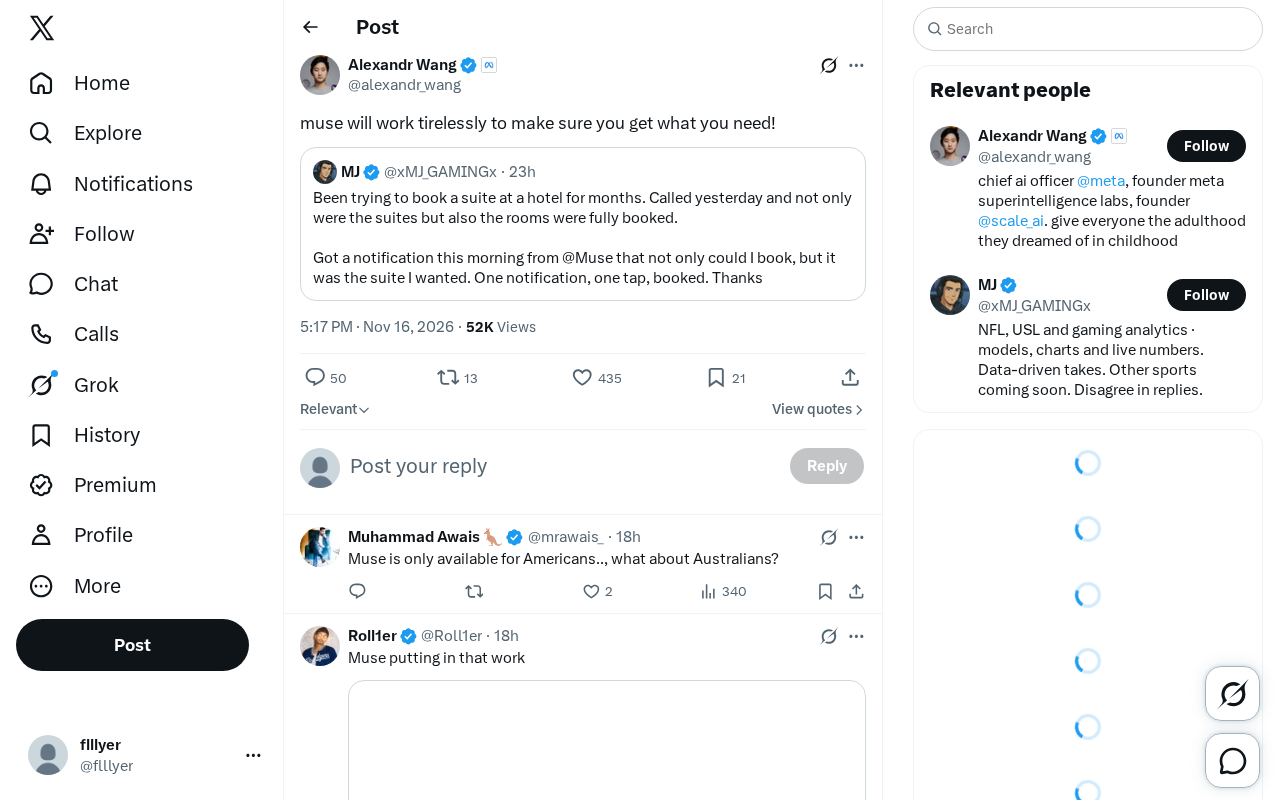
Muse:不遗余力满足你需求的AI助手?
一条推文揭示了名为Muse的AI助手,承诺不遗余力满足用户需求。本文分析其可能的产品定位、与现有AI助手的潜在差异,并指出信息缺口。

腾讯混元3D-Muse:一张图生成带灵魂的3D数字人
腾讯混元开源3D-Muse,一张图即可生成可驱动、带表情与口型同步的3D数字人,支持导出Blender、Unity,大幅降低虚拟形象制作门槛。
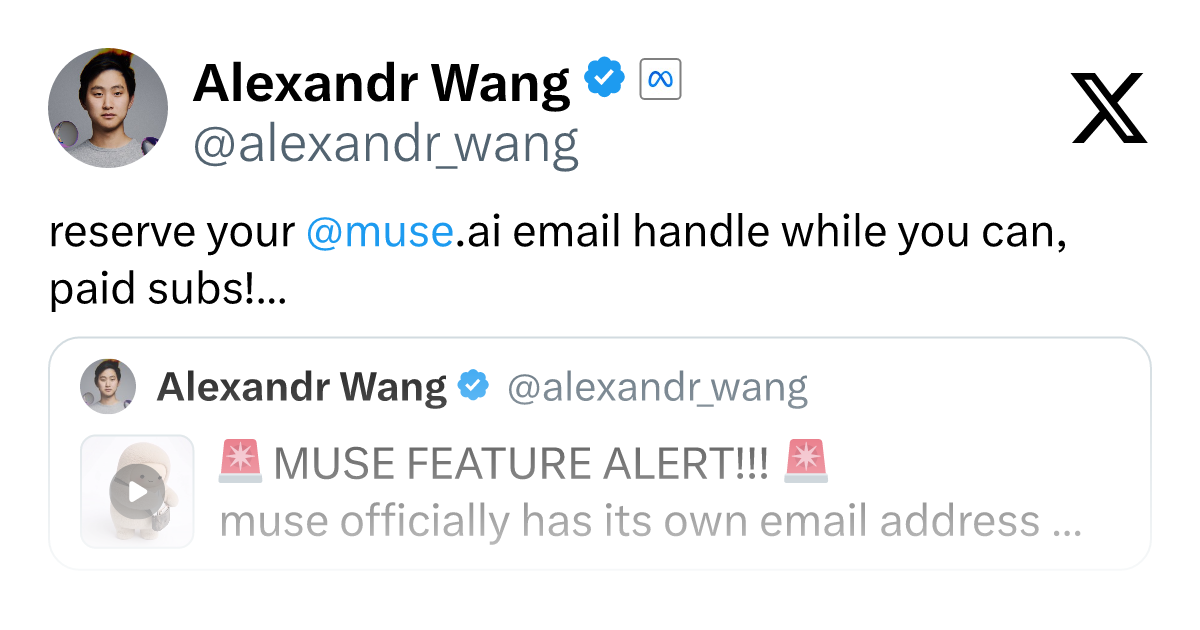
Muse.ai推出专属邮箱域名,付费用户可抢先锁定
Muse.ai为付费订阅用户推出@muse.ai专属邮箱后缀,可抢先锁定用户名,官方确认该功能即将向包括免费计划在内的所有用户开放。