百度ERNIE 5.5 Flash Base开源:280B参数仅激活14B,百万上下文

百度开源ERNIE 5.5 Flash Base,参数亮眼但Base定位与渠道缺席致反响平淡。
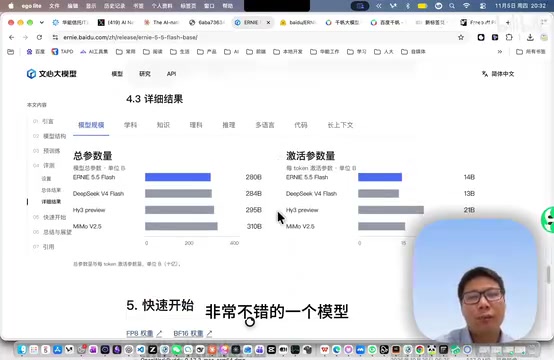
百度正式开源文心大模型 ERNIE 5.5 Flash Base,采用 MoE 架构,总参数 280B、激活参数 14B,支持百万级上下文,定位企业私有化部署的甜点区间。但本次放出的是未做偏好对齐与强化学习的 Base 模型,百度官网与千帆平台均未上线,开源与可用性明显脱节。官方对比对象为 DeepSeek V4.1 Flash 及上一代 Base 模型,被 B 站 UP 主昆蓬 talk 认为反映信心有限。模型仅支持纯文本,速度与能力均无突出记忆点,社区讨论热度远低于其他厂商。UP 主还意外发现文心一言官网的免费 AI 工作台功能完整,可作为轻量任务备选。
百度文心大模型ERNIE 5.5 Flash Base近日正式开源,280B总参数、14B激活参数、支持百万级上下文,这些规格在300B参数档位中相当少见。但模型发布后社区反应冷淡,甚至不少博主都懒得介绍。据B站UP主昆蓬talk的实测,百度官方渠道尚未上线该模型,开源与可用之间存在明显脱节。
开源规格:280B总参数、14B激活,定位企业部署甜点
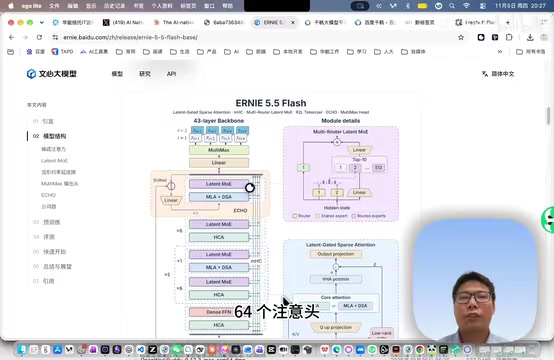
据昆蓬talk介绍,ERNIE 5.5 Flash Base采用43层Transformer架构、64个注意力头,基于33.5T token训练完成。模型使用MLA与HCA混合注意力架构,KV Cache部分采用MLA做优化,大部分层仍为HCA结构。训练阶段最常用128K数据,但模型支持高达百万级(原文表述为“一兆”)的上下文长度。
这一参数配置被UP主视为企业私有化部署的“甜点”区间——280B左右总参数、14B激活,推理成本相比更大规模模型显著下降。目前同档位可选的模型不多,蚂蚁也有类似参数规模的产品,但整体上300B以内的优秀模型仍然稀缺。
模型已在Hugging Face开源,支持vLLM和SGLang推理部署,提供FP8与BF16两种格式,暂未提供NVFP4格式。不过UP主直言“大概率没有人去部署”,原因在于模型定位与可用性都存在疑问。
总参数与激活参数(MoE架构):总参数指模型全部权重数量,激活参数指单次前向推理中实际参与计算的参数量。ERNIE 5.5 Flash Base 的 280B 总参数配合 14B 激活,说明它采用了混合专家(MoE,Mixture of Experts)架构:每个 token 只路由到部分专家网络,因此实际计算量接近一个 14B 稠密模型,但模型容量由 280B 参数共同承载。这种设计的好处是推理 FLOPs 和显存带宽压力显著低于同总参数的稠密模型,同时保留较大的知识容量,因而被视为私有化部署中兼顾效果与成本的折中方案。
MLA 与 HCA 混合注意力:MLA(Multi-head Latent Attention)通过低秩压缩 KV Cache,大幅降低长上下文推理时的显存占用,是 DeepSeek广告 系列带火的结构;HCA 通常指一种分层或分块的高效注意力变体,用于在多数层中以较低开销处理长序列。两者混合意味着模型只在部分层使用 MLA 做 KV Cache 优化,其余层保持较轻量的注意力结构,目的是在百万级上下文下控制显存与延迟。
Base模型定位:能跑分但不能直接用
本次开源的是Base模型,即仅完成基础训练、尚未进行偏好对齐与强化学习等后训练的版本。这解释了为什么百度没有把它放到文心一言官网或千帆平台上供用户直接调用——它本身还不适合终端用户使用。
但UP主批评的点在于流程倒置:其他厂商通常先开放访问、让社区用一段时间再开源,百度则直接把Base模型扔出来,官网和千帆平台都找不到入口。他在视频中吐槽“百度开源的一个模型反正我自己都不用”,认为这反映出对开源社区习惯的不熟悉。
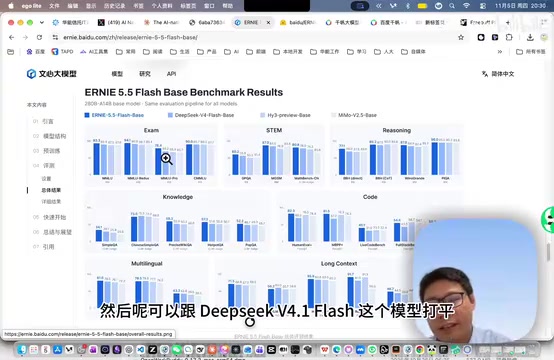
从官方放出的对比图看,ERNIE 5.5 Flash Base对标的是DeepSeek V4.1 Flash,以及自家ERNIE 3的Base版本、MIMO 2.5的Base版本等“上一代”模型。UP主认为这种对比方式说明团队信心有限——理论上新模型应该对标当前最强模型,不过也可以解读为务实。至少从纸面看,280B总参、14B激活的模型能与DeepSeek V4.1 Flash抗衡,已属中规中矩。
Base 模型与后训练:大模型训练通常分为预训练(Base)与后训练(Post-training)两阶段。Base 模型只经过下一 token 预测的自监督训练,掌握语言与知识分布,但不会遵循指令、不会拒绝有害请求,输出风格也不稳定。后训练包括监督微调(SFT)、偏好对齐(如 RLHF/DPO)和强化学习(如 RLVR),正是这些步骤把 Base 模型变成可直接对话的产品。因此 Base 模型适合作为研究基线或二次微调的起点,普通用户直接调用往往体验很差,这也是百度未将其放上官网和千帆平台的合理解释。
Hugging Face 与 vLLM/SGLang:Hugging Face 是主流的模型权重托管社区,开源即意味着权重可公开下载。vLLM 和 SGLang 是两个高吞吐推理框架,前者以 PagedAttention 著称,后者擅长结构化输出与前缀缓存。支持这两者意味着企业可以用标准工具链部署,但 FP8/BF16 两种精度格式也决定了部署至少需要数十 GB 级显存,实际门槛并不低。
能力边界:纯文本、缺多模态,速度与能力均无突出亮点
ERNIE 5.5 Flash Base与对标的DeepSeek V4.1 Flash一样,目前仅支持纯文本,暂不支持图片等多模态输入。UP主评价这个模型“没有什么特点”:要么快、要么能力强,两者都不突出就很难打。
他以阶跃星辰为例——阶跃3.5推理速度能做到每秒六七百token,到阶跃5时速度降到一百以内,能力却没有明显提升。这种“既不快又不强”的处境,正是新模型需要避免的。
从社区热度看,大模型领域的马太效应明显,百度模型的宣传资料和讨论量都远少于其他厂商。UP主在视频中多次表达惋惜,希望百度能做出更好的模型参与开源竞争。
意外发现:百度免费AI工作台功能完整
虽然模型本身没能体验上,UP主在登录文心一言官网时发现了一个免费AI工作台。据其描述,该工作台提供定时任务、技能、知识库等功能,还包含图片生成、PPT生成、应用开发、文献处理等模块,以及旅游规划、金融分析、投研、浏览器操作等场景化能力。
实测中他用浏览器操作查询了12306信息,认为整体能力可用。工作台默认可选5.1模型,切换后模型选择受限。对于不需要特别智能模型的任务,这个免费工作台是一个可尝试的选项——毕竟豆包、元宝等国内产品也提供类似能力,多一个免费选择对用户没有坏处。
小结
ERNIE 5.5 Flash Base在参数效率上做出了有意义的尝试:280B总参、14B激活、百万上下文,瞄准企业部署的甜点区间。但Base模型的定位加上官方渠道缺席,让这次开源更像一次技术交卷而非产品发布。模型能力中规中矩,缺乏速度或能力上的记忆点,社区反响平淡也在情理之中。百度能否在后续正式版本中补齐可用性短板,值得继续观察。
相关推荐

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。

trainlint:静态检查揪出不会崩溃的 ML 训练 Bug
trainlint 是一个静态检查工具,能找出不会报错的机器学习训练 bug,包括数据泄漏、eval 模式残留、softmax 与 CrossEntropyLoss 冲突等十四类问题。本文介绍其原理、验证结果与局限。