百度ERNIE 5.5 Flash Base开源,Images 2.6双版本接入API

百度放出未后训练的ERNIE 5.5 Flash Base基础权重,昇腾首日适配Kimi K31 Pro,Images 2.6双版本接入API。
本文汇总了四条AI动态。百度发布稀疏MoE模型ERNIE 5.5 Flash Base,总参数2800亿、每Token激活140亿,预训练用33.5万亿Token,支持百万Token上下文,但只提供未经中期训练和后训练的基础权重,官方对比数据显示其在MMLU Pro和HumanEvo Plus上领先DeepSeek V4 FlashBase,不过成绩为单方面披露。昇腾在Kimi K31 Pro权重公布当天完成首日推理适配,覆盖多款超节点产品,Kimi同时推进云端托管智能体服务。OpenAI Images 2.6接入API,拆为速度型Flare与质量型Sunburst两个端点。此外Google Cloud被指短暂出现GPT-6等模型名,OpenAI收购Pierre的关联猜测仍无官方依据。
百度放出ERNIE 5.5 Flash Base:2800亿参数的"半成品"
百度发布了稀疏混合专家模型ERNIE 5.5 Flash Base。总参数2800亿,每个Token激活140亿参数,预训练使用了33.5万亿Token,支持最长百万Token上下文。
值得玩味的是百度这次放出的定位——官方明确表示,这是尚未经过中期训练和后训练的基础模型权重。换句话说,开发者拿到的是一块未经雕琢的"地基",可以在同一起点上按自己的需求继续训练。这种策略在开源社区并不常见,但对想要深度定制的研究团队来说,反而比一个"成品"更有吸引力。
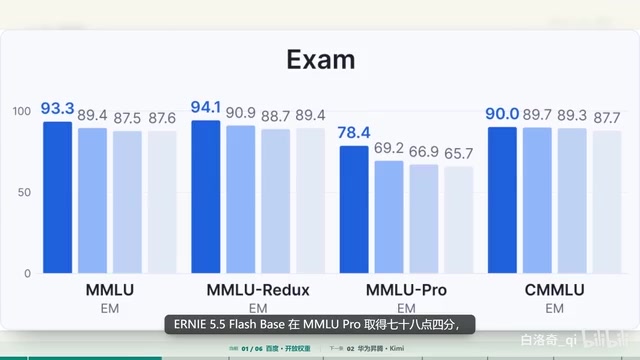
百度公布了基础模型对比数据:在MMLU Pro上,ERNIE 5.5 Flash Base取得78.4分,DeepSeek广告 V4 FlashBase为69.2分;在HumanEvo Plus编程测试中,百度模型得到82.3分,对比模型为69.5分。需要注意,图表采用同一套评测流程,但成绩来自百度官方——第三方复现之前,这组数字应视为单方面披露。
**稀疏混合专家(MoE)**是一种让模型在推理时只激活部分参数的架构:模型由多个“专家”子网络加一个路由网络组成,每个 Token 经路由选择少数专家参与计算。因此“总参数”反映模型容量,“激活参数”才决定单次推理的算力开销。ERNIE 5.5 Flash Base 的 2800 亿总参数中每 Token 只激活 140 亿,正是靠这种稀疏性在保持大容量的同时压低推理成本。代价是显存占用仍按总参数计,且路由负载均衡、专家并行通信都会增加工程复杂度。
中期训练与后训练是当前大模型训练流水线的两个阶段:中期训练通常指预训练之后、用高质量语料做继续预训练或上下文长度扩展;后训练则包括监督微调、RLHF/偏好对齐等,使模型具备指令遵循和安全行为。只放出预训练权重意味着模型尚未对齐,直接对话效果可能很差,但对需要自建领域对齐流程的团队而言,起点更干净、可定制空间更大。
昇腾首日适配Kimi K31 Pro,云端Agent服务同步推进
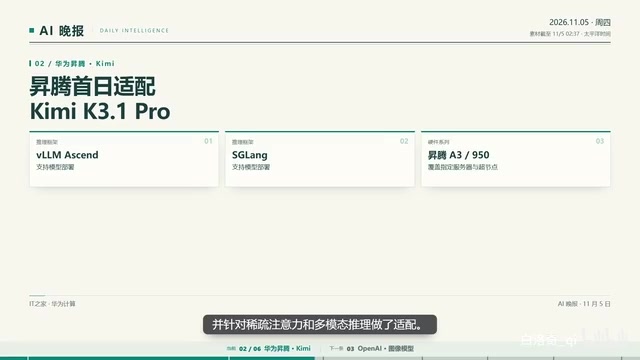
据IT之家援引华为计算消息,Kimi K31 Pro完整权重公布当天,昇腾基于VLLM Ascend和SGLang完成了首日推理适配,支持Atlas 800 A3、Atlas 900 III SuperPod和昇腾950超节点系列部署,并针对稀疏注意力和多模态推理做了专门适配。
首日适配的意义在于生态响应速度。模型权重公开与硬件推理跑通之间的时间差,直接决定了开发者能否第一时间在国产算力上验证模型。
Kimi还在推进Hosted Agents——把智能体运行环境作为云端服务提供,支持长时间任务和多智能体协作,帮助企业省去自行搭建沙箱和基础设施的工作。这项服务此前已面向企业介绍过,如今进一步落地。
VLLM Ascend 与 SGLang 是两条主流的大模型推理服务路线:vLLM 以 PagedAttention 和连续批处理著称,Ascend 版本是其面向昇腾 NPU 的硬件后端移植;SGLang 则以 RadixAttention 前缀缓存和结构化生成见长。“首日适配”指的是把新模型的权重、算子与并行切分策略在推理框架和特定硬件上跑通并达到可用性能,通常需要处理算子缺失、精度对齐和通信拓扑等问题,因此时间差是衡量硬件生态成熟度的直接指标。
Hosted Agents(托管智能体服务) 指厂商把智能体的运行环境作为云服务提供:开发者只定义工具与任务,沙箱、会话状态、长任务调度和多智能体协同由平台负责。它解决的是智能体落地时基础设施重复建设的问题,但也把执行环境、数据边界和计费方式交到云厂商手中。
OpenAI Images 2.6进入API:Flare与Sunburst两条路线
早报提到的OpenAI Images 2.6现已接入API,官方提供Flare和Sunburst两个版本,定位截然不同:
- Flare:主打速度,低画质下最快6秒生成一张图。
- Sunburst:面向更高细节和多模态场景,强调多轮编辑的一致性。
开发者还可以使用图像标注、编辑、SVG导出以及新的复杂度参数。把速度型与质量型拆成两个端点,等于让调用方在延迟和细节之间做显式选择,而不是被动接受一个折中方案。这对批量出图的流水线和需要精细编辑的创作场景,适配逻辑完全不同。
把图像生成拆成 Flare(速度型) 与 Sunburst(质量型) 两个端点,本质是把延迟—质量的权衡显式暴露给调用方。对批量出图流水线而言,单张耗时直接决定吞吐和成本,低画质快速出图可用于草稿筛选、缩略图或 A/B 素材;对需要精细编辑的场景,多轮编辑的一致性(同一主体、风格、构图在多次修改后保持稳定)比单张画质更关键,这通常依赖更强的指令跟随与图像条件控制能力。显式分端点也让定价、限流和重试策略可以按场景分别设计。
Google Cloud闪现神秘模型名,OpenAI收购再起波澜
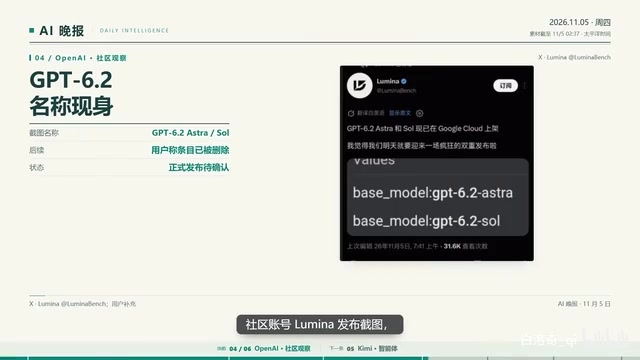
社区账号Lumina发布截图,称Google Cloud上出现过GPT-6、True、Astra和Sol的模型名称。有用户补充称,这些条目随后被删除。
这些名称是否代表正式发布,目前仍待确认。模型名称的短暂出现可能来自内部配置泄露,也可能是测试条目误上架,在没有官方说明前,任何解读都只是猜测。
另一条线索来自OpenAI:官方此前宣布收购开发工具公司Pierre,交易仍需满足交割条件。围绕社区此前流传的类GPT表述,有网友发现Pierre联合创始人的账号名恰好与之呼应,并猜测两者有关联。需要强调,这只是社区解读,没有官方依据。
几点观察
百度选择放出未后训练的基础权重,把"对齐"和"微调"的主动权交给社区,这种姿态比单纯刷榜更值得关注——前提是第三方能复现那组评测分数。昇腾在Kimi新权重公布当天完成适配,说明国产硬件生态的跟进节奏正在加快。而Images 2.6的双版本设计,则反映出图像生成API正在从"一个模型打天下"走向按场景分层的产品思路。至于Google Cloud的神秘命名和OpenAI的收购八卦,在官方确认之前,都只能算茶余饭后的谈资。
相关推荐

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。

trainlint:静态检查揪出不会崩溃的 ML 训练 Bug
trainlint 是一个静态检查工具,能找出不会报错的机器学习训练 bug,包括数据泄漏、eval 模式残留、softmax 与 CrossEntropyLoss 冲突等十四类问题。本文介绍其原理、验证结果与局限。