百度ERNIE 5.5 Flash发布:280B参数挑战DeepSeek与GLM
百度ERNIE 5.5 Flash发布,多家厂商同期更新模型与协作功能
百度发布ERNIE 5.5 Flash Preview,采用280B总参数、14B激活参数的MoE架构,支持100万上下文,多数基准成绩优于DeepSeek V4.1 Flash和GLM 5.3 Flash,部分领先HY4,已在千帆开放API并将在11月25日前开放权重,官方称其为后训练的中间版本。匿名上线的QDAC揭晓为Quant4 Max Preview,世界知识与编码能力提升,已在Coder全系上线并限时两折。阿里开源QuantCode 1.0,提供可嵌入的Agent运行机座;MiniMax开源H3 Image,10秒生成4K图像、支持16张参考图。此外,豆包接入Cdream 5.5,Claude推送三款协作功能并发放免费额度重置,OpenAI、谷歌与马斯克也各自披露新进展。
百度正式发布新一代模型ERNIE 5.5 Flash Preview,这款基于此前开源BASE模型后训练而来的模型,总参数280B、激活参数14B,支持100万上下文窗口。从基准测试成绩看,它在同参数规模中表现优秀,多数成绩强于DeepSeek V4.1 Flash和GLM 5.3 Flash,对比刚发布的HY4模型也有部分领先。官方强调该模型兼顾智能水平与推理效率,且只是后训练的中间版本,未来还将发布优化后的版本。目前已在百度千帆平台开放API服务,同时支持一款开源模型,并将在11月25日前开放模型权重。
280B参数下的效率平衡
ERNIE 5.5 Flash的核心卖点在于参数规模与推理效率的折中。280B总参数、14B激活参数的MoE架构,意味着模型在保持较大知识容量的同时,单次推理只调用一小部分参数,从而控制成本。100万上下文窗口则让它能处理长文档、代码库级别的输入。官方将其定位为"兼顾智能水平和推理效率",并明确这是后训练的中间版本——这种坦诚的版本说明,反而让开发者对后续优化版本有更明确的预期。
在竞争维度上,ERNIE 5.5 Flash的基准成绩多数优于DeepSeek广告 V4.1 Flash和GLM 5.3 Flash,部分指标领先HY4。这说明国内大模型在Flash/轻量级产品线上的竞争已经进入白热化,各家都在用MoE架构争夺"性价比"标签。对开发者而言,多一个可选的API服务商,意味着在成本与效果之间有了更多议价空间。
MoE(混合专家)架构是理解本文参数表述的关键。传统稠密模型每次推理都会激活全部参数,而MoE把前馈网络拆成多个"专家"子网络,并配一个路由门控,对每个 token 只选择少数专家参与计算。因此"总参数"衡量模型的知识容量与显存占用,"激活参数"才决定单次推理的实际计算量。ERNIE 5.5 Flash 的 280B 总参数、14B 激活参数,意味着每次前向只动用约 5% 的参数量,这正是它在保持较大知识容量的同时压低推理成本的原因。代价是显存仍需容纳全部专家权重,且路由不均衡时容易出现专家负载倾斜,对训练与部署的工程要求更高。
100万上下文窗口指的是模型单次可接受的 token 总量上限。上下文越长,模型越能一次性消化整份长文档、完整代码仓库或多轮长对话,无需依赖外部分块检索。但长上下文并非免费:注意力计算随序列长度增长而显著上升,KV Cache 的显存占用也线性膨胀,实际可用长度往往还受部署侧显存与延迟预算约束。因此厂商标称的窗口长度通常对应特定推理配置,开发者在评估时应结合自身输入长度分布与实际吞吐、首 token 延迟一起考量,而非只看上限数字。
匿名模型QDAC揭晓:Quant4 Max Preview
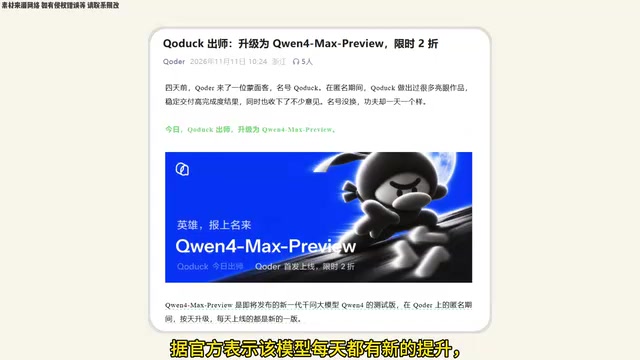
4天前在Coder匿名上线的QDAC于今日正式揭晓,真实身份为Quant4 Max Preview,基于QDAC升级而来。官方表示该模型每天都有新的提升,此前QDAC无法完成的任务,如今值得用Quant4 Max Preview再试一遍。
新模型在世界知识与编码能力上有显著提升,但尚未披露详细基准测试情况和模型信息,参数规模暂时未知。目前已在Coder全系列产品中首发上线,更新Coder至最新版即可使用,并开启限时两折优惠,折扣系数为0.1,与Quant3.8 Flash处于同一价位。匿名上线再揭晓身份,已成为大模型厂商测试真实用户反馈的常见手法——在无品牌光环的情况下,模型表现更能反映真实能力。
匿名竞技场(anonymous arena)测试是大模型厂商常用的一种评估手法:模型以随机代号上线,用户在不被告知厂商与型号的情况下对比两个模型的回答并投票,最后再揭晓真实身份。由于剥离了品牌光环与先验预期,投票结果更能反映模型在真实使用场景中的相对表现,也能收集到带真实偏好标签的对比数据,用于后续对齐与后训练。这种做法的局限在于参与者群体偏技术向、任务分布偏对话与编码,未必代表通用场景;同时匿名期的成绩也会受版本迭代影响。QDAC 这类代号在揭晓前积累的口碑,往往成为厂商正式发布时的营销素材。
阿里开源QuantCode 1.0与MiniMax图像模型
阿里正式开源QuantCode 1.0版本,该版本融合Coder与QuantCode Harness,结合二者优势,为开发者提供可嵌入自身产品的Agent运行机座,相关代码已在GitHub开放。这一定位值得注意:它不只是代码模型,而是把Agent运行所需的基础设施一并开源,降低开发者构建自有Agent产品的门槛。
MiniMax发布并开源图像生成模型MiniMax H3 Image,衍生自H3模型,支持文生图、图像参考和图像编辑,10秒内即可生成一张4K图像。官方称生成速度可达市面主流水平的5倍,指令遵循能力和图像生成质量也为开源模型中最强,最多支持16张参考图,同时提供标准版与高速版两款模型。模型权重已在HuggingFace开放下载,并通过MiniMax开放平台、MiniMax Code和海螺等产品提供图像生成服务。
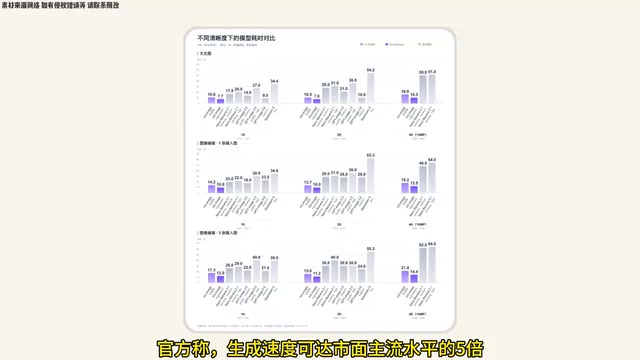
开源图像模型在速度与质量上同时对标闭源产品,说明开源阵营的竞争焦点正从"能用"转向"好用"。16张参考图的上限,对需要多图一致性的商业设计场景有实际价值。
**Agent Harness(智能体运行机座)**指包裹在模型之外、负责驱动智能体循环的那层工程框架:它管理工具调用与函数签名、维护对话与任务状态、执行多步规划、处理重试与错误恢复、控制上下文裁剪与记忆读写,并落实权限与沙箱边界。同一模型配上不同的 harness,实际任务完成率可能差异巨大,因此 harness 常被视为智能体产品的核心竞争力之一。阿里把 Coder 与 QuantCode Harness 一并开源,等于把"模型能力 + 运行时骨架"整体交给开发者,使其能直接嵌入自有产品而无需从零搭建调度、工具协议与状态管理,显著降低了构建 Agent 产品的起步成本。
豆包与Claude的协作功能更新
豆包图片设计能力升级,正式接入全新图像创作模型Cdream 5.5。据豆包官方介绍,该模型重点带来多轮编辑、透明素材生成以及皮肤纹理更自然三项表现,目前已在豆包图片设计中上线。多轮编辑和透明素材生成,瞄准的是电商与设计工作流中的高频痛点。
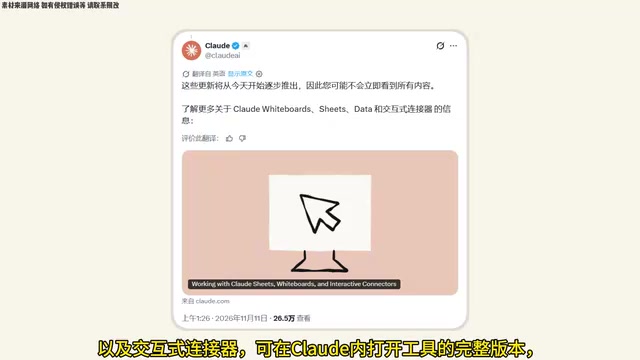
Claude今日起陆续推送三款协作功能:Whiteboards、Sheets和Data。分别支持生成可编辑的白板、将数据整理成可讲述的看板,以及交互式连接器——可在Claude内打开工具的完整版本,直接在Adobe、Atlassian等平台里工作,用户可自己动手也可让Claude一起改。官方提醒更新分批推送,可能不会一次看到全部功能。白板和表格功能面向付费方案Beta用户开放,连接器在网页端和桌面端可用。
Claude官方还宣布向所有Pro、Max、Ultra和Team用户发放一次免费全量重置,覆盖全部模型和全部限额。官方表示近期修复了几个消耗额度超出预期的小问题,用户可在12月12日下午2点太平洋时间前任意使用。
OpenAI、谷歌与马斯克的最新动向
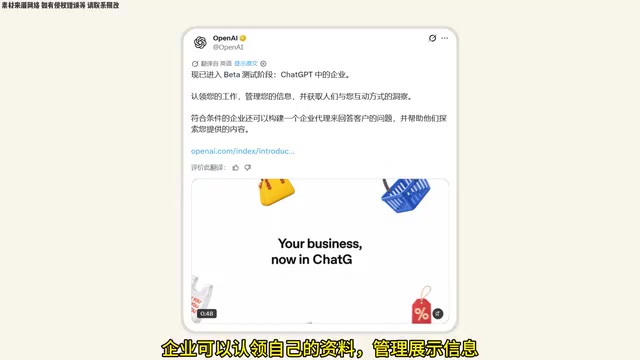
OpenAI宣布ChatGPT内的Businesses功能进入Beta测试,企业可以认领自己的资料、管理展示信息,也能看到用户的互动情况,符合条件的企业还能创建Business Agent回答客户提问,帮助客户了解所提供的服务。
Mills智能助手宣布开放独立邮箱地址,可以代表用户收发邮件,该功能已向美国和加拿大的付费订阅用户开放。谷歌Gemini团队成员Logan在社交平台表示Carbon是个好模型,但团队还在准备新东西,官方未透露新模型的名称和发布时间。马斯克透露Grok4.8已进入强化学习阶段,评测分数正在爬升,目前训练阶段已经完成监督微调,数据也做了大量清理,比起本周晚些时候面向Bot用户小范围测试。
从这一轮更新看,大模型厂商的竞争已从单纯的参数与基准分数,延伸到Agent基础设施、协作工作流和企业服务入口。百度ERNIE 5.5 Flash的发布,是这个趋势中又一个值得关注的节点。
相关推荐

Gemini 4 Neon发布:前沿智能与高效任务执行的平衡之作
Google DeepMind 发布 Gemini 4 Neon,主打前沿智能与快速端到端任务执行。本文解析其在编程、企业分析、科学推理与网络安全上的基准表现、四档思考等级、定价与安全对齐数据。

AI是全球断网元凶?NSA、FAA接连宕机背后的信任危机
NSA机密网络五天内第四起重大故障,微软称软件bug、FAA否认新AI系统有关、NSA称例行维护。参议员沃纳提出AI加速漏洞发现导致仓促修复的另一种解释,而39%美国人对AI的负面看法让信任危机浮出水面。

机器人开发者自研B-rep内核,测试达3487项
机器人开发者自研B-rep几何内核并编写3,487项测试,探讨机器人领域为何需要专用CAD工具,以及自研内核的机遇与门槛。