百万级AI Agent的真正瓶颈是分布式系统
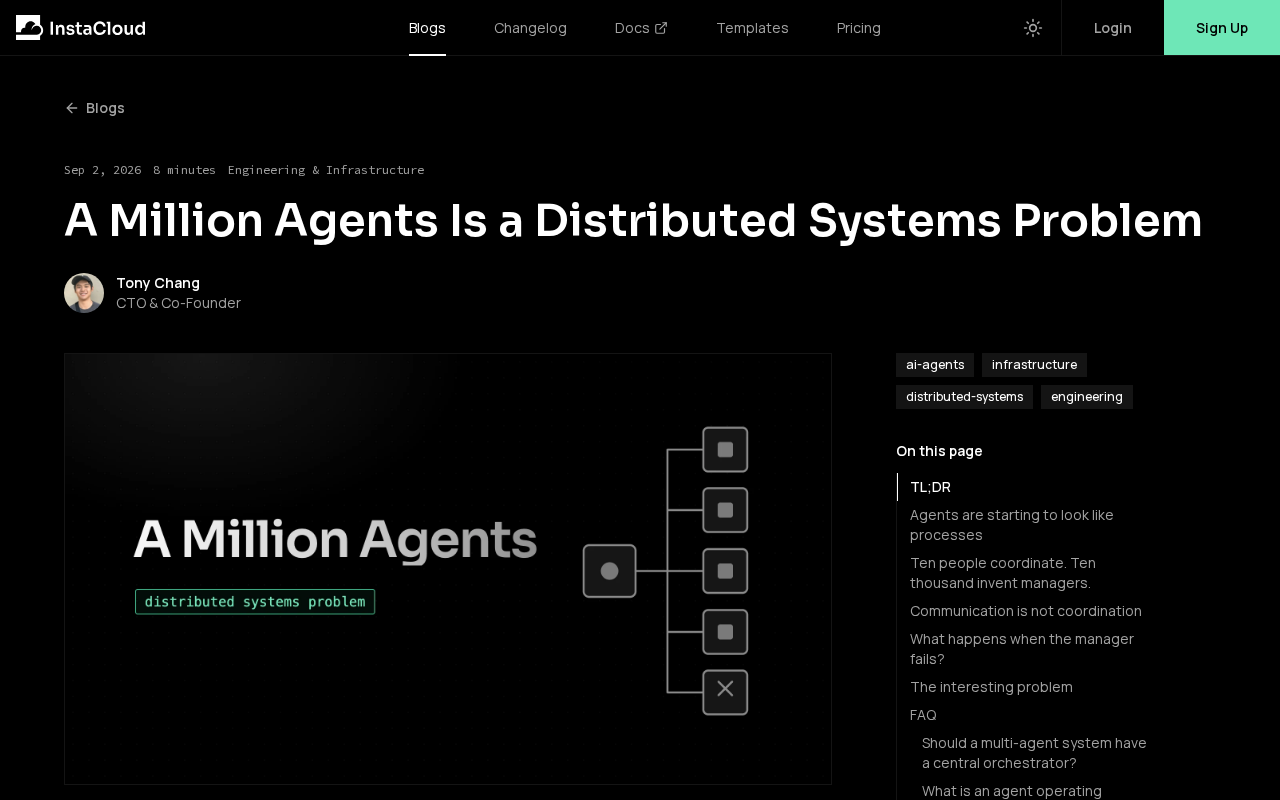
百万级AI Agent的真正挑战是分布式系统工程,而非模型智能本身。
本文围绕「百万Agent本质上是分布式系统问题」这一核心论点展开分析。当AI Agent从单体实验扩展至百万量级集群,状态一致性、资源调度与故障恢复这三大分布式系统经典难题随之浮现——它们无法通过更强的模型或更好的提示词解决,而是需要成熟的工程基础设施:快照与恢复机制、调度器、幂等重试、背压限流、可观测性追踪等。这一视角意味着构建可靠大规模Agent系统的核心能力,更接近分布式系统团队而非纯AI团队,擅长后端基础设施的工程师在Agent时代的价值可能不亚于Prompt工程师。编排层将成为规模化落地竞争的关键战场。
当Agent数量突破百万,问题的本质发生了变化
随着大语言模型驱动的自主智能体(AI Agent)从实验室走向生产环境,一个此前被忽视的工程命题正浮出水面:当系统中的Agent数量达到百万量级时,真正的挑战不再是模型能力本身,而是分布式系统的经典难题。这也正是Hacker News上「A Million Agents Is a Distributed System Problem」这一讨论的核心观点。
过去几年,行业的注意力几乎全部集中在单个Agent的推理质量、工具调用能力和记忆机制上。但当我们把视角拉高到「集群」层面,会发现Agent系统的形态与传统的微服务、消息队列、任务调度系统高度重合。换句话说,运行一百万个Agent,本质上是在运行一个高度并发、状态复杂的分布式系统。
为什么百万Agent是一个分布式系统问题
状态管理与一致性
每个Agent都携带自身的上下文、记忆和执行状态。当这些Agent需要相互协作、共享信息或访问同一份数据时,就会遇到分布式系统中最棘手的一致性问题。谁持有最新状态?如何在节点故障后恢复Agent的执行进度?这些都不是靠更强的模型能提示词能解决的,而是需要成熟的状态存储、快照与恢复机制。
调度与资源竞争
百万级Agent意味着海量的并发LLM调用。GPU推理资源有限,如何在众多Agent之间分配算力、控制并发、设置优先级,本质上是一个**调度器(Scheduler)**问题。这与Kubernetes调度Pod、数据库调度查询在思路上并无二致——只不过Agent的任务时长和资源消耗更加不可预测。
故障处理与幂等性
分布式系统的第一定律是「一切都会失败」。Agent调用外部API超时、模型返回异常、中间节点宕机都是常态。在百万规模下,即使单个Agent的失败率极低,绝对失败数量也会非常庞大。系统必须内建重试、幂等、补偿事务等机制,否则整个Agent网络会在故障中雪崩。
**幂等性(Idempotency)**是指同一操作执行一次与执行多次产生的结果完全相同。在Agent系统中,这一属性至关重要:当网络超时导致无法确认某次工具调用是否成功时,系统需要安全地重试,而不会引发数据重复写入或副作用叠加。实现幂等性的常见手段包括为每次操作分配唯一请求ID(Idempotency Key),服务端以此去重;以及将操作设计为「设置」而非「累加」语义。**补偿事务(Compensating Transaction)**则是Saga模式的核心思想——当分布式事务的某一步骤不可回滚时,通过执行逻辑上的「反向操作」来撤销副作用,避免系统陷入不一致的中间状态。这两种机制在微服务领域已有大量成熟实践,可以直接复用到Agent编排层。
从「智能」到「工程」的思维转变
这一讨论提示了一个重要的行业趋势:Agent系统的成熟度,越来越取决于底层工程基础设施,而非单点智能。构建可靠的大规模Agent系统,团队需要的能力清单更接近一个分布式系统团队:
- 消息传递机制:Agent之间如何异步通信,是采用消息队列还是事件总线
- 可观测性:在百万Agent中定位一个异常执行链路,需要完善的追踪(tracing)和日志体系
- 背压与限流:防止某类Agent的爆发式调用拖垮整个系统
- 持久化与恢复:长周期任务的Agent需要能够断点续跑
这些恰恰是过去二十年分布式系统领域积累的成熟经验,如今可以被直接迁移到Agent架构中。
**背压(Backpressure)**是响应式系统设计中的关键概念,指下游消费者在处理能力不足时,向上游生产者主动施加压力、要求其降低发送速率的机制。在Agent系统中,若某类Agent突发大量LLM调用请求,而GPU推理服务或外部API存在吞吐上限,缺乏背压机制的系统会导致请求队列无限膨胀,最终引发全链路超时崩溃。常见的实现方式包括有界队列(队列满时阻塞生产者)、令牌桶/漏桶限流算法,以及基于信号量的并发控制。与简单的「限流」(Rate Limiting)不同,背压更强调系统各层之间的动态协商,是构建高弹性Agent调度层的基础能力之一。
对开发者和企业的启示
对于正在构建Agent产品的团队,这一视角意味着不应过早陷入「模型选型」的讨论,而应尽早规划系统架构。一个能扩展到百万Agent的系统,往往在早期就需要考虑无状态设计、水平扩展能力以及故障隔离边界。
值得思考的是,这也可能改变行业的人才结构与技术栈选择。擅长分布式系统的后端工程师,在Agent时代的价值可能不亚于Prompt工程师或模型微调专家。当Agent成为软件的基本单元,编排(orchestration)这一层将成为竞争的关键战场。
需要说明的是,本文基于Hacker News上的一则简短讨论展开分析,原始帖子讨论热度尚不高(4分、1条评论),观点更多是一种前瞻性的判断而非已被广泛验证的结论。随着Agent应用规模持续扩大,这一「分布式系统视角」是否会成为主流范式,仍有待实践检验。
编排(Orchestration)在Agent语境中,指由一个中央控制器(Orchestrator)负责决定任务分解、Agent调用顺序、结果聚合与错误处理的架构模式,与之对应的是编舞(Choreography)——各Agent仅通过事件相互触发,没有中央协调者。前者逻辑清晰、易于调试,但中央控制器本身可能成为单点瓶颈;后者天然去中心化、可扩展性更强,但复杂交互下的行为追踪极为困难。主流Agent框架(如LangGraph、Temporal、Dapr Workflow)大多提供对这两种模式的支持或混合方案。在百万Agent规模下,编排层的选型直接决定了系统的可维护性与扩展上限,是架构设计阶段最值得优先评估的决策之一。
结语
把百万Agent当作分布式系统来对待,是一次务实的认知升级。它提醒我们,AI Agent的下一个瓶颈不在模型的智能上限,而在支撑它们协同运行的工程底座。谁能把分布式系统的经验与Agent编排结合得更好,谁就更可能在规模化落地中胜出。
相关推荐
WorkBuddy上手指南:能干活的国产AI Agent怎么用
WorkBuddy(OkBuddy)是能实际干活的国产 AI Agent,可自主拆解任务、执行并交付成果。本文梳理其工作区、三种模式、六大应用场景、专家/技能/连接器/自动化四大生态,以及对比豆包的优势与使用边界。
英国的双重标准加密:安全后门争议再起
英国加密政策引发技术社区激烈讨论。“双重加密”揭示了加密后门争议的核心悖论:以公共安全之名削弱大众加密,反而损害普通用户安全。本文解析端到端加密、立法压力与科技公司的应对。
Rails World 2026 开幕主题演讲引发社区热议
Rails World 2026 开幕主题演讲视频登上 Hacker News,获 85 赞与 55 条评论。本文解读 Ruby on Rails 官方大会的意义与社区反响,探讨框架的发展方向。