白嫖Kaggle 32GB显存GPU:免费运行本地AI模型全教程
利用Kaggle免费双T4 GPU配合Ollama与Cloudflare隧道,零成本搭建可供外部客户端调用的本地大模型API服务。
本文介绍了一套完全免费的本地大模型部署方案:借助Kaggle平台提供的双NVIDIA T4 GPU(合计32GB显存、每周约30小时额度),在Notebook中安装Ollama并从Hugging Face拉取所需模型(含无审查模型,Q4/Q6量化版本均可流畅运行),再通过Cloudflare隧道将仅限本地监听的Ollama API映射为可公网访问的URL,最终填入Hermes Agent等AI客户端的自定义端点配置即可使用。操作中需注意Notebook中shell命令须加感叹号、命令需逐格执行、首次调用常超时重试即可等细节。该方案适合个人学习与模型测试,但受限于每周额度、隧道URL每次重启失效等因素,不适用于持续生产环境。
很多人想在本地跑无审查或大参数AI模型,却卡在一个现实问题上:家用GPU显存不够,模型根本加载不进去。本文根据一位B站UP主分享的实操教程,梳理一套完全免费的解决方案——借助Kaggle平台提供的双T4 GPU(合计32GB显存),配合Ollama和Cloudflare隧道,把本地模型变成任意AI客户端都能调用的API服务。
为什么选择Kaggle做免费GPU
Kaggle是Google旗下的数据科学社区,注册后完成手机号验证,即可在Notebook中启用GPU加速器。它最实用的地方在于:可以选择两块NVIDIA T4 GPU,每块16GB显存,合计32GB,且每周提供约30小时的免费使用额度。
据该教程作者的实际使用体验,这个额度在个人测试场景下相当充裕——他连续几周使用都没触及30小时上限,关键是养成用完立刻关闭Notebook的习惯,避免时长被后台空转吃掉。相比动辄按小时收费的云GPU,这套方案对预算有限的开发者和爱好者非常友好。
需要提醒的是,如果跳过手机号验证,平台通常只会分配纯CPU环境,无法满足AI模型推理的算力需求。所以验证手机号并在Notebook设置中的"加速器"里选中"GPU T4 x2"是必要前提。
NVIDIA T4是一款专为数据中心推理场景设计的GPU,基于Turing架构,单卡拥有16GB GDDR6显存和320个Tensor Core。与消费级显卡(如RTX 4090的24GB)相比,T4的显存带宽和浮点算力稍弱,但其优势在于低功耗和云端普及率极高。双T4合计32GB显存意味着可以加载参数量更大的模型——例如70B参数的模型经Q4量化后约需35-40GB显存,单T4无法胜任,而双T4则基本可以满足。量化(Quantization)是指将模型权重从32位或16位浮点数压缩为4位、6位等更低精度整数,以牺牲少量精度换取显存占用的大幅降低,Q4代表4-bit量化,Q6代表6-bit量化,精度更高但显存消耗也更大。
Kaggle Notebook的运行逻辑
Kaggle的Notebook环境和传统服务器不同,它没有一个持续开启的终端窗口,而是由一个个"代码框"(Cell)组成。每条命令需要单独放进一个代码框,点击播放按钮逐条执行。
这带来一个新手常踩的坑:在Notebook里执行shell命令时,命令前必须加感叹号 !,否则系统会把它当作Python代码处理而报错。作者反复强调了这一点——安装、拉取模型等操作都要遵守这个语法规则。
整个流程的核心思路是:Kaggle只用来做一次性环境搭建,真正的日常使用并不在这里进行。模型跑起来、隧道建好之后,所有交互都转移到Cloud Code、Hermes Agent这类外部AI客户端里完成,不再需要回到Notebook界面。
安装Ollama并拉取模型
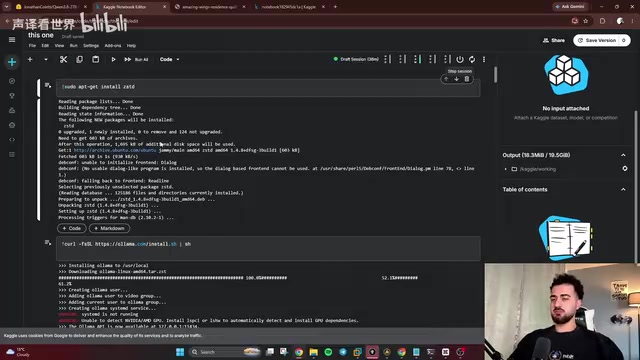
环境准备就绪后,第一步是安装Ollama依赖组件,再执行安装脚本部署Ollama本身。安装完成后不能像本地终端那样直接调用,而要运行 ollama serve 命令启动服务。
当屏幕打印出Ollama已启动、正在某个端口和本地IP上监听的提示时,说明服务运行正常。此时Ollama已经在Kaggle服务器内部提供API服务,但它只是本地监听,外部世界还无法访问。
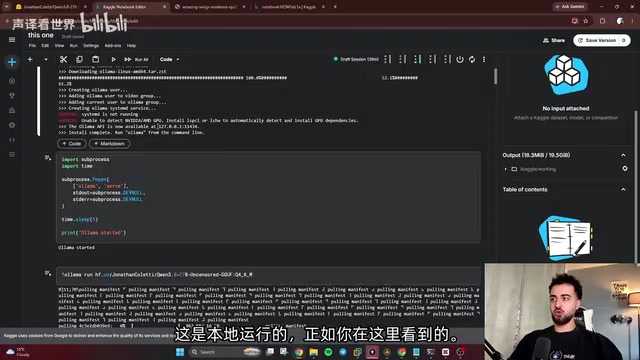
模型下载环节推荐通过Hugging Face完成。在Hugging Face筛选"文本生成"类模型时,可以直接选择"Ollama"部署方式,页面会生成对应的拉取命令。如果想找特定类型(如无审查模型),可用 other:uncensored 之类的标签筛选,再按下载量排序挑选热门模型。
作者提到,页面会用绿色对勾标注哪些量化版本能在T4 GPU上运行。他实测了Q6和Q4两种量化精度,响应都很流畅、速度很快。复制拉取命令粘贴回Notebook(记得加感叹号),就会开始逐行显示下载进度。
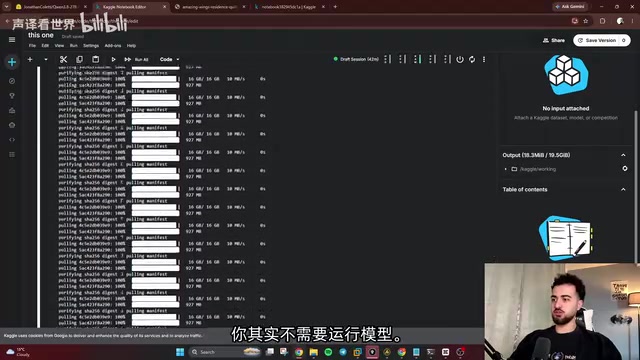
值得一提的是,模型拉取完成后它会尝试自动运行,但这一步其实可以直接停掉——因为我们不打算在Kaggle里直接对话,只需要模型文件就位即可。
Ollama是一个开源的本地大模型运行框架,核心功能是将模型的下载、加载、推理和API服务封装成统一的命令行工具。它内置了与OpenAI API兼容的HTTP接口(默认监听localhost:11434),因此绝大多数支持"自定义OpenAI端点"的客户端无需额外适配即可直接调用。Ollama支持的模型格式主要是GGUF(由llama.cpp项目定义的量化模型格式),Hugging Face上标注"Ollama"部署方式的模型均已打包为此格式。ollama serve命令启动的是后台API服务进程,而ollama run则是在服务之上再启动一个交互式对话界面——教程中拉取完成后选择停掉自动运行的run,正是因为我们只需要serve提供的API接口,不需要在Notebook里直接对话。
用Cloudflare隧道打通外网访问
这是整套方案最关键的一环。Ollama目前只在Kaggle服务器内部监听,外部客户端拿不到它的API地址。解决办法是使用Cloudflare隧道(Cloudflare Tunnel),把本地IP映射成一个可公网访问的URL。
具体操作是:先下载Cloudflare工具,解包后运行隧道命令,指定本地Ollama的端口。命令执行成功后,Cloudflare会返回一个公网URL,这个地址就是后续要填进AI客户端的"基础URL"(Base URL)。
作者建议直接点开这个URL验证,如果页面显示"Ollama is running"就说明隧道打通了。如果没有正常显示,需要回到Notebook顶部重新逐条执行命令——很多失败案例都是因为漏点了某个代码框的播放按钮。
Cloudflare Tunnel(前身为Argo Tunnel)是Cloudflare提供的一项反向代理服务。其工作原理是:在本地运行一个名为cloudflared的客户端程序,它主动向Cloudflare的边缘节点发起出站连接并建立加密隧道。由于连接方向是"由内向外",因此不需要开放任何入站端口,也不受NAT或防火墙限制。外部用户访问Cloudflare分配的公网URL时,请求经由Cloudflare边缘节点转发到本地服务。这里使用的是Cloudflare Tunnel的"快速隧道"(Quick Tunnel)模式,无需登录账号,运行命令后即时生成一个随机子域名URL,会话结束后该URL立即失效。这正是方案局限性中"每次重启都要重新配置"的根本原因——如需固定URL,则需注册Cloudflare账号并创建命名隧道。
接入AI客户端实测效果
最后一步是把服务连接到AI客户端。以Hermes Agent为例,在设置里找到"自定义端点"(Custom Endpoint)选项,填入配置信息:
- 基础URL:粘贴Cloudflare生成的公网地址,末尾务必加上
/v1 - API密钥:填
OLAMA即可(本地Ollama不校验真实密钥) - 模型:从下拉列表选择已下载的模型
配置完成后首次运行模型,很可能会遇到超时——这是正常现象,作者表示他几乎每次首跑都会超时,只要再发一次消息就能正常响应。
最让作者惊讶的对比是:他此前曾租用付费云服务器运行完全相同的模型,而这套免费的Kaggle方案响应速度反而更快。对于只是想体验本地大模型、又不愿承担云GPU费用的用户来说,这确实是一个高性价比的路径。
方案的适用场景与局限
这套方法本质上是把Kaggle的免费算力"借"来做模型推理服务,适合个人学习、模型测试和轻量使用。但也要清醒看待它的边界:
每周30小时的额度决定了它不适合7x24小时的生产环境;Cloudflare临时隧道生成的URL在会话结束后会失效,每次重启都要重新配置;Kaggle Notebook本身有闲置自动断开机制,长时间不操作可能中断服务。
换句话说,它是一个出色的"免费试验田",但不能替代真正的部署方案。如果你想尝试无审查模型、验证不同量化版本的效果,或者只是想在没有高端显卡的情况下感受一下本地大模型的能力,这套零成本方案值得一试。
相关推荐
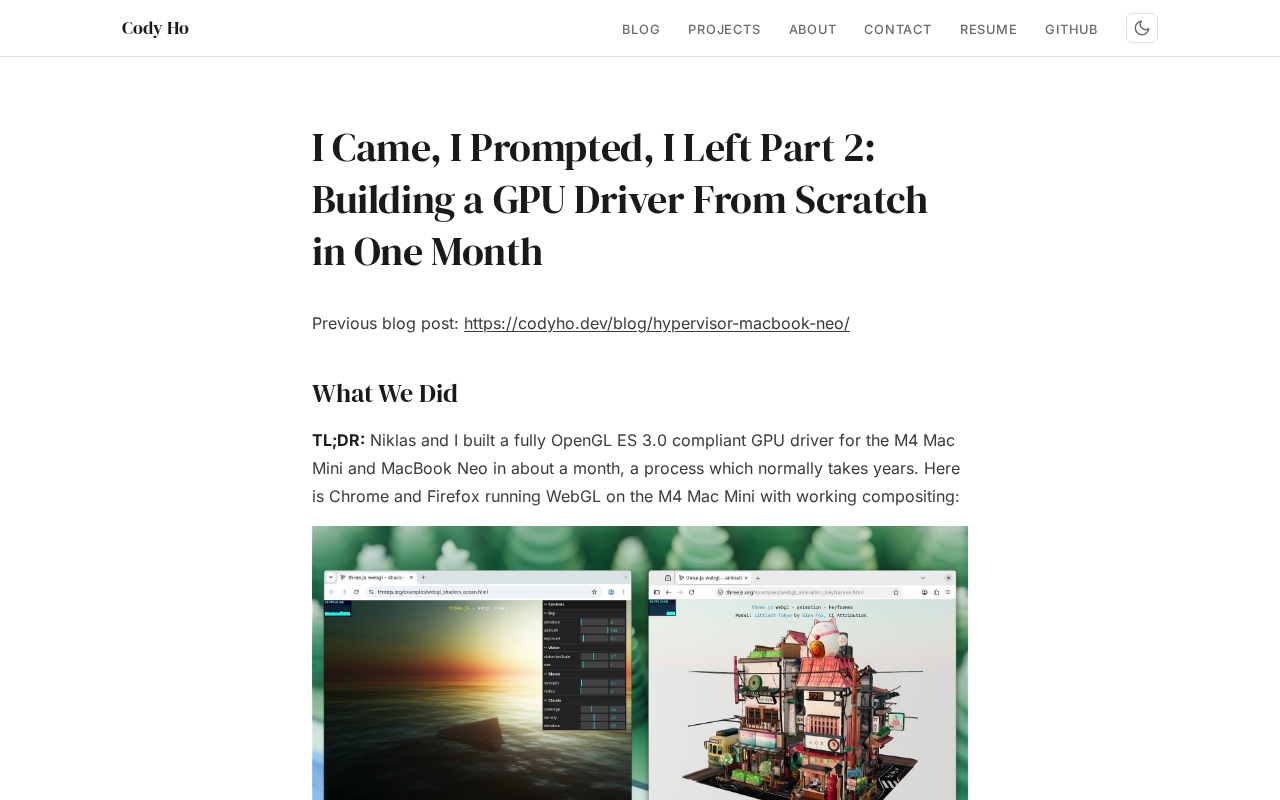
一个月为M4 Mac Mini开发Linux GPU驱动的技术挑战
开发者Cody Ho用一个月时间为M4 Mac Mini构建Linux GPU驱动,本文解析Apple Silicon GPU逆向工程的核心难点、开源社区协作价值及其对Linux硬件生态的意义。
SEO Page Builder Enhanced:让AI生成的SEO内容摆脱套路味
开发者基于octelens原版seo-page-builder打造的增强版开源工具,通过引入编辑审校、一手经验、事实与时效校验及写作风格护栏,专门解决AI生成SEO内容套路化、缺乏原创洞见的问题。
分层RAG架构研究求助:独立开发者如何叩开学术研究之门
一位独立开发者在Reddit求助信息检索领域教授,指导其分层RAG架构研究。本文剖析异构文档检索的技术背景,探讨独立AI研究者面临的学术门槛困境,并给出公开成果、社区协作等实用建议。