爆火的Hotel Lobby AI说唱梗:Wan 3.0工作流与一致性拆解

拆解Hotel Lobby AI说唱梗视频的生成管线,揭示垂直化微型工具如何通过场景约束跑赢通用视频模型。
文章以TikTok上爆火的Hotel Lobby AI说唱梗为切入点,分析了通用文生视频模型在复刻COLORS橘色影棚时面临的三大失败模式:背景漂移、肖像到视频的身份漂移、以及4秒时长截断。这些问题的根源在于通用模型缺乏特定场景的先验约束。文章指出,本地ComfyUI方案虽能产出可接受效果,但24GB显存门槛和脆弱的节点依赖管理推动了专用Web微应用的兴起——将Wan 3.0后端封装为浏览器工作流,用硬编码的影棚布光、机位和律动latent向量换取速度与一致性。生产管线分三步:源肖像预处理、参数锁定、音频同步与字幕合成。核心结论是,垂直化微型工具通过约束文化审美潜空间,正在跑赢通用提示词门户。
过去几周,如果你刷过TikTok、Instagram Reels或YouTube Shorts,大概率见过同一个视觉模板:一间被橘橙色铺满的极简单色影棚,一支悬吊的电容麦克风,两个动画化头像——从像素游戏角色到面无表情的家养宠物——轮番押韵说唱,身体随之律动。
这个梗致敬的是Quavo与Takeoff在《A COLORS SHOW》中表演《HOTEL LOBBY》的经典画面。观众看的是喜剧冲击力,但对AI工程视角而言,批量生成这类高留存视频,恰好暴露了多模态视频合成的一系列核心难题。
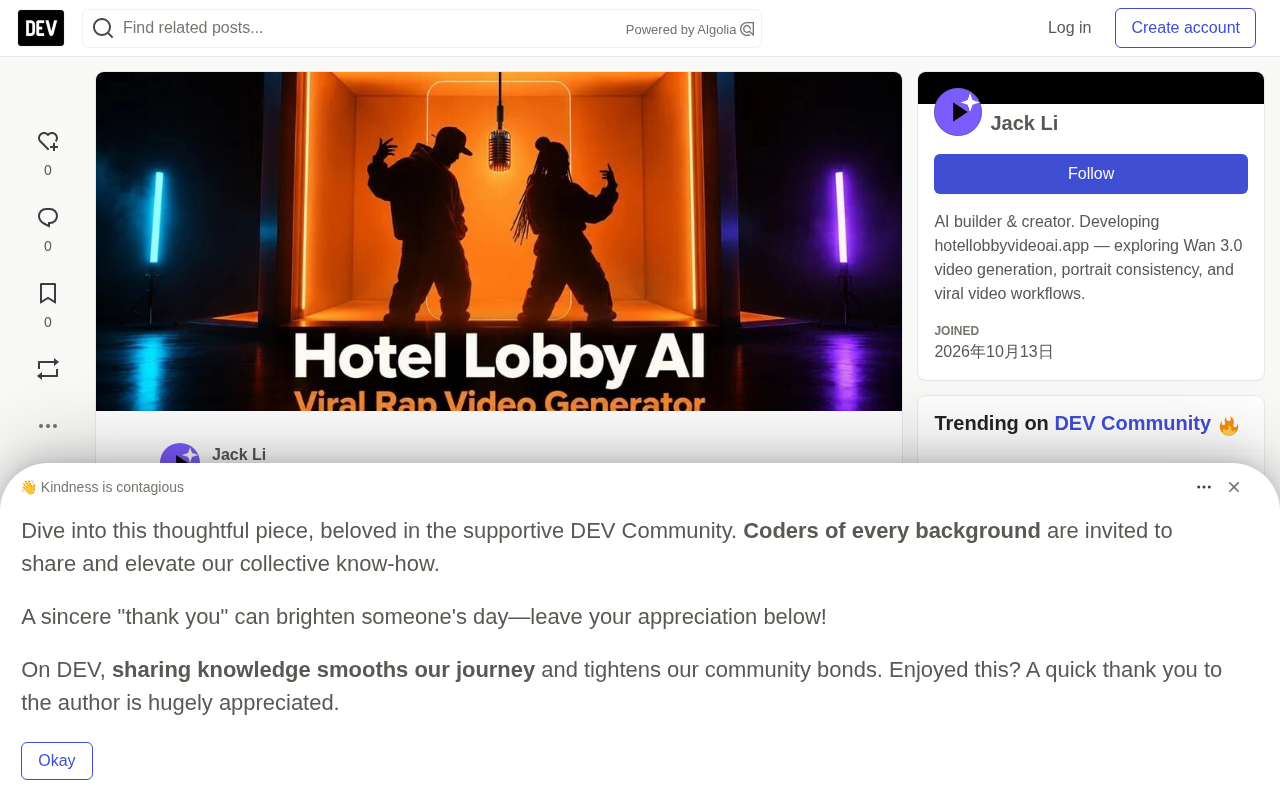
技术难点:多角色运动的时序一致性
复刻COLORS橘色影棚听起来简单,通用文生视频引擎却会在这几个环节翻车:
- 空间深度与背景漂移:通用扩散模型容易扭曲极简背景,让灯具变形,或在片段中途“幻觉”出并不存在的乐器。
- 肖像到视频的一致性:在保持面部身份的同时注入非刚性运动——说唱式的点头、肩膀律动、麦克风交接——会让通用换脸管线出现严重的恐怖谷扭曲。
- 时序连贯性:标准模型4秒的输出上限会截断说唱歌词段落,创作者需要6到15秒且唇形与身体同步稳定的连贯生成。
这三个失败模式并非孤立问题,它们共同指向一个事实:通用模型缺乏对特定场景的先验约束。背景漂移源于模型没有“固定摄影棚”的概念,身份漂移源于时序注意力对非刚性动作的不稳定建模,而时长限制则直接卡死了内容节奏。
时序一致性(Temporal Consistency) 是视频生成区别于图像生成的核心难点。图像生成只需在单帧内保证像素分布合理,而视频生成要求相邻帧之间在空间结构、身份特征、光照条件等维度保持高度稳定的连续性。在扩散模型框架下,这通常通过时序注意力层(Temporal Attention)实现:模型在去噪过程中不仅关注单帧的空间关系,还跨帧建立键值对关联,使同一角色在不同时间步上维持身份与形态的连贯。然而,当运动幅度加大——如说唱时的快速点头、肩膀律动、麦克风交接——时序注意力的建模压力急剧上升,容易出现帧间抖动、身份渐变漂移甚至局部结构崩解。这也是为什么通用视频模型在非刚性动作场景下表现远逊于静态或缓慢运动场景的根本原因。
告别沉重的本地ComfyUI堆栈
在不久之前,想拿到可接受的效果,唯一路径是编排自定义ComfyUI节点图,配合Wan 2.1或Wan 3.0等前沿视频生成模型。
但本地执行的硬件门槛极高:
- 需要24GB以上显存(NVIDIA RTX 3090/4090或云端A100实例)。
- 运动模块、深度引导、面部锁定节点之间依赖管理脆弱易碎。
- 渲染延迟高,与追求快速产出的内容创作者节奏不匹配。
为解决这一摩擦,专用微型应用开始出现。与其让创作者在臃肿的ComfyUI节点中挣扎,一些Web架构将专门的Wan 3.0后端打包成精简的浏览器工作流。
通过在服务端硬编码影棚布光、空间机位和点头律动的latent向量,这类Hotel Lobby AI生成器让用户用简单照片输入,几分钟内渲染出接近生产级的资产。这背后的取舍很明确:牺牲通用性,换取速度与一致性。对梗类内容而言,这种取舍几乎总是划算的。
Wan 3.0 是阿里通义万相团队推出的视频生成模型系列,属于扩散模型架构,支持文生视频与图生视频任务。相比前代Wan 2.1,Wan 3.0在运动幅度、时序一致性和分辨率支持上有显著提升,尤其强化了对非刚性人体动作的建模能力。该模型原生支持多种画面比例输出,并在训练中引入了更精细的时序对齐策略,使其在4秒至更长片段的生成中保持较好的帧间稳定性。在ComfyUI生态中,Wan 3.0通常作为核心采样节点,配合运动模块、深度引导、面部锁定等辅助节点协同工作,形成完整的视频合成管线。正是由于其开源可部署的特性,Wan 3.0成为当前AI梗视频生产中最主流的底座模型之一。
架构拆解:三步走向可发布产出
无论你是搭建内部梗生产线,还是部署一个“Hotel Lobby AI猫咪视频生成器”,现代生产管线都遵循三个阶段。
1. 源肖像预处理
输入干净程度决定运动保真度:
- 构图:上半身肖像让运动迁移引擎有足够的边界框空间,合成生动的肩膀律动与手势。
- 光照对齐:高对比正面光保证与哑光橘色影棚氛围无缝融合。
- 宠物适配:处理动物面部时,高精度的眼部和嘴部关键点可防止发声时出现时序模糊。
2. 参数锁定
- 画面比例:硬编码为原生9:16竖屏,避免移动平台二次裁切产生黑边。
- 帧率与分辨率:目标1080p MP4输出,在社交媒体激进压缩下仍保住面部边缘清晰度。
- 时长:6秒适合短促上头的循环梗;15秒适合多段对唱互动。
3. 音频同步与合成
视频渲染完成后:
- 导入下游剪辑工具(CapCut、Premiere或直接在TikTok内操作)。
- 将主音轨落点与主体第一个说唱动作对齐。
- 加入高对比动态字幕,驱动留存与完播率。
对生成式AI开发者的核心启示
单一梗生成器的爆发,印证了生成式媒体领域的一条关键趋势:垂直化微型工具持续跑赢通用提示词门户。
将潜空间约束在某个特定文化审美周围(比如COLORS影棚),开发者可以优化推理速度、锁定时序一致性,并在算法风向转变之前抓住巨大的用户需求。
这条路径的启示不止于梗。它说明在视频生成能力逐渐商品化的当下,差异化竞争力正在从“模型有多强”转向“场景封装有多精准”。当通用模型仍在为24GB显存和脆弱的节点依赖设置门槛时,把特定美学、特定比例、特定时长硬编码进服务端的产品,反而能更早触达真实创作者。
对想要复现这一模式的团队来说,Wan 3.0只是底座,真正的工程价值在于三层约束:输入约束(肖像预处理规范)、参数约束(比例/时长/分辨率锁定)、后处理约束(音频对齐与字幕节奏)。谁能把这三层做得既稳定又无感,谁就能在下一个梗出现时率先接住流量。
潜空间约束(Latent Space Constraint) 是垂直化视频生成工具的核心工程手段。扩散模型在去噪过程中操作的是高维潜空间向量,而非直接生成像素。通过在推理阶段对潜空间施加特定约束——例如将背景区域的latent向量硬编码为固定影棚布光模式、将角色姿态的初始噪声锚定到预设的点头律动分布——开发者可以在不重新训练模型的前提下,大幅缩小生成结果的方差。这种做法的本质是用先验知识替代通用模型的开放探索,牺牲生成多样性来换取特定场景下的速度与稳定性。对于梗类内容这种审美边界清晰、容错率低但创意方向集中的场景,潜空间约束的性价比远高于通用模型的反复调参。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。