被低估的AI Agent工具:Apify MCP让Agent抓取全网数据

Apify MCP Server 让 Agent 一行配置调用 8 万抓取工具,实测五场景仅花 $2.71。
文章指出 AI Agent 的真正瓶颈不在推理能力,而在于从 Google Maps、Instagram、TikTok、LinkedIn 等平台稳定获取真实数据,传统逐站集成方式维护成本极高。Apify 的方案是用 80,000+ 现成 actor 集中处理反封锁、代理轮换和结构化输出,并通过 MCP Server 让 Claude、Cursor、ChatGPT 等一行配置接入,Agent 可自主搜索并调用工具。作者实测五个公认难抓的场景——Google Maps 线索、Instagram 帖子、TikTok 话题、LinkedIn 招聘、YouTube 分析——总成本 $2.71;进一步将多 actor 组合成 Claude Code 中的 `/prospect` Skill 实现自动化线索生成,单次约 $0.37。文章同时提示数据完整性受源站限制、成本随规模线性增长、Skill 需迭代调优。
AI Agent 最大的短板不是推理能力,而是获取真实世界数据的能力。Google Maps、Instagram、TikTok、LinkedIn 这些网站要么封锁自动化流量,要么内容依赖滚动加载,要么三天两头改版。想让 Agent 从这些平台稳定拉数据,传统做法是逐个建集成、维护代理池、每次网站改版后重新修一遍——几周的工作量砸进去,Agent 还没开始干正事。
YouTube 科技博主在最新视频中展示了一个绕开所有麻烦的方案:Apify 的 MCP Server。一行配置接入 Claude,Agent 就能调用 Apify Store 上超过 80,000 个现成的数据抓取工具(actor),覆盖 Google Maps、Instagram、TikTok、LinkedIn、YouTube 等主流平台。
为什么 AI Agent 抓不到数据
视频中做了一个直观的对比实验。博主先让 Claude 直接查询迈阿密某社区所有牙科诊所的评分和电话,结果只拿到 10 条记录,评分缺失、电话号码不全,数据质量完全不可用。
问题不在模型本身。Claude 能搜索网页、能读取页面内容,但目标网站的设计初衷从来不是服务 AI Agent。它们封锁自动化请求、通过 JavaScript 动态加载内容、频繁调整页面结构。Agent 面对的是一个持续移动的靶子。
Apify 的思路是把这些脏活集中处理。每个 actor 是一个运行在云端的微型程序,只做一件事并做好。用户提供输入(比如“咖啡店 + 奥斯汀”),actor 在 Apify 服务器上完成抓取、代理切换、反封锁,最终返回结构化数据。计费按实际结果付费,注册即送 $5 额度。
反封锁(anti-bot)与代理池是网页抓取领域的基础设施问题。当自动化程序频繁访问目标网站时,网站会通过 IP 频率限制、指纹检测(如识别无头浏览器特征)、验证码挑战等手段将其拦截。应对方式之一是代理池:使用大量分布在不同地区的 IP 轮换请求,使单个地址的访问频率看起来正常。Apify 等平台把代理轮换、指纹伪装、验证码处理、请求重试等逻辑内置在云端执行环境里,用户只需关心输入参数和输出字段。这也是为什么同样的查询,Claude 直接访问只能拿到残缺的 10 条记录,而 actor 能返回完整数据集——差别不在模型,而在于这些底层工程细节。
MCP Server:一行配置打通 Agent
Apify 最有价值的能力是提供了 MCP Server。MCP(Model Context Protocol)是当前 AI 应用接入外部工具的标准协议,Claude、Cursor、ChatGPT 等工具均已支持。
接入过程很简单:在 Claude 的 Connectors 设置中添加自定义连接器,填入 mcp.apify.com 的 URL,通过 OAuth 完成授权。Agent 随即获得调用 Apify 所有 actor 的能力。
这里的差异值得注意。传统方式下,你要为每个网站单独写集成代码。接入 MCP 后,Agent 可以自行搜索 80,000 个 actor、阅读使用说明、选择正确的工具并执行——用自然语言描述需求即可,不需要预先知道该用哪个 actor。
**MCP(Model Context Protocol)**是 Anthropic 于 2024 年底提出的开放协议,用于标准化 AI 应用与外部工具、数据源之间的连接方式。在没有 MCP 之前,每接入一个新工具,开发者都要为不同客户端(Claude、Cursor、ChatGPT 等)分别写适配代码;MCP 把“工具暴露”和“工具调用”抽象成统一接口,服务端实现一次,所有支持该协议的客户端都能即插即用。其核心概念包括:Tools(可被模型调用的函数)、Resources(可读取的数据)、Prompts(预置提示模板)。Apify 的 MCP Server 就是把 80,000 个 actor 包装成标准 Tools,让 Agent 通过自然语言检索和调用。
五个真实场景的实测表现
博主依次测试了五种数据抓取场景,覆盖了业界公认最难抓取的平台:
Google Maps 商家线索:重复开头的牙科诊所查询,这次拿到了完整的 leads.csv,包含评分、电话、地址等字段。缺失的少量电话号码和评分经核实是 Google Maps 原始数据中就不存在。单次运行成本 10 美分。
Instagram 账号内容:拉取 Duolingo 最近 30 条帖子,识别出 reels、carousel 和图片的内容类型分布,成本 5 美分。Instagram 对自动化流量的封锁一向严格,这个结果说明 actor 的反封锁策略有效。
TikTok 话题搜索:查找 #AI tools 标签下播放量最高的 30 条视频。这个请求扫描了超过 300 条视频,Agent 进一步读取了视频 transcript 后输出结构化 CSV 文件。与按账号查询不同,按话题搜索要求 actor 具备更广的发现能力。
LinkedIn 招聘数据:抓取美国 AI Engineer 岗位最近一周的 50 条最新招聘信息。结果覆盖 45 家公司,78% 的岗位公布了薪资,范围在 $150K-$250K 之间,最高 $388K 来自 TikTok。热门技能标签包括 LLM、Python、Agent、RAG、PyTorch、Evals。
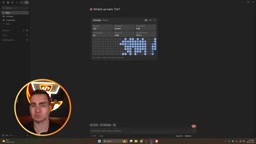
YouTube 视频分析:找出 Claude Code 相关最近 30 天播放量最高的 20 条视频。Agent 自动计算了 outlier ratio(播放量相对频道平均值的倍数),识别出小频道爆款案例,并读取 transcript 分析了视频结构。
五个场景全部跑完,总花费 $2.71。
进阶玩法:组合多个 Actor 构建自动化 Skill
单个 actor 解决单点数据获取。真正的价值在于把多个 actor 组合成一个 Skill。
博主演示了一个线索生成场景,面向社交媒体代运营或 AI 自动化 agency:最佳客户是那些评价好但没有社媒存在感的成长型企业。
这个 Skill 的逻辑链是:Google Maps 找到目标商家和评价 → Instagram 检查社媒活跃度 → LinkedIn 查看是否在招人(判断预算和增长) → TikTok 找该领域热门内容 → YouTube 找高播放话题 → Agent 综合打分并为客户生成个性化 pitch。
设置方式是在 Claude Code 中用一段 prompt 定义 Skill(命名为 /prospect),后续只需输入品类和城市即可触发。
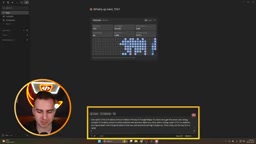
实测运行 barber shops in London,输出了一份完整的 HTML 报告,包含商家列表、竞品内容分析、Top 5 线索的个性化 pitch 和评分,总花费约 37 美分。
这种组合方式的核心优势在于:Skill 中预先定义了每个 actor 的调用格式和响应结构,Agent 不需要每次运行时重新摸索,减少了无效的工具调用。
Claude Code 中的 Skill 是一种可复用的封装机制:用一段自然语言 prompt 定义任务的执行流程、涉及的工具及其调用参数,保存后通过斜杠命令(如 /prospect)触发。Skill 的价值在于把“每次让 Agent 现场推理该用哪个 actor、输入格式是什么、结果字段有哪些”这部分不确定性前移到定义阶段,从而减少运行时无效的工具调用和 token 消耗。这与传统软件中的函数封装思路一致:把稳定流程固化,把变化参数留给用户输入。对于需要反复执行的数据工作流(线索生成、竞品监控、内容分析),这种模式能显著降低成本并提升结果一致性。
多源交叉验证与行业趋势
在同类工具中,Apify 的定位并非唯一。Firecrawl、Bright Data 等方案也在做类似的事情。但 Apify 的差异化在于 MCP Server 的原生集成体验和 80,000 actor 的生态规模。
值得一提的行业信号是:美国 AI Engineer 岗位薪资中位数达到 $150K-$250K(据 Apify LinkedIn actor 抓取的实时数据),且热门技能标签清一色是 LLM、Agent、RAG、Evals。这说明 Agent 工程化已经从实验阶段进入生产部署阶段,对数据管道基础设施的需求正在快速增长。
Firecrawl 与 Bright Data 是 Apify 在数据抓取领域的主要竞品,三者定位不同:Firecrawl 专注把单个网站转成 LLM 友好的 Markdown(偏爬取与结构化),Bright Data 以大规模代理网络和数据采集基础设施见长(偏底层),而 Apify 强调“现成 actor 市场 + 云计算 + MCP 集成”的一站式体验。选择时需权衡几点:是否已有目标平台的现成抓取器、按结果付费与按订阅付费的成本模型差异、反封锁能力上限,以及对 MCP 等 Agent 原生接入的支持程度。行业中还没有公认的赢家,多源交叉验证本身也是降低单一平台依赖风险的合理做法。
实际使用中的限制
几个需要留意的地方:
- 数据完整性取决于源站。缺失的评分或电话可能并非抓取失败,而是源站本身就没有这些信息
- 成本随数据量线性增长。$5 免费额度看起来不少,但如果做大规模线索生成,费用会快速上升
- Skill 需要迭代。博主也提到,初次生成的 Skill 需要运行后逐步调优
Apify MCP Server 解决的核心问题,是让 AI Agent 用一行配置获得全网结构化数据访问能力。对于需要 Agent 做真实研究、竞品分析或线索生成的使用者而言,这是当前最务实的路径之一。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。