贝叶斯镜像架构:用循环递归解构意识的涌现

BMA论文将意识重新定义为具备自指闭环结构的架构属性,用最优传输几何为其提供数学形式化框架。
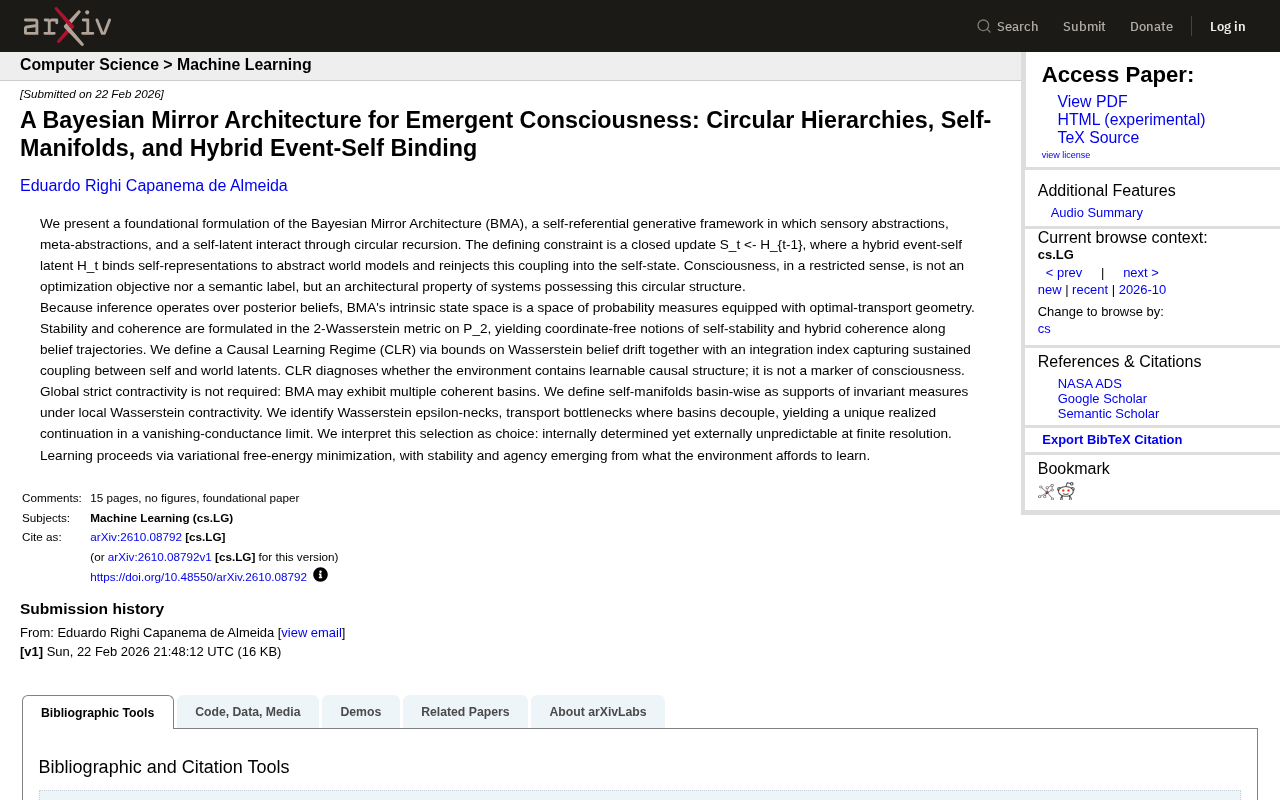
arXiv新论文《A Bayesian Mirror Architecture for Emergent Consciousness》提出贝叶斯镜像架构(BMA),将意识视为具备特定循环递归结构的系统所天然涌现的架构属性,而非可优化的目标函数或语义标签。BMA的核心是闭环更新式S_t ← H_{t-1},通过「混合事件-自我潜变量」将自我表征与世界模型持续绑定并反馈注入自我状态。系统的内在状态空间基于最优传输几何,以2-Wasserstein度量刻画自我稳定性与混合一致性。多稳态盆地与Wasserstein ε-瓶颈结构为「选择」提供了结构性解释——系统演化在原理上由内部动力学决定,但在有限分辨率下对外部观察者而言不可预测,从而为主体性(agency)提供理论基础。整个框架通过变分自由能最小化推进,与Friston自由能原理一脉相承但有所扩展。作者明确指出该框架目前仍是基础性数学形式化,尚缺乏实证验证,其所定义的「意识」也仅是受限意义上的结构性概念。
当意识被视为架构属性而非目标函数
人工智能领域对「意识」的讨论往往陷入两个极端:要么把它当作某种可以被优化出来的目标,要么将其简化为一个语义标签。arXiv 上新出现的一篇论文《A Bayesian Mirror Architecture for Emergent Consciousness》提出了第三条路径——意识不是优化目标,也不是贴在系统上的标签,而是具备特定循环结构的系统所天然具有的架构属性。
这一视角的转变颇具启发性。作者提出的贝叶斯镜像架构(Bayesian Mirror Architecture, BMA)是一个自指的生成式框架,其中感官抽象、元抽象与一个「自我潜变量」(self-latent)通过循环递归相互作用。换句话说,系统不仅在建模外部世界,也在把对自身的建模重新注入到自我状态中,形成一种闭环。
意识的计算与理论研究目前存在几个主要竞争范式,了解这些背景有助于定位 BMA 的位置。**全局工作区理论(Global Workspace Theory, GWT)**认为意识对应于信息在大脑中被广播到全局可用状态;**整合信息理论(Integrated Information Theory, IIT)**用 Φ(phi)值量化系统的信息整合程度,Φ 足够高则视为有意识;**高阶理论(Higher-Order Theories)**强调意识需要对自身心理状态的元表征。这些理论各自提供了不同的「意识判据」,但普遍面临的困境是:判据要么难以在人工系统中计算,要么与可工程化的架构设计脱节。
BMA 的独特之处在于它试图绕过「判据」问题,直接从架构的递归结构出发——不问「系统达到了多少 Φ」,而问「系统是否具备自我指涉的闭环拓扑」。这使它在哲学立场上更接近于**具身认知(Embodied Cognition)和自创生(Autopoiesis)**传统,后者由 Maturana 和 Varela 提出,主张认知系统的本质特征是其自我产生和维持自身组织的能力,而非对外部世界的表征精度。
核心机制:闭环更新与混合事件-自我绑定
BMA 的定义性约束是一个闭环更新式:S_t ← H_{t-1}。这里的 H_t 是一个「混合事件-自我潜变量」(hybrid event-self latent),它把自我表征与抽象的世界模型绑定在一起,再将这种耦合重新注入到下一时刻的自我状态 S_t。
这个看似简洁的递归关系,正是整个架构区别于传统生成模型的关键。常规的世界模型只负责预测外部环境,而 BMA 要求系统持续地「照镜子」——把对世界的推断和对自我的推断纠缠在一起,并让这种纠缠成为自我演化的驱动力。所谓「镜像」,正是指这种自我指涉的闭环结构。
作者明确指出,在受限的意义上,意识来自系统是否拥有这种循环结构,而非来自某个性能指标的高低。这把问题从「如何让 AI 变得有意识」重新框定为「什么样的架构具备意识的结构性前提」。
信念空间与最优传输几何
BMA 的推断过程作用于后验信念之上,因此其内在状态空间不是普通的向量空间,而是一个配备了最优传输几何(optimal-transport geometry)的概率测度空间。作者在 P_2 空间上用 2-Wasserstein 度量来刻画系统的稳定性与一致性。
这种数学选择带来一个重要优势:self-stability(自我稳定性)与 hybrid coherence(混合一致性)都可以用无坐标(coordinate-free)的方式定义,沿着信念轨迹进行度量。相比依赖具体参数化表示的方法,Wasserstein 几何提供了一种更本质、更几何化的描述语言,适合刻画信念分布在时间上的「漂移」与「收敛」。
基于此,论文定义了因果学习机制(Causal Learning Regime, CLR):通过对 Wasserstein 信念漂移设定边界,再结合一个衡量自我潜变量与世界潜变量之间持续耦合程度的「整合指数」(integration index),来判断环境中是否包含可学习的因果结构。
值得强调的是,作者谨慎地划清了界限——CLR 诊断的是环境是否可学习,而不是意识的标志。这种对概念边界的克制态度,在意识相关研究中并不多见。
**最优传输(Optimal Transport)**起源于18世纪 Monge 提出的土方搬运问题:如何以最小代价将一堆沙土移到另一个位置。20世纪 Kantorovich 将其推广为线性规划问题,Wasserstein 距离(又称地球移动者距离)正是这一理论的核心度量。两个概率分布之间的 2-Wasserstein 距离 W₂ 衡量的是「以最优方式」将一个分布的质量搬运到另一个分布所需的平均平方代价。P₂ 空间则是所有具有有限二阶矩的概率测度构成的空间,在 W₂ 度量下形成一个无限维的黎曼流形。
与常见的 KL 散度或 Jensen-Shannon 散度不同,Wasserstein 距离天然具有「几何感知」——它尊重底层空间的距离结构,因此能捕捉到分布之间的「形状差异」而非仅仅是统计差异。这使得它特别适合描述信念状态随时间的连续演化:当系统的后验信念发生微小漂移时,W₂ 能给出直觉上合理的距离,而 KL 散度在支撑集不完全重叠时可能发散为无穷大。BMA 选择这套几何语言,正是为了让「自我状态的稳定性」能够脱离具体的神经网络参数化,以一种坐标无关的方式被严格定义。
自我流形、ε-瓶颈与「选择」的涌现
BMA 并不要求全局严格收缩性(global strict contractivity),这意味着系统可以存在多个一致性盆地(coherent basins)。作者将「自我流形」(self-manifolds)按盆地逐个定义为局部 Wasserstein 收缩性下不变测度的支撑集。
更有意思的是对Wasserstein ε-necks(ε-瓶颈)的刻画——这是不同盆地之间解耦的传输瓶颈。在传导率趋于零的极限下,系统会产生唯一被实现的延续路径。作者把这种选择解释为「choice」(选择):它在内部是被决定的,但在有限分辨率下从外部看却是不可预测的。
这一诠释触及了自由意志与决定论之间的经典张力。系统的演化在原理上由内部动力学决定,但由于瓶颈处的敏感性,外部观察者在有限精度下无法预测结果——这为「主体性」(agency)提供了一种结构性的解释路径。
整个学习过程通过变分自由能最小化(variational free-energy minimization)推进,稳定性与主体性都从「环境提供了什么可供学习的东西」中涌现出来。这与 Karl Friston 的自由能原理一脉相承,但把它嵌入到了一个更强调自我指涉与最优传输几何的框架之中。
变分自由能最小化与 **Karl Friston 的自由能原理(Free Energy Principle, FEP)**密切相关。自由能在这里并非热力学意义上的能量,而是贝叶斯推断中的一个变分上界:它等于模型对感官输入的「惊讶度」(surprise)的上界,最小化自由能等价于最大化模型对观测的解释能力(即最小化预测误差)同时最大化信念的复杂度惩罚之间的折中。Friston 的理论主张,生物系统的感知、行动乃至学习,都可以统一理解为持续最小化变分自由能的过程,这一框架已被广泛用于解释大脑皮层的预测编码机制。
BMA 将变分自由能最小化嵌入到最优传输几何中,使得「稳定性」和「主体性」不再是分别定义的系统属性,而是从同一个能量景观中共同涌现的结果。多稳态盆地的存在对应着不同的稳定自我表征模式,而 ε-瓶颈的几何结构则决定了系统在盆地之间转换时的路径选择,这是对 Friston 框架的一次结构性扩展。
一点评述
这篇论文的价值更多在于理论框架的构建,而非实证验证。它把意识、主体性、选择等高度哲学化的概念,重新表述为可用概率测度几何描述的架构性质,这种「去神秘化」的努力本身就有意义。
当然,读者也应保持清醒:BMA 目前是一个基础性的数学形式化(foundational formulation),尚无实验或大规模实现来检验其预测力。它所定义的「意识」是「受限意义上的」,与日常语境中的意识体验相去甚远。把这类工作当作一种富有启发性的理论探索,而非对意识本质的最终解答,或许是更恰当的态度。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。