本地AI部署神器LocModel:一键玩转开源模型与AI生成
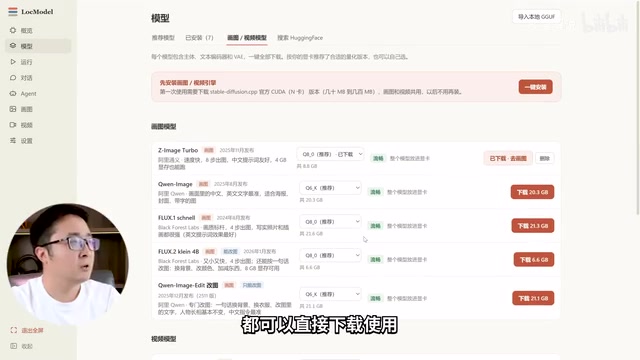
LocModel以硬件自动适配和内存加载降低本地AI部署门槛,实测图片、视频生成与Agent可用。
本文介绍了B站UP主“零度解说”分享的本地AI部署工具LocModel。该工具能自动检测硬件并推荐适配的开源模型,模型库对接Hugging Face,支持N卡、A卡、i卡及纯CPU调用,还可借助内存和硬盘加载弥补显存不足。实测中,图片生成几乎瞬间完成,图片编辑在下载专用改图模型后效果明显改善;图生视频经过几分钟等待可生成角色一致、遵循提示词的视频。用户还能导入无审查大模型进行自由对话,并利用内置Agent自动编写番茄钟网页和可玩游戏,全程离线。文章认为LocModel把模型下载、引擎安装、硬件适配和Agent调用打包为图形化流程,显著降低了本地AI入门门槛,但低配设备推理速度仍有局限。
在云端AI服务遍地开花的今天,内容审查、订阅费用和隐私顾虑始终是绕不开的话题。B站UP主“零度解说”近期分享了一款名为LocModel的本地AI部署工具,号称能让普通用户在自己的电脑上免费运行开源大语言模型、图片生成、视频生成乃至Agent智能体,真正实现“AI自由”。
LocModel是什么?硬件适配是最大亮点
LocModel的核心定位是“本地AI部署神器”。根据视频介绍,它最大的特色是能自动检测你的电脑硬件配置,并据此推荐最适合的AI模型——模型库直接对接Hugging Face,涵盖大语言模型、图片模型和视频模型。
更实用的一点是,它支持内存和硬盘加载。这意味着即使显卡显存不够,用户也能借助内存或硬盘来“硬扛”模型运行。官方宣称支持N卡、A卡、i卡以及纯CPU调用,覆盖面相当广。对于手头设备不算顶配、又想本地跑AI的用户来说,这个设计降低了门槛。
量化(Quantization) 是本地部署大模型时绕不开的核心概念。简单来说,它把模型权重从高精度(如FP16,每个参数占2字节)压缩到低精度整数(如INT8、INT4),从而大幅减少显存占用和计算量。文章提到的“Q8”“Q6”即指8位、6位量化,数字越小模型越小、速度越快,但精度损失也越大。量化让消费级显卡甚至CPU也能跑动原本需要数据中心级硬件的大模型,是LocModel能实现“硬件适配推荐”的技术基础。
Hugging Face 是全球最大的开源AI模型社区,汇集了数十万个预训练模型、数据集和推理工具。LocModel的模型库直接对接Hugging Face,意味着用户可以获取社区持续更新的各类开源模型。需要注意的是,Hugging Face上的模型质量参差不齐,且部分模型有商用限制或安全审查策略,下载前应查看模型卡片(Model Card)中的许可协议和使用说明。
安装与模型推荐:全自动化的上手流程
视频中演示的安装过程相当简单:从官网下载后解压并默认安装,打开软件即会自动识别当前硬件,并列出推荐的模型清单。用户看到的模型都来自Hugging Face,包括JImage、Chainwell以及Minimax等视频生成模型,可直接下载使用。
在开始生成内容之前,需要先安装图片和视频推理引擎。UP主使用的是N卡,因此软件推荐了对应的引擎;A卡或i卡用户只需点击一键安装,系统会自动匹配。整个过程基本不需要手动配置环境,这对不熟悉命令行的用户非常友好。
图片生成与编辑:无审查模型实测
图片生成方面,UP主下载了ZImage的Q8量化版——一个开源无审查的图片模型。根据显存大小,LocModel会自动推荐合适的量化版本,例如改图模型签问ImageEdit被推荐了Q6量化版。
实测生成一张9:16比例的图片,速度非常快,几乎瞬间完成。图片编辑功能也在对话框内完成:上传图片、输入要求(如“把白色T恤改成黑色并戴上眼镜”),模型就会尝试修改。不过UP主指出,如果没有下载专门的改图模型,软件会在原图基础上重画细节,效果会有偏差;下载签问ImageEdit或更小的Flash 2.0后,改图效果明显改善。
“无审查模型” 通常指在训练或微调阶段移除了内容安全对齐(如RLHF中的拒绝回答策略)的开源模型。这类模型在本地运行时不受云端服务的内容过滤约束,可生成或讨论更广泛的题材。但这也意味着输出内容完全由用户自行负责,可能涉及版权、隐私或法律风险。此外,无审查并不等于高质量——部分去审查微调会削弱模型的指令遵循能力和事实准确性,实际使用中需自行甄别输出结果。
视频生成:图生视频实测可用
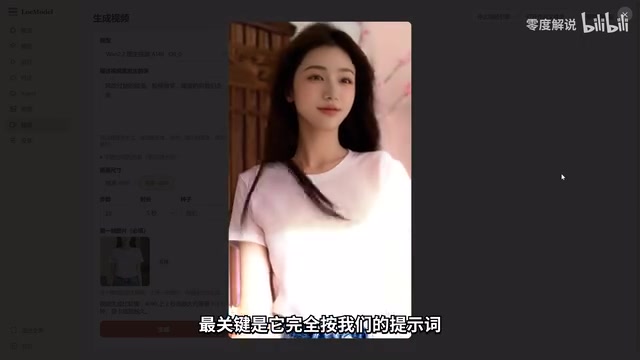
视频生成环节,LocModel同样根据硬件推荐了五个视频模型。UP主选择了WAN 2.2图生视频A14B的Q8量化版,上传一张人物图片并输入提示词“风吹过她的脸庞,脸带微笑,缓缓地向我们走来”,采样步数保持默认。
经过几分钟等待,生成的视频顺利完成,人物角色一致性不错,且较好地遵循了提示词。这说明本地视频生成虽然耗时更长,但已经具备可用性。
图生视频(Image-to-Video) 是生成式AI中较新的方向:模型以一张静态图片作为首帧或参考,结合文本提示词生成连续视频帧。其技术难点在于保持人物/物体在时间维度上的一致性,避免闪烁、形变和背景漂移。文章提到的WAN 2.2、Minimax等均为开源视频生成模型,通常采用扩散模型架构,对显存和算力要求远高于图片生成,因此本地运行时耗时以分钟计,且量化版本的画质和运动流畅度会有所折损。
导入无审查模型:内存硬盘加载立功
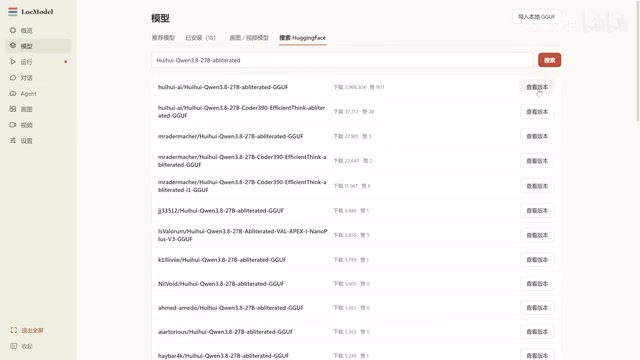
LocModel支持在线下载和手动导入两种模型获取方式。UP主演示了从Hugging Face下载一个无审查语言模型(Q8版本),再通过“导入本地模型”功能载入软件。由于软件支持内存与硬盘加载,即使显存不足,模型也能运行。
导入后启动模型进行对话测试,模型能正常自我介绍并响应请求。UP主还现场让模型编写一个“网站CG压力测试工具”,模型直接给出了完整的实现方案,印证了无审查模型在内容限制上的宽松。
有意思的是,选择模型时不必照搬演示,用户可以在模型中心搜索关键词,挑选适合自己硬件的版本。UP主建议优先选择标注“流畅”的版本,输出速度会更快。
Agent智能体:让本地AI真正干活
除了内容生成,LocModel内置了Agent智能体功能。UP主演示了两个任务:一是让AI编写一个番茄钟网页,选择工作文件夹后,AI自动生成HTML文件,双击即可运行,无需联网或安装任何东西;二是挑战更高难度的“小海骑自行车”闯关游戏,AI规划了游戏结构、音效和关卡,在执行需要权限的命令时请求用户授权,最终生成了可玩的游戏。
整个过程完全调用本地模型,工作区文件夹可自定义。这意味着Agent能够把自然语言需求转化为实际可运行的文件,对开发者或内容创作者来说,是提高效率的实用功能。
Agent(智能体) 指让大语言模型不仅生成文本,还能自主规划步骤、调用工具(如写文件、执行命令、搜索)来完成复杂任务。其典型工作流是“思考—行动—观察”循环:模型先拆解任务,再决定调用哪个工具,读取工具返回结果后继续推理,直至任务完成。文章演示的自动编写网页和游戏即属于“代码生成+文件写入”类Agent。本地Agent的优势是数据不出设备、无需联网,但受限于本地模型的能力,复杂任务的规划稳定性和错误恢复能力通常弱于云端大模型。
多源交叉验证与使用建议
需要说明的是,本次分析主要基于零度解说的视频内容,属于单一来源。不过从社区讨论来看,LocModel的硬件自动适配和内存加载能力被多次提及,与视频描述基本一致。也有用户指出,大模型在低配置设备上的推理速度仍有局限,需要合理选择量化版本。
总体而言,LocModel把模型下载、推理引擎安装、硬件适配、Agent调用打包成一套图形化流程,确实降低了本地AI的入门门槛。对于希望摆脱在线服务限制、又想免费体验AI生成能力的用户,值得一试。
相关推荐
ReLU网络集合的闭性新证:单隐层弱闭,双隐层非闭
新研究证明单隐层ReLU网络集合在W^{1,p}中弱闭,保证Deep Ritz等方法解的存在性;而双隐层网络集合非闭,推翻已有猜想。
FlowMoP:随机多人运动预测新框架
FlowMoP提出条件流匹配框架,联合生成多个智能体的多样化未来运动,通过B样条重参数化与双流Transformer实现交互感知预测,在CMU-Mocap和3DPW上超越确定性基线,并建立WorldPose首个运动预测基线。
分级卷积网络:无需尺度参数的尺度不变性与抗模糊鲁棒性
分级卷积网络利用图像高斯射流的分级向量空间结构,通过回缩操作实现无需尺度参数的尺度不变性,并在未知高斯模糊下显著提升鲁棒性。MNIST实验显示,两像素模糊下准确率保持88.4%,优于尺度归一化导数的66.2%。