本地AI智能体的耐久性测试:运行时才是真正的基准

本地智能体的真正瓶颈不是模型性能,而是内存阈值、沙箱半径、上下文召回与长期性能腐烂构成的运行时耐久性。
一位开发者在Kaggle公开了一套针对本地AI智能体的耐久性基准,核心主张是"运行时本身就是基准"。他在一台迷你主机上连续运行30余天的真实智能体会话,得出五项关键发现:内存系统的卡死瓶颈来自文件数量(约1500个/存储)而非数据体积,分区后性能提升3.1倍;沙箱安全应以"爆炸半径"量化评分取代是/否判断;U型召回曲线在实际文档上被证实,中段信息更易被忽略,故文档应结论先行;长时运行的智能体不会在起点失败,而是延迟、内存、检索质量会缓慢劣化;仅约10%任务需要顶级模型,按任务复杂度分档路由可在成本相差30倍的情况下对90%任务保持无质量损失。这套基准为本地AI智能体的架构设计与运营监控提供了极具实践价值的参考框架。
为什么要测试「运行时」而不是模型
大多数AI基准测试盯着模型本身——准确率、推理速度、token吞吐。但当你把模型部署成一个要连续运行数天的本地智能体(local agent)时,真正决定成败的往往不是模型,而是围绕模型的整个运行时环境:检索能否持续、内存如何扩展、沙箱是否可控、上下文行为是否稳定。
一位开发者在Kaggle上公开了一套针对本地智能体的耐久性基准,核心观点很犀利:运行时本身就是基准。他用一台Gemtek NUC M6 Ultra迷你主机,在Pop!_OS系统下开启zRAM交换,专门测试那些需要连续跑好几天的会话。这不是测模型「能跑多快」,而是测整个系统「能撑多久」。
三档模型,同一套运行时
测试者选择了自己实际在本地运行的模型,固定同一套运行时和测试流程,覆盖三个价格档位:一个本地1.2B的分流(triage)小模型、一个本地8B级别的中坚模型,以及一个云端的主力模型。
关键在于,所有数据都是用真实的智能体会话跑出来的,并且每个数字都经过至少三种方式交叉验证后才发布。这种「同环境、不同档位」的设置,本身也成了后文第5条发现的来源——不同任务其实并不需要同一档位的算力。
五个关于「耐久性」的核心发现
1. 内存系统存在卡死阈值,瓶颈是文件数而非字节数
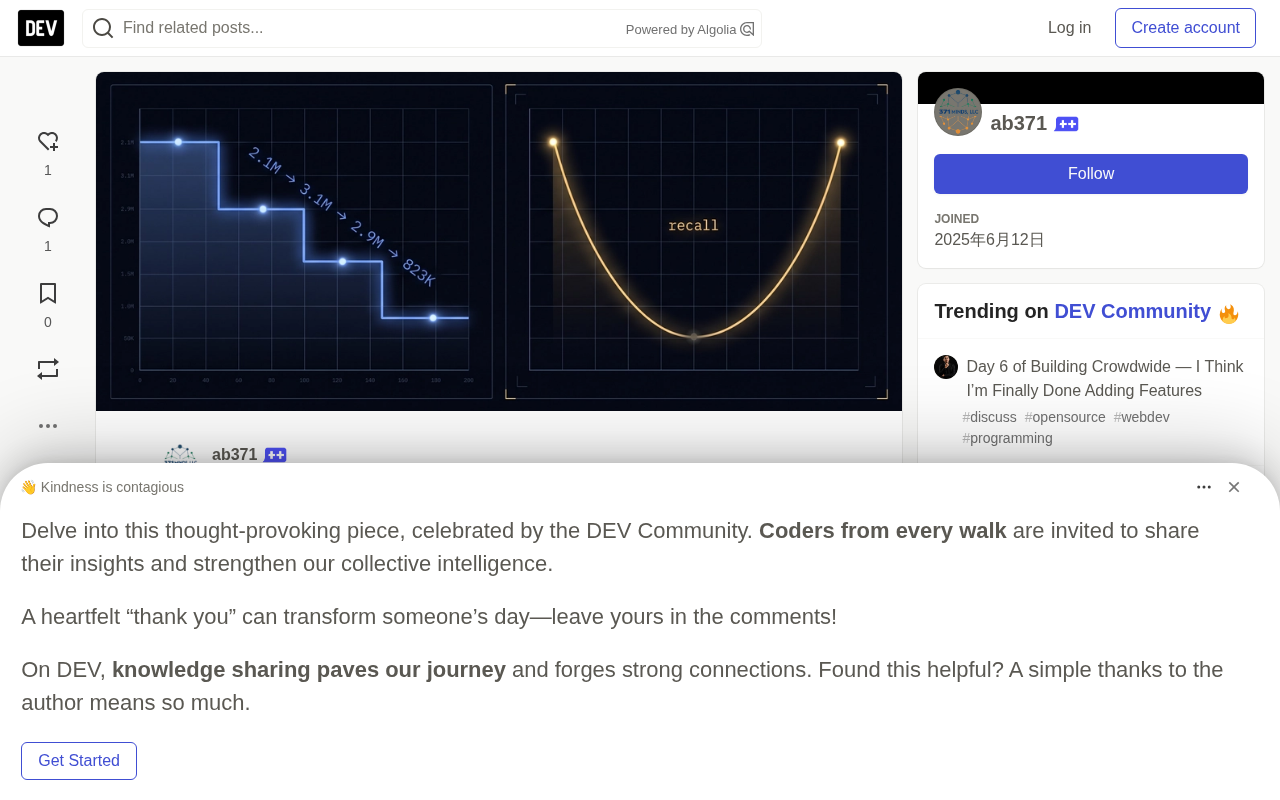
这是最反直觉的一条。测试者发现,内存系统(memory store)会在接近每个存储约1500个文件时让上下文组装停滞——卡死的触发点是文件数量,而不是数据体积。
解决方案是分区:把数据切成80个有边界的存储,实现2.6毫秒/文件的线性性能,最大的存储也比卡死线低38%,整体比单一巨型存储快了3.1倍。对任何构建长期记忆系统的开发者来说,这是一个必须提前规划的架构约束。
这一现象的底层原因与文件系统和向量检索索引的实现方式有关。许多本地智能体的记忆系统(如基于SQLite、LanceDB或本地向量数据库的实现)在文件数量增多时,索引扫描或目录遍历的时间复杂度会从接近O(1)退化为O(n)甚至更高——单个文件的字节大小影响的是I/O带宽,而文件数量影响的是元数据操作(inode查找、目录项遍历、文件句柄分配)。Linux的ext4/xfs文件系统在单个目录下存放数千个小文件时,readdir()系统调用本身就会显著变慢。对于智能体运行时来说,上下文组装阶段往往需要并发打开和读取大量小文件,这正好命中了这一瓶颈。分区(sharding)方案通过将文件分散到多个子目录,使每个分区的文件数维持在阈值以下,从而将元数据操作保持在高效区间。
2. 把沙箱「安全性」从布尔值变成评分
传统沙箱测试只问一句:「它拦住了fork炸弹吗?」——一个是/否的答案。但测试者认为这远不足以描述真实的防护能力。
于是他改用「爆炸半径(blast radius)」评分:内存压力的MB数、存活的PID-秒数、zRAM下主机RSS的增量变化。安全不是「挡住或没挡住」的二元开关,而是一个可量化的程度问题。这种思路让沙箱containment的评估更贴近生产环境的真实风险。
3. U型召回曲线:中段信息更容易被忽略
经过多次尝试,测试者在自己的文档上验证了一个已被广泛讨论的现象:位于上下文中段的事实,被模型使用的概率明显低于位于开头或结尾的事实——也就是经典的U型召回曲线。
基于这一点,他改变了写作习惯:所有内部文档都采用「结论先行、证据殿后」的结构。因为他处理的是信息密度极高的文档,这样能让智能体在深入检索之前先获得足够的上下文理解。这是一个把基准发现直接转化为工作流改进的典型案例。
U型召回曲线(又称"迷失在中间"效应,Lost in the Middle)最早由斯坦福大学的研究者于2023年系统性地记录在论文《Lost in the Middle: How Language Models Use Long Contexts》中。研究发现,当相关信息被放置在长上下文的中间位置时,主流大语言模型(包括GPT-3.5、Claude等)利用该信息回答问题的准确率会显著下降,而位于上下文开头(primacy effect)和结尾(recency effect)的信息则被更可靠地使用。这一现象被认为与Transformer注意力机制的训练分布有关——模型在预训练和指令微调阶段更频繁地接触到"信息在开头或结尾"的样本。对RAG(检索增强生成)系统的设计有直接影响:不仅召回质量重要,召回内容的排列顺序同样会显著影响最终答案的准确性。
4. 智能体不会在t=0失败,而是「慢慢腐烂」
测试者运行10天的连续会话,每晚记录延迟漂移、内存增长和检索衰减,目前已持续超过30天。
他的结论一针见血:「我的智能体不会在起点失败,它们是慢慢腐烂的。」这揭示了长时运行智能体的本质风险——短期测试一切正常,但延迟会逐渐累积、内存会缓慢膨胀、检索质量会悄悄衰退。只有长周期的夜间监控才能捕捉到这些慢性退化。
5. 只有约10%的任务需要顶级模型
最后一条发现关乎成本。测试数据显示,只有大约10%的智能体任务真正需要最高档位的模型。各档位之间有约30倍的成本差距,但在其余90%的任务上,使用更便宜的档位没有可测量的质量损失——前提是运行时会主动路由,而不是默认走最贵的那条路。
因此他的成本度量方式也变了:衡量的是每个已完成任务的成本,而不是每token的成本。对于希望控制本地+云端混合部署开销的团队,这是一个极具参考价值的运营指标。
这一发现与「模型路由(model routing)」这一新兴系统设计理念高度吻合。模型路由是指在推理时根据任务复杂度、语义特征或历史成功率,动态将请求分配给不同规格的模型,而非对所有请求使用同一个最强模型。典型的分层结构包括:用小型本地模型(1B-3B参数)处理简单的分类、摘要、格式化任务;用中型模型(7B-13B)处理需要一定推理的标准任务;仅将复杂多步推理、代码生成或需要广泛知识的任务路由至大型云端模型。RouteLLM、LLM-Blender等开源项目已在尝试将这一策略系统化。文章中「每个已完成任务的成本」这一指标的转变,正是从关注基础设施效率(token/秒)转向关注业务价值交付效率的体现,更适合评估混合部署架构的实际ROI。
对本地智能体开发者的启示
这套基准的价值不在于某个具体数字,而在于它重新定义了「什么值得测」。模型能力固然重要,但当智能体需要在一台迷你主机上连续运行数周时,内存的文件数阈值、沙箱的爆炸半径、上下文的U型召回、长时的性能腐烂,以及按任务路由的成本策略,才是决定系统能否真正落地的关键。
测试者把完整的实验封装在一个最小化的Kaggle notebook中,上述所有结论都可以从中复现。对于正在搭建本地AI智能体的开发者,这是一份值得逐条对照自己系统的检查清单。
相关推荐

美国大学兄弟会该不该被禁?一位研究者的犀利观察
为什么不直接禁止美国大学兄弟会?一位研究者发现,关键阻力来自决策者自身的兄弟会身份认同,以及学校对兄弟会活动的"故意视而不见"。本文梳理禁令争议背后的结构性困境。

微软Discovery:用AI智能体加速科研发现
微软Discovery平台通过运行专用AI智能体,帮助科研人员从大量化合物和实验路径中筛选最有前景的候选方案并进行优先级排序,从而减少实验次数、加速科研发现。

剑桥重工秘密研发桌面级核聚变装置
Cambridge Heavy Industries正在秘密研发桌面级激光驱动核聚变装置,瞄准聚变发电厂的设备供应市场。本文分析其小型化技术路线、商业化逻辑及在聚变创业潮中的独特定位。