本地AI智能体入门:模型与工具怎么选?
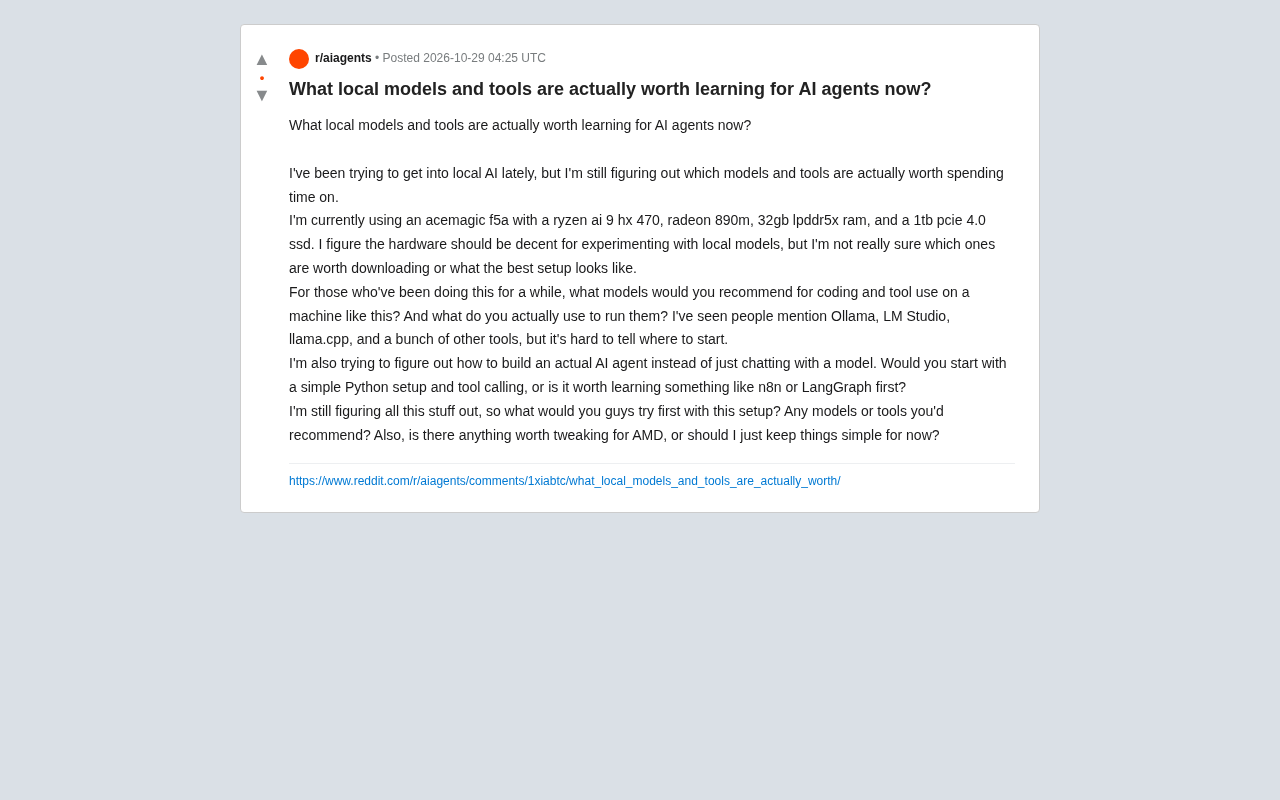
核显加32GB内存即可本地跑模型并搭建智能体,关键在模型选择、工具分工与调优路径。
文章围绕一位 Reddit 用户提出的三个问题展开:在 Ryzen AI 9 HX 470 加 Radeon 890M 核显、32GB 统一内存的平台上,该学哪些本地模型、用什么工具运行、如何从聊天过渡到智能体。作者指出 7B–14B 量化模型是现实选择,编码与工具调用对模型能力的要求不同,量化会推高工具调用的格式错误率。工具层面,Ollama 适合脚本与 API、LM Studio 适合图形化对比、llama.cpp 适合精细控制,三者按阶段使用而非互斥。智能体部分建议先用 Python 手写工具调用循环理解失败模式,再引入 n8n 或 LangGraph。AMD 平台则需重点确认 ROCm/Vulkan 后端兼容性并显式设置 GPU 卸载层数。
本地跑大模型、搭智能体,硬件门槛已经比想象中低。一位用户在 Reddit 上晒出自己的配置——Ryzen AI 9 HX 470 处理器、Radeon 890M 核显、32GB LPDDR5X 内存、1TB PCIe 4.0 固态硬盘——并抛出三个问题:哪些本地模型值得学?用什么工具跑?怎么从聊天过渡到真正的 AI 智能体?
这套硬件属于「核显+大内存」的典型组合,没有独立显卡,但统一内存架构对加载模型相当友好。下面结合社区常见经验,拆解模型选择、运行工具和智能体搭建路径。
本地模型怎么挑:先看任务,再看尺寸
本地模型的核心权衡是「能力 vs 显存/内存占用」。在核显平台上,7B–14B 参数量级的模型是更现实的选择,30B 以上虽然能跑,但速度会明显下降。
编码与工具调用是两类不同需求。编码任务看重长上下文和代码补全质量,社区里 Qwen 系列的 Coder 版本、DeepSeek广告 的代码模型被提及频率较高;工具调用则更依赖模型对函数签名的遵循能力,小参数模型里 Qwen 系列和 Llama 系列的工具调用版本是常见起点。
需要注意的是,模型量化版本(如 4-bit、5-bit)能大幅降低内存占用,但在工具调用这类需要严格格式输出的任务上,量化可能带来格式错误率上升。建议同一任务下对比不同量化等级的实际表现,而不是只看参数规模。
什么是模型量化
量化是指把模型权重从 16 位浮点(FP16)压缩到更低精度、例如 4 位或 5 位整数的过程,常见格式包括 GGUF、AWQ、GPTQ 等。它的价值在于把同一模型的内存占用降到原来的四分之一左右,让 32GB 核显平台也能加载 14B 级别的模型。代价是数值精度损失,这种损失在普通对话中往往难以察觉,但在需要严格输出格式(如 JSON 参数、函数调用)的任务上,可能表现为括号缺失、字段名拼错等错误率上升。因此量化等级不是越低越好,常见做法是优先选 5-bit 或 Q5 级别的版本作为质量与体积的折中,并把 4-bit 只用于对精确度要求不高的场景。
运行工具:Ollama、LM Studio、llama.cpp 各管一摊
原帖提到的三个工具其实定位不同,不必纠结「选哪个」,而是按阶段用。
- Ollama:命令行优先,拉取模型和启动服务一条命令搞定,自带 API 接口,适合写脚本和做自动化。想快速验证「模型能不能用」时最省事。
- LM Studio:图形界面,模型浏览、下载、参数调节都在一个窗口里完成,适合不想碰命令行的阶段,也方便对比不同模型的输出。
- llama.cpp:底层推理引擎,Ollama 和 LM Studio 在很多时候都基于它。直接用它意味着能精细控制量化、线程数和显存卸载策略,但学习曲线更陡。
对这块 AMD 核显平台,社区的经验是:先确认工具是否支持 ROCm 或 Vulkan 后端。Ollama 和 LM Studio 对 AMD 的支持在持续完善,但不同版本的兼容性差异较大,遇到跑不起来的情况,优先检查后端配置而不是怀疑硬件。
ROCm 与 Vulkan 是什么
ROCm 是 AMD 推出的开源计算平台,地位大致相当于 NVIDIA 的 CUDA,负责让推理框架调用 AMD GPU 做并行计算;Vulkan 则是一个跨厂商的图形与计算 API,通过它的计算扩展也能让推理引擎在 AMD 核显上运行。两者的区别在于:ROCm 在受支持的独立显卡上性能更好,但对核显和操作系统的支持范围较窄、版本匹配要求严格;Vulkan 后端兼容性更广,核显通常可用,但峰值性能略逊。这也是为什么在 AMD 核显平台上,遇到跑不起来或速度异常时,第一步应确认推理工具走的是哪条后端路径,以及驱动版本是否与该后端匹配。
从聊天到智能体:Python 起步还是直接上框架?
这是原帖最有价值的问题。聊天和智能体的本质区别在于工具调用循环:模型输出结构化指令 → 程序执行工具 → 结果回传给模型 → 模型继续决策。
建议的路径是先用 Python 手写一个最小循环。用 Ollama 的 API 或 OpenAI 兼容接口,定义一两个工具(比如读文件、执行计算),让模型自己决定何时调用。这个过程能让你直观理解智能体的失败模式——模型不调用工具、调用错参数、陷入循环——这些是框架文档里不会细说的。
手写一遍之后,再评估 n8n 或 LangGraph。n8n 偏工作流编排,适合把智能体接入已有的自动化流程;LangGraph 偏状态机式的多步推理,适合需要分支和回退的复杂任务。跳过手写阶段直接上框架,容易在出问题时不知道是模型的问题还是编排逻辑的问题。
工具调用(Function Calling)的工作机制
工具调用并不是模型真的去执行代码,而是模型按照预先给定的工具描述(名称、参数结构、用途说明)输出一段结构化 JSON,声明「我要调用哪个工具、传什么参数」。宿主程序解析这段 JSON、真正执行函数,再把返回值作为新消息拼回上下文交给模型,模型据此决定下一步。因此智能体的可靠性取决于两件事:模型能否稳定产出符合 schema 的 JSON,以及程序能否妥善处理参数缺失、调用失败和重复调用。小参数模型在长工具列表下容易混淆相似工具,实践中应限制同时暴露的工具数量,并把参数描述写得具体。
AMD 平台要调什么?
原帖最后问「AMD 要不要特别调优」。核显平台的关键在于内存带宽和显存分配——统一内存架构下,给 GPU 分配的显存大小会直接影响能加载的模型尺寸。
实操上值得关注的几点:确认驱动和推理后端版本匹配;在工具里显式设置 GPU 卸载层数,而不是全交给自动检测;如果速度不理想,先降模型尺寸或量化等级,再考虑换工具。对入门阶段来说,保持简单、跑通一个完整链路,比追求极致吞吐更有价值。
统一内存架构与 GPU 卸载层数
传统独显平台有独立的显存,模型放不下就直接失败;而核显与 CPU 共享同一块物理内存的统一内存架构,允许动态划分给 GPU 使用的部分,因此 32GB 内存的机器理论上能加载更大的模型。但共享内存的带宽远低于独立显存,模型越大、每秒生成的 token 数下降越明显。「GPU 卸载层数」指的是把 Transformer 的多少层放到 GPU 上计算,其余层留在 CPU 上,自动检测往往偏保守或偏激进,手动设置能更准确匹配实际可用显存。若设置过高导致显存不足,推理会回退到 CPU 而急剧变慢;设置过低则浪费核显算力。
常见问题
Q:32GB 内存能跑多大的模型? A:7B–14B 的量化版本是比较舒适的范围,具体取决于量化等级和上下文长度。
Q:没有独显能搭智能体吗? A:可以。智能体的瓶颈通常在工具调用逻辑和模型遵循指令的能力,而不只是算力。
Q:Ollama 和 LM Studio 能同时用吗? A:可以,两者都提供本地服务接口,按场景切换即可。
相关推荐

Ollama+RAG本地知识库搭建实战:AnythingLLM喂饭教程
基于B站教程整理,详解Ollama+AnythingLLM搭建本地RAG知识库的完整流程:从通用大模型的知识局限、RAG检索增强生成原理,到文档上传、向量化入库与效果验证的实操步骤。

Ollama保姆级教程:本地免费跑大模型入门指南
Ollama是一款开源的本地大模型管理工具,支持免费下载部署DeepSeek等模型,提供命令行和Web UI,跨平台且能自动调度GPU/CPU资源,适合AI开发入门与私有化部署。

给Claude装上"手":Exoproc开源MCP服务器实现活体进程钩子
Exoproc是一个开源MCP服务器,让Claude Code通过线程劫持直接挂钩活跃Windows x64进程,绕过EDR实现动态分析。静态反编译给Claude眼睛,动态钩子给它双手。