本地AI助手 vs 云端AI:自建LLM的实战经验

本地AI与云端AI各有边界,混合分工才是多数开发者的最优解。
一位开发者用几周时间对比了 Ollama、LM Studio 等本地方案与云端 API,结论是两者并非二选一。本地部署的核心优势是隐私、可控性和离线可用性,但受显存与算力限制,重度推理任务体验会明显下滑;云端在复杂代码生成、多模态与深度推理上仍保持速度与质量领先,因为可以调用参数量远超本地硬件的模型。作者建议采用混合方案:本地处理草稿撰写、机密代码和行内补全,云端负责架构规划、大规模重构与长上下文任务。工具选择应基于系统规格与安全需求,而非模型排行榜上的名次。
为什么要折腾本地AI
一位开发者在几周时间里,围绕 Ollama、LM Studio 以及 Llama 3 等开放权重模型,把本地 AI 和云端 API 两套方案都跑了一遍,用于编码和日常自动化。他的结论并非"二选一",而是先看清各自的边界在哪里。
据作者描述,本地部署的最大吸引力来自隐私与可控性:不必担心数据留存策略,也不受 API 速率限制的束缚。网络不稳定时,离线可用性更是救命稻草。但硬件瓶颈同样真实——在 M 系列 Mac 或 RTX 显卡上跑量化后的 8B 模型体验流畅,可一旦进入重度推理任务,算力需求会迅速攀升。
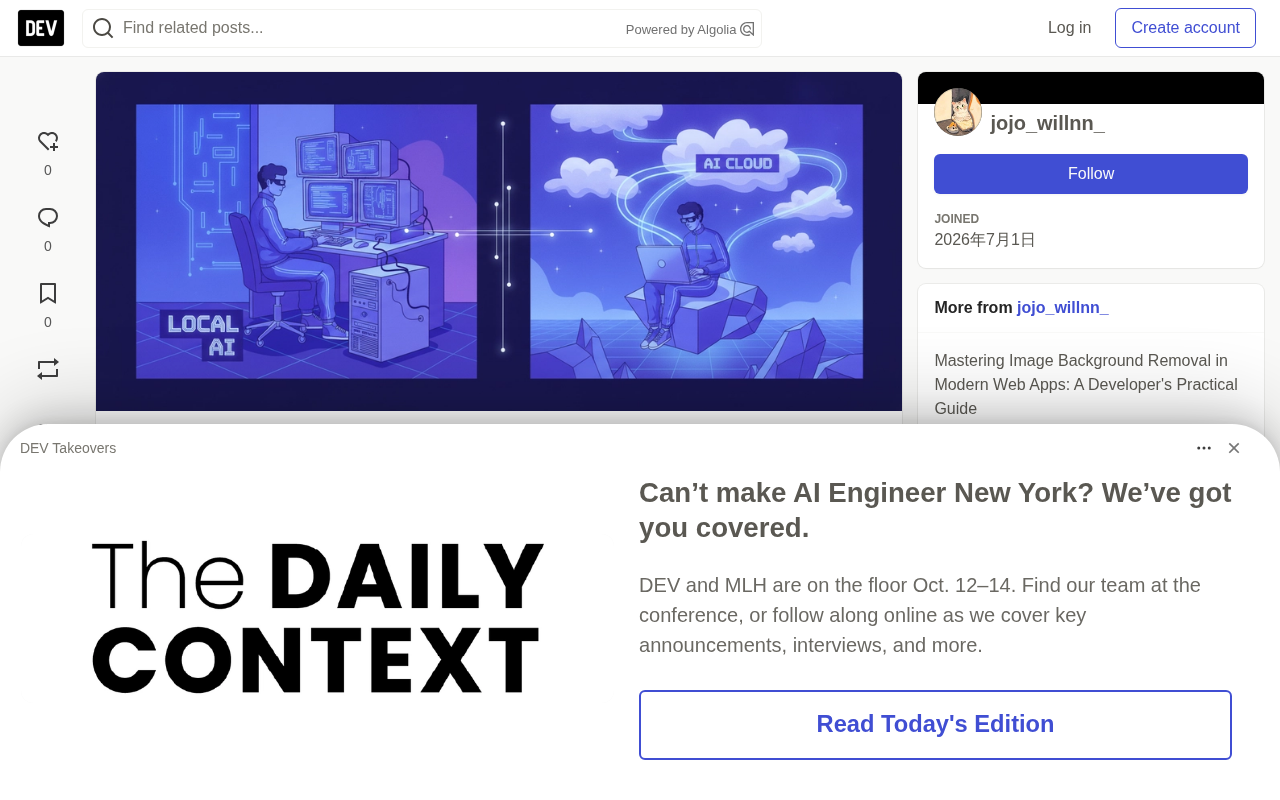
Ollama 是一个开源的本地大模型运行框架,提供类似 Docker 的命令行体验:一条 ollama run llama3 就能拉取模型权重、加载推理并在终端交互。它内置了模型量化管理和 REST API,方便接入编辑器插件或自建脚本。LM Studio 则是面向桌面的图形化工具,内置模型市场、参数面板和本地 Chat 界面,适合不熟悉命令行的用户快速试跑。Llama 3 是 Meta 发布的开放权重模型家族,常见规格有 8B 与 70B,前者经 4 位量化后只需约 5GB 显存即可运行。开放权重意味着下载后完全离线推理、可自行微调,这也是本地方案在隐私与可控性上优于闭源云 API 的根本原因。
量化(Quantization)是本地部署的关键技术,指把模型权重从 16 位浮点压缩为 8 位、4 位甚至更低的整数表示。这样做可把 8B 模型的显存占用从约 16GB 降到 5GB 左右,让消费级显卡和统一内存的 Mac 也能跑起来,代价是精度轻微下降。模型参数量与算力需求大致呈线性关系,而推理时的上下文长度会进一步放大显存压力。这正是作者所说“轻任务流畅、重度推理吃紧”的底层原因:算力与显存是本地运行的硬天花板,而云端可以通过堆叠 GPU 集群绕开这一限制。
云端AI的硬实力仍然领先
作者的实测结论很直接:面对复杂代码生成、多模态任务和深度推理,云端基础设施在速度与输出质量上依然没有对手。原因并不复杂——云端可以直接调用参数量远超本地硬件的模型,而本地设备无需为此"融化 GPU"。
这一点与开放模型生态的现状形成有趣对照。据 Hugging Face 文档,小型开放模型正变得异常高效,但作者强调,选哪套工具最终取决于你的系统规格与安全需求,而不是模型排行榜上的名次。
长上下文窗口指模型单次推理能容纳的 token 数量,主流云端模型已支持 128K 到 200K 甚至更长。上下文越长,模型在处理大规模重构、跨文件阅读和长篇对话时越能保持一致性,但显存与计算开销随长度呈近似平方级增长。本地小模型受限于显存,通常只能稳定运行在 8K 至 32K 区间,一旦超限就需要截断或分块,容易丢失全局信息。多模态能力则指模型同时理解文本、图像乃至音频,这类模型参数量更大、预训练成本更高,本地运行门槛显著高于纯文本模型。
混合方案才是多数人的最优解
基于几周的对比测试,作者给出的建议是混合使用,并按任务类型分工:
- 本地 AI:草稿撰写、机密代码处理、快速行内自动补全。
- 云端 AI:架构规划、大规模重构、需要长上下文窗口的任务。
这个划分的逻辑在于,把隐私敏感、交互频繁但算力要求不高的任务留在本地,把吃算力、吃上下文的重活交给云端。EasyGuides 上的本地 AI 助手与云端 AI 对比也提供了性能与隐私权衡的并排比较,可作为配置参考。
开发者该如何决策
如果你正在搭建自己的 AI 工作流,可以先问三个问题:数据能否离开本机?日常任务里有多少需要长上下文或复杂推理?现有硬件能否稳定支撑常用模型的推理速度?
答案会自然指向本地、云端或混合路线。作者的经验表明,执着于"100% 本地"往往会在重度任务上付出体验代价,而完全依赖云端则可能牺牲隐私与离线能力。
你当前的配置是哪一种?欢迎在讨论中分享你的选择。
常见的实践路径是让本地模型扮演“第一道防线”:代码补全、注释生成、机密片段改写、日志摘要等高频低负载任务先交给它,遇到架构设计、跨仓库重构或需要超长上下文的任务再转交云端。可以借助 Continue、Cline、Aider 这类支持多后端的插件,在同一编辑器里按任务类型切换模型,既不必重写工作流,也能让机密数据始终留在本机。硬件层面建议先实测常用模型在你机器上的 token/s 与首字延迟,再据此划定本地与云端的分工边界。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。