本地编程Agent实战:用开源模型替代Claude订阅的完整指南
本地编程Agent实战:用开源模型替代Claude订阅的完整指南
为什么越来越多开发者转向本地编程Agent
随着Claude Code、Codex等AI编程助手的普及,越来越多的开发者将其纳入日常工作流。然而,这些商业订阅服务在带来强大能力的同时,也伴随着不可忽视的成本与限制:按月付费的订阅费用、请求速率上限、数据隐私顾虑,以及对稳定网络连接的强依赖。
在这样的背景下,用开放权重模型(Open-Weight Models)搭配本地编程框架(Local Coding Harnesses),正成为越来越多开发者的替代选择。本文将系统探讨本地编程Agent的可行性、核心优势与现实挑战,帮你判断这条路是否适合你的场景。
什么是本地编程Agent
核心概念拆解
本地编程Agent由两个关键部分组合而成:
- 开放权重模型:模型权重公开可下载、可在本地硬件上运行的大语言模型,例如Qwen Coder、DeepSeek广告 Coder、Llama系列及各类专为代码任务优化的开源模型。
- 本地编程框架(Harness):负责调度模型、管理上下文、执行工具调用(读写文件、运行命令、检索代码库等)的Agent外壳。这类框架让模型具备"自主完成编码任务"的能力,而不只是单轮问答。
二者结合,就构成了一套可在个人电脑或私有服务器上运行、无需依赖云端API的AI编程助手系统。
延伸背景:开放权重模型 vs. 完全开源
开放权重模型(Open-Weight Models)与完全开源模型存在细微但重要的区别。完全开源通常遵循OSI(开源促进会)标准,要求训练代码、数据集、模型架构和权重全部公开,允许任何人无限制地使用、修改和再分发。而开放权重模型仅公开发布经过训练的模型参数文件,允许用户下载并在本地部署推理,但训练数据、训练流程或商业使用条款可能受到限制——例如Meta的Llama系列在特定商业场景下需要单独申请授权,DeepSeek的部分模型权重则采用MIT协议完全开放商用。
这类模型通常以GGUF(由llama.cpp项目定义的通用量化格式)、SafeTensors(Hugging Face推出的安全高效权重存储格式)等格式发布,可通过llama.cpp(纯CPU/GPU推理引擎,跨平台兼容性最佳)、Ollama(面向本地部署的模型管理和API服务工具,提供类Docker的模型拉取体验)、vLLM(高吞吐量GPU推理服务框架,适合多并发生产环境)等推理引擎加载运行,极大降低了本地部署的技术门槛。理解这一生态链条——从模型权重格式到推理引擎选型——是构建稳定本地工作流的基础。
选择推理引擎时,除模型兼容性外,还需关注几个关键性能维度:KV Cache复用率(对话历史的键值缓存命中率直接影响多轮交互延迟)、**连续批处理(Continuous Batching)支持(vLLM等框架支持动态请求合并,显著提升GPU利用率)、以及投机解码(Speculative Decoding)**技术(用小草稿模型预测多个token,再由大模型并行验证,可在不损失质量的前提下提升2-3倍生成速度)。对于本地单用户场景,llama.cpp的简单性和跨平台性通常优先于vLLM的高并发优化。
本地编程框架的技术架构
本地编程框架(Local Coding Harness)本质上是一套围绕LLM构建的Agent编排系统,实现了从单轮问答到多步骤自主任务执行的跨越。其核心技术包括:工具调用(Tool Use/Function Calling),允许模型读写文件、执行终端命令、搜索代码库;上下文窗口管理,通过RAG(检索增强生成)检索或滑动窗口策略处理超长代码库;以及任务分解与自我纠错循环,让模型能够迭代修复编译错误和测试失败。
所谓RAG(Retrieval-Augmented Generation,检索增强生成),是指在模型生成回复前,先通过向量数据库或关键词索引从代码库中检索最相关的文件片段,将其拼入上下文窗口,从而让有限的上下文窗口"按需加载"最有价值的信息,解决大型代码仓库远超模型上下文长度限制的核心矛盾。
当前主流框架在定位和特性上各有侧重:
- Aider 是最成熟的终端式框架,支持Git感知的代码编辑和多文件修改,对主流开源模型的工具调用兼容性最佳,内置"架构师-编辑器"双模型协作模式(高能力模型负责规划,轻量模型负责执行),是终端重度用户的首选。这一设计背后是**多智能体系统(Multi-Agent System)**思想的工程化落地:两个模型通过结构化消息传递协作完成复杂任务,兼顾推理质量与执行速度,本地框架也正在从单Agent架构向多Agent协作演进。
- Continue.dev 以VS Code/JetBrains插件形式提供IDE内嵌体验,支持自定义本地模型后端,上手门槛低,适合希望在现有IDE工作流中无缝接入本地模型的开发者。
- Open Interpreter 定位为通用代码执行Agent,可操作文件系统和浏览器,适合自动化脚本和跨应用任务编排场景。
- SWE-agent 由普林斯顿大学团队开发,专为自动化软件工程任务设计,引入了"Agent-Computer Interface(ACI)"概念,通过专用命令集优化模型与文件系统的交互效率,在SWE-bench基准上有强劲表现。
选择框架时需重点考察其对Ollama/llama.cpp等本地推理后端的兼容程度,工具调用实现方式(原生Function Calling vs. 提示词注入),以及是否支持你所使用的开发环境。
与商业方案的本质区别
Claude Code与Codex采用"闭源模型+云端托管"模式,用户通过订阅获得算力与模型访问权限。本地方案则把主导权交回开发者手中——模型运行在你自己的硬件上,代码从不离开本地环境。
这一差异在数据敏感型场景(如企业内部代码库、涉密项目)中尤为关键,也是很多团队选择本地部署LLM的核心动因。
本地AI编程的三大核心优势
成本可控,告别订阅绑定
商业订阅通常按月计费,重度用户还可能触及用量上限,超额部分往往需要额外付费。本地部署的边际成本几乎为零——一次性投入硬件后,无论调用多少次都不再产生额外费用。对于长期、高频使用AI编程工具的团队,从时间维度来看,本地方案的性价比通常更高。
值得注意的是,成本优势的测算需要纳入**总拥有成本(TCO, Total Cost of Ownership)**视角:初始硬件采购成本、电力消耗(一块RTX 4090在满负载推理时功耗约为350-400W)、运维人力投入,以及硬件折旧周期,都应纳入与商业订阅的对比模型中。对于推理频率极高的场景(如CI/CD流水线中的自动化代码审查),本地方案通常在12-18个月内实现成本打平,此后进入净收益阶段。
隐私保障与数据主权
本地运行意味着源代码、业务逻辑、API密钥等敏感信息完全不会上传至第三方服务器。对于金融、医疗、政府等合规要求严苛的行业,这是引入AI编程工具的重要前提,也是本地编程Agent最具说服力的差异化优势。
企业合规视角:数据主权的法律与技术双重要求
在企业合规场景中,代码数据的隐私问题远不止于"不上传"这么简单。GDPR(欧盟通用数据保护条例)要求对EU公民数据的处理必须满足明确的法律依据,并对数据跨境传输设置了严格限制;HIPAA(美国健康保险可携性和责任法案)对包含患者信息的代码和配置文件的处理设有合规要求;中国《数据安全法》和《个人信息保护法》则对重要数据的境外传输建立了安全评估机制。
商业AI编程工具的服务条款通常声明会将用户输入用于模型改进,这在知识产权保护意识强的企业中引发争议——尤其是当代码中包含专有算法或商业机密时。本地部署LLM可实现完整的数据驻留(Data Residency)控制,即确保数据在物理上始终存储和处理于指定地理范围内的服务器,满足主权云(Sovereign Cloud)要求。配合私有网络隔离(Air-gapped环境)、基于角色的访问控制(RBAC)和完整的API调用审计日志,可满足ISO 27001(信息安全管理体系)、SOC 2 Type II(服务组织控制报告)等企业级信息安全认证的要求,成为金融科技、医疗健康、国防等强监管行业合规采用AI编程工具的可行路径。
离线可用,稳定性更强
本地Agent不受网络波动、云服务限流或供应商政策变动的影响。无论是在飞机上、网络受限的开发环境,还是遭遇云服务宕机时,本地方案都能保持稳定运行,彻底规避"云端依赖"带来的不确定性。
从**系统可靠性工程(SRE)**的角度来看,依赖外部云服务的工具链会将第三方服务的SLA(服务等级协议)直接引入自身的开发流程稳定性方程。主流商业AI服务的可用性目标通常为99.9%(对应每年约8.7小时停机时间),而实际上偶发的限流(Rate Limiting)和服务降级会以更高频率影响开发体验。本地方案将可用性掌控权收归自身,尤其适合对连续性要求严苛的生产环境DevOps场景。
现实挑战:必须正视的三道门槛
硬件门槛不可忽视
运行高质量的开源代码模型需要一定的算力支撑。较小的模型(7B、14B参数级别)可在配备较高显存的消费级GPU上运行,但要接近Claude或GPT级别的编码能力,往往需要参数量更大的模型,这对显存和内存提出了更高要求。
硬件选型参考:GPU、苹果芯片与量化的三角权衡
GPU显存是核心瓶颈,其根本原因在于LLM推理需要将完整的模型权重常驻显存以实现低延迟生成:运行7B-14B参数模型(如Qwen2.5-Coder-14B)需要至少8-16GB显存;NVIDIA RTX 3090/4090(24GB)可流畅运行量化版32B模型;对于追求接近商业模型能力的场景,多卡NVLink配置或配备大容量统一内存的Apple Silicon芯片是性价比较高的方案。
Apple Silicon的独特优势在于其统一内存架构(Unified Memory Architecture, UMA)——CPU、GPU和神经网络加速器共享同一内存池,消除了传统架构中CPU RAM与GPU VRAM之间的数据搬运瓶颈。M3 Ultra最高支持192GB统一内存,理论上可运行未量化的70B级别模型,且相比同等显存容量的NVIDIA多卡方案,功耗更低、配置更简单。但其GPU核心数量和原始浮点算力仍弱于高端NVIDIA GPU,在批量并发推理场景下吞吐量存在差距。
量化技术虽能降低资源占用,但也会带来一定程度的能力损失,需要结合实际任务场景权衡。**量化(Quantization)**是将模型权重从高精度浮点数(如FP32、BF16)压缩为低精度整数(如INT8、INT4)的技术,可将模型显存占用减少50%-75%,同时大幅提升推理速度(因内存带宽瓶颈减轻)。例如,一个70B参数的模型在BF16精度下需要约140GB显存,经INT4量化后可压缩至约35-40GB,恰好进入双卡RTX 4090的可运行范围。
代价是模型在部分推理任务上出现轻微性能下降——研究表明,INT4量化通常导致基准测试分数下降1%-5%,对代码生成(语法结构强、可通过编译运行验证)的影响通常小于对开放式逻辑推理任务的影响。当前主流量化方案包括GPTQ(基于逐层最优化的训练后量化)、AWQ(激活感知权重量化,对重要权重保留更高精度)和GGUF Q4_K_M等格式,在压缩率和精度保留之间提供了多档次选择。
与顶级商业模型仍有能力差距
必须客观承认,当前顶级开放权重模型在复杂推理、长上下文处理、工具调用稳定性等方面,与最前沿的商业模型仍存在差距。对于简单到中等复杂度的编码任务,本地模型完全胜任;但面对需要跨文件深度重构、复杂架构设计的任务时,商业模型的表现往往更可靠。
这一差距的技术本质在于多个维度的叠加:顶级商业模型通常拥有更大的参数规模(如GPT-4估计超过1万亿参数的混合专家架构)、更大规模和更高质量的训练数据、以及更精细的**RLHF(基于人类反馈的强化学习)和RLAIF(基于AI反馈的强化学习)**对齐调优。好消息是,对于代码生成这一相对结构化的任务,能力差距比通用推理任务小,且差距正在以可量化的速度缩小。
框架生态尚未完全成熟
本地编程框架的生态正在快速发展,但与打磨成熟的商业产品相比,在易用性、集成度和用户体验上仍有提升空间。开发者需要投入一定精力进行配置、调优和日常维护,这对非专业运维的个人开发者是一个额外负担。
具体体现在:不同推理后端与框架之间的API兼容性问题(各家对OpenAI兼容接口的实现存在细节差异)、工具调用在非原生支持模型上的稳定性问题(需要通过提示词工程模拟Function Calling),以及模型更新后需要手动拉取和迁移的运维成本。未来随着**MCP(Model Context Protocol,Anthropic提出的模型上下文协议)**等标准化接口协议的推广,本地框架与各类工具的集成有望进一步标准化,降低生态碎片化程度。
如何选择:务实的混合使用策略
按场景分层,不必非此即彼
最理性的策略是混合使用,而非全盘替换:
- 高频轻量任务(代码补全、简单重构、注释生成等)交给本地Agent,节省费用同时保护隐私;
- 高难度关键任务(需要顶级推理能力的复杂架构设计、大规模重构)再启用商业订阅服务。
这种分层策略既能显著降低订阅成本,又不会在关键节点因能力不足而影响交付质量。实践中,可以通过**任务路由(Task Routing)**机制自动化这一决策:基于任务复杂度评估(文件数量、跨模块依赖度、测试失败层级等指标)动态选择调用本地模型还是商业API,在成本控制与能力保障之间实现动态平衡。
押注开源模型的迭代速度
开放权重模型的进步速度惊人。近几年,开源代码模型与闭源模型之间的能力差距正在快速收窄。
以SWE-bench为参照——这是由普林斯顿大学研究团队发布的软件工程基准测试集,包含来自GitHub真实仓库的2294个问题(覆盖Django、Flask、NumPy、Scikit-learn等12个主流开源项目),要求AI模型根据Issue描述自动定位并修复代码缺陷,评估指标为"已解决率(% Resolved)"。
SWE-bench之所以成为衡量编程Agent能力的权威基准,在于其测试设计高度贴近真实软件工程场景:每个测试用例均来自GitHub上真实合并的Pull Request,模型需要在不知道解决方案的前提下,仅凭Issue文本和代码库上下文定位问题并生成补丁,最终通过原始仓库的测试套件验证。这与传统代码生成基准(如HumanEval、MBPP)存在本质区别——后者通常是从零生成孤立函数,而SWE-bench考察的是在数万行存量代码中的理解、导航与精确修改能力,后者恰恰是实际工程开发的核心挑战。与侧重代码生成的基准不同,SWE-bench考察的是在真实大规模代码库中理解、定位和修复缺陷的完整能力链,是目前衡量编程Agent实战能力最具说服力的基准之一——2023年初开源模型的解题率几乎为零,而到2024年底,DeepSeek-Coder-V2等开源模型已能在部分编程基准上与GPT-4级别模型竞争。
这一趋势的驱动因素包括:开源社区的规模化协作、合成数据训练技术的突破,以及蒸馏技术的成熟。
合成数据训练是指通过程序化方法或强模型自动生成训练样本,而非完全依赖人工标注数据的技术路线。在代码领域,**执行反馈(Execution Feedback)**是核心范式:生成候选代码后通过沙箱实际运行,以测试通过率、编译成功率、代码覆盖率等可量化指标作为奖励信号,进行强化学习(RL)训练或过滤筛选高质量样本用于监督微调(SFT)。这种方法的革命性在于:代码的正确性可以被客观、自动地验证,使得"数据飞轮"可以完全无需人工介入地高速运转,突破了人工标注数据的规模瓶颈。DeepSeek-Coder、Qwen-Coder等模型快速追赶顶级闭源模型的背后,均有大规模执行反馈训练的技术支撑。
**蒸馏技术(Knowledge Distillation)**则通过将大型"教师模型"的能力系统性迁移至小型"学生模型",使后者在参数量更小的情况下实现接近前者的推理质量。在代码领域,常见做法是使用顶级闭源模型(GPT-4、Claude等)生成高质量代码示范数据,再用这些数据微调开源小模型——这一路径在法律上存在争议(部分商业模型服务条款明确禁止将输出用于训练竞争模型),但已成为开源模型快速提升基础能力的重要技术路径,推动了整个开源代码模型生态的能力跃升。
搭建本地编程工作流,不只是当下的降本手段,更是对未来技术趋势的提前布局。
结语:本地编程Agent的未来值得期待
本地编程Agent代表了AI辅助编程"去中心化"的一条可行路径。它以硬件投入和一定的能力妥协,换取了成本可控、数据私有、离线可用等实实在在的价值。对于注重隐私保障、追求成本效益、或希望摆脱订阅绑定的开发者而言,将开放权重模型接入本地编程框架,正从极客圈的实验性探索,逐步演变为一种切实可行的生产力选择。
随着开源模型和本地框架生态的持续成熟,以及量化技术、硬件性价比的持续提升,这条路径的吸引力只会越来越强。今天选择搭建本地编程工作流的开发者,不仅是在解决当下的成本与隐私问题,更是在为下一波AI编程能力的民主化浪潮提前做好准备。
核心要点
- 本地编程Agent = 开放权重模型 + 本地编程框架,二者缺一不可,模型提供智能,框架提供自主执行能力
- 三大核心优势:零边际成本、完整数据主权、离线稳定可用,三者共同构成对商业方案的差异化价值
- 三道现实门槛:硬件显存瓶颈(量化是核心缓解手段)、与顶级商业模型的能力差距、框架生态成熟度
- 最优策略是混合使用:轻量任务走本地,高难度关键任务走商业API,按TCO和任务路由逻辑动态决策
- 押注开源趋势:合成数据+执行反馈+蒸馏技术三驾马车正在驱动开源代码模型以惊人速度追赶闭源前沿,SWE-bench等基准已印证这一趋势不可逆
相关推荐
Vibe Coding是什么?程序员必须掌握的AI编程能力
Vibe Coding(AI编程)到底是什么?本文解析AI编程如何重塑研发流程、为何传统程序员面临淘汰、Cursor与Claude Code两大工具,以及程序员、PM、运营等岗位为何都该掌握这项能力。
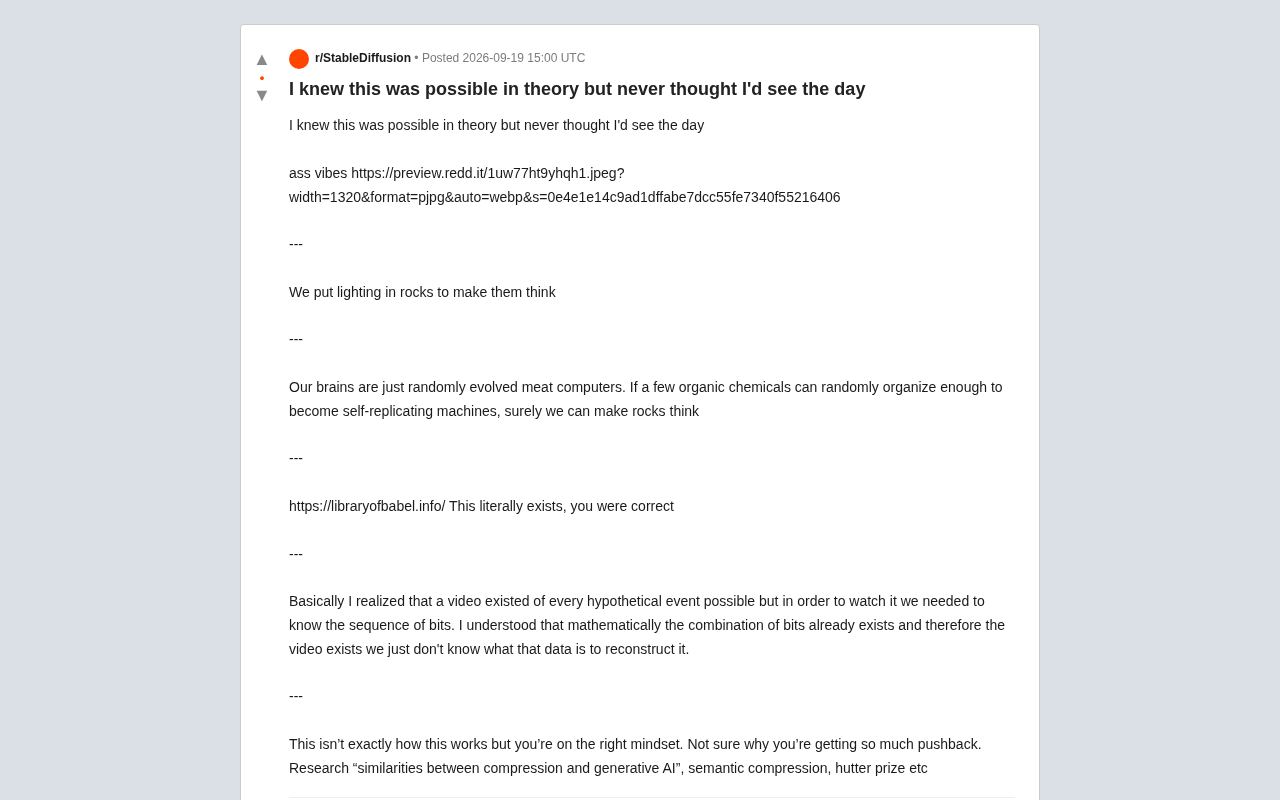
让石头思考:生成式AI与信息压缩的哲学思考
从Reddit热帖「让石头思考」出发,探讨生成式AI的信息论本质:为何压缩等价于理解,巴别图书馆式的可能性空间思辨,以及语义压缩、Hutter Prize与AI原理的深层联系。
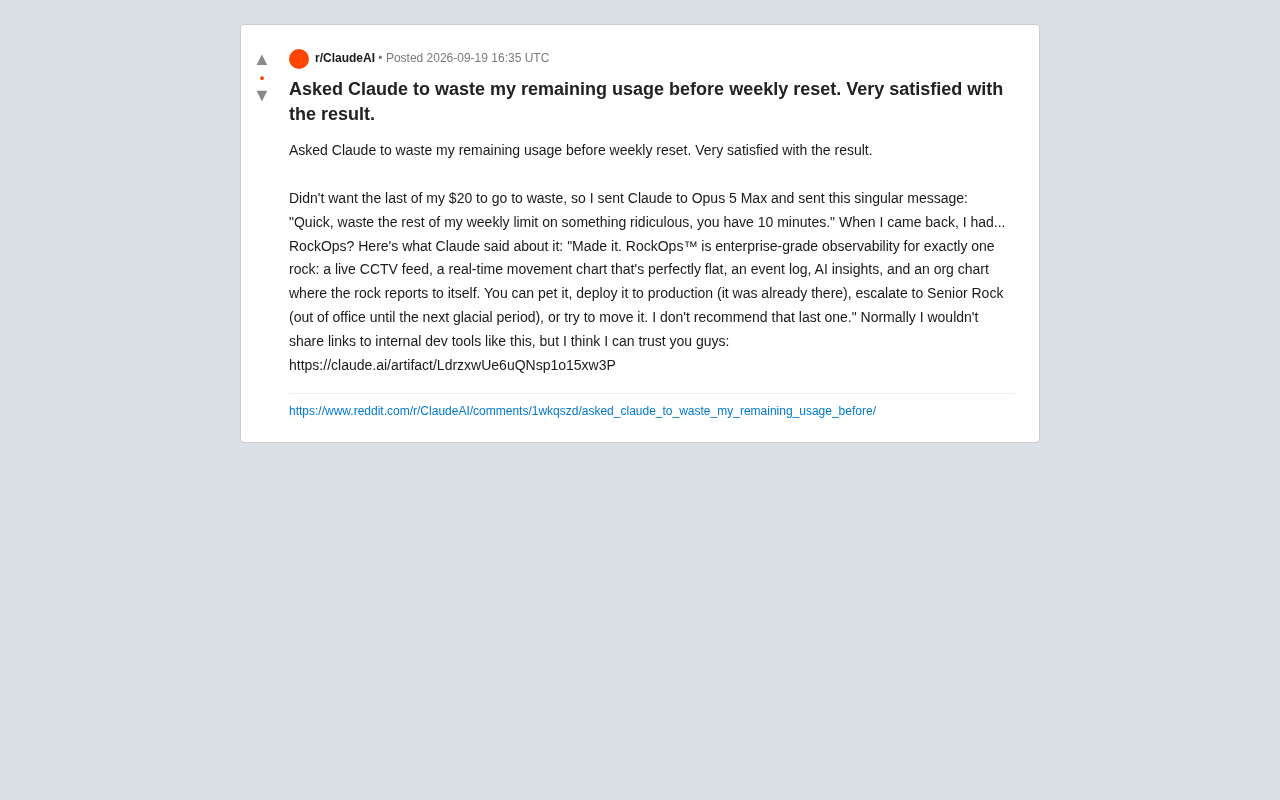
让Claude"浪费"额度:一场AI创造力的意外实验
一位Reddit用户让Claude用剩余额度"做件荒唐的事",结果AI生成了监控一块石头的企业级平台RockOps。本文分析这一趣味案例背后的AI创造力与产品设计能力。