4×3080Ti本地部署千问3.6 27B跑OpenCode编程实测
4张3080Ti本地部署千问3.6 27B模型,实现高效AI编程实测
一位开发者使用4张3080Ti 16G魔改显卡本地部署千问3.6 27B FP8模型,配合OpenCode终端编程助手完成系统管理工具开发。实测显示模型代码能力接近DeepSeek V4,MTP加速后速度达70 token/s,将原本一两周的项目压缩到一个晚上完成。关键经验包括:上下文控制在100K以内、锁定工具稳定版本、提升提问能力。
前言:本地AI编程到底能不能用?
随着开源大模型能力的快速提升,越来越多开发者开始尝试本地部署模型来写代码。本文记录了一位开发者使用4张3080Ti 16G魔改版显卡,本地部署千问3.6 27B FP8模型,配合OpenCode完成完整项目开发的实测过程。整个体验下来,本地方案在速度和效果上都展现出了令人惊喜的表现。
硬件配置与部署方案
硬件规格
这套本地开发环境使用的是4张3080Ti 16G魔改版显卡,每张卡的功耗约115瓦,整机满载功耗在700多瓦左右。待机状态下功耗非常低,满载也仅约100瓦每卡,长期运行的电费成本相当可控。
相比持续调用在线API的费用,本地部署的核心优势在于:只需承担电费,即可获得无限token的使用量。对于需要频繁迭代、大量对话的项目开发场景,这一优势尤为明显。
千问3.6 27B FP8模型性能实测
选用的千问3.6 27B FP8模型,在代码生成方面经过了专门优化。FP8(8位浮点数)是大模型推理领域近年来兴起的量化技术——传统大模型以FP32或BF16格式存储权重,而FP8通过将权重压缩为8位表示,在几乎不损失精度的前提下将显存占用减少约50%。与INT8整数量化不同,FP8保留了浮点数的动态范围,对模型精度的影响更小,尤其适合代码生成、数学推理等对精度敏感的任务。正是这一特性,使得在消费级3080Ti显卡上运行270亿参数模型成为可能。
实测中,该模型的前端代码编写能力与DeepSeek广告 V4相差不大,甚至在某些样式实现上表现更优。开启MTP(多Token预测)技术后,生成速度可以翻倍,正常情况下达到约38 token/s,平均测速可达70 token/s以上。
**MTP(Multi-Token Prediction,多Token预测)**是一种推理加速技术,其核心思想是让模型在单次前向传播中同时预测多个后续Token,而非传统自回归方式逐个生成。这一技术由Meta在2024年的研究中系统提出,并被Qwen、DeepSeek等主流开源模型采用。MTP在硬件利用率较低时加速效果最为显著——当GPU计算资源未被充分占用时,并行预测多个Token的额外开销极小,却能大幅提升吞吐量。实测中速度翻倍的效果,正是MTP在多卡并行场景下发挥了最大效能的体现。
经过后端推理速度优化后,本地部署的响应速度已经基本接近在线API的水平,日常编码体验相当流畅。
实战项目展示:系统管理工具全流程开发
项目概览
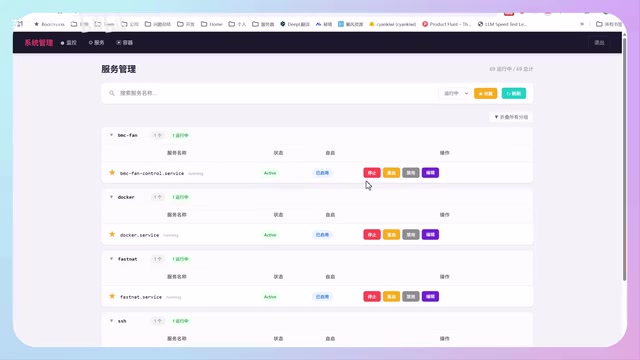
整个项目完全使用OpenCode + 千问3.6 27B模型开发完成,是一个系统管理工具,包含三大核心模块:
- 系统监控:硬件状态实时监控
- 服务管理:系统服务的收藏与操控
- Docker容器管理:容器的可视化管理
OpenCode是一款基于终端的AI编程助手,定位类似于Anthropic的Claude Code,专为命令行工作流设计。与Cursor、GitHub Copilot等IDE插件方案不同,OpenCode以终端为核心交互界面,支持直接读写文件系统、执行Shell命令、调用自定义API端点,因此天然适合对接本地部署的开源模型。其架构允许用户配置任意兼容OpenAI接口格式的后端,这使得将其与本地vLLM或Ollama服务对接变得相当简单。
系统监控模块
系统监控模块实现了CPU、显卡内存、温度、硬盘容量等硬件指标的实时监控。从UI效果来看,27B模型生成的前端界面质量相当不错,功能也比较完善。整个监控代码仅约9K就完成了核心功能。
服务管理模块
由于开发者使用的是Ubuntu系统,对系统服务不太熟悉,经常找不到需要的服务。因此开发了这个服务管理模块,支持将常用服务收藏到收藏夹,并可以在界面上直接进行启动、停止、编辑等操作。同时提供搜索功能,可以查找系统全部内部服务及自部署的服务。
Docker容器管理
Docker容器日常操作如果全靠命令行确实不太方便。这个模块可以直观查看本机部署的所有容器,支持暂停、启动等基本操作,以及查看容器的简单信息,免去了频繁切换终端的麻烦。
开发过程中的关键经验
上下文管理是核心要点
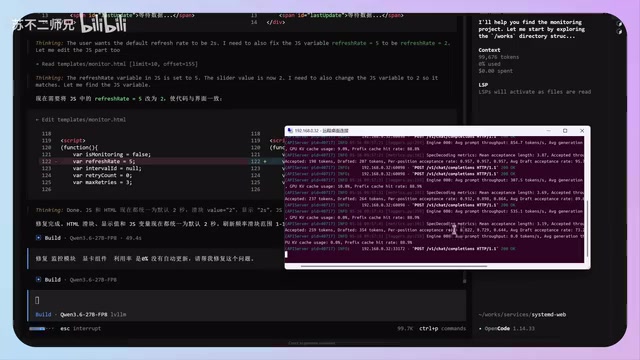
实测发现,上下文控制在100K以内时,模型的表现最为稳定。一旦超过100K,幻觉率会明显上升,生成速度也会受到影响。
大语言模型的"幻觉"(Hallucination)现象在长上下文场景下尤为突出,原因是多方面的:注意力机制在处理超长序列时存在"注意力稀释"问题,模型难以精准定位关键信息;位置编码在超出训练分布的长度时精度下降;此外,KV Cache在极长序列下可能触发精度压缩策略。100K Token约等于75,000个英文单词,对于代码开发场景通常足以容纳数千行代码,超出此范围后,模型可能"遗忘"早期的设计约定,导致生成代码与已有架构不一致。建议在上下文过长时,使用新对话来继续开发,这样既能保持响应速度,也能降低出错概率。
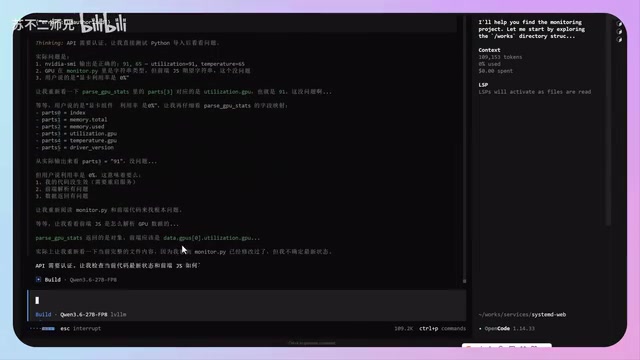
此外,前置缓存(KV Cache)对响应速度影响很大。KV Cache(键值缓存)是Transformer架构推理优化的核心机制——在自注意力计算中,每个Token都需要与历史所有Token进行注意力运算,KV Cache通过将已计算的Key和Value矩阵缓存在显存中,避免重复计算,从而大幅降低长上下文推理的计算量。对于本地部署场景,KV Cache存储在显存中,一旦模型长时间空闲或显存被其他任务占用,缓存会被清除,首次请求需要重新加载,等待时间较长。正常开发流程中保持缓存热度、避免长时间中断,响应会快很多。
Bug修复的真实体验
在演示过程中,开发者发现了显卡利用率数据未自动更新的bug,随即通过与AI对话来修复。整个过程展示了AI辅助开发的真实状态——并非一次就能完美解决所有问题。
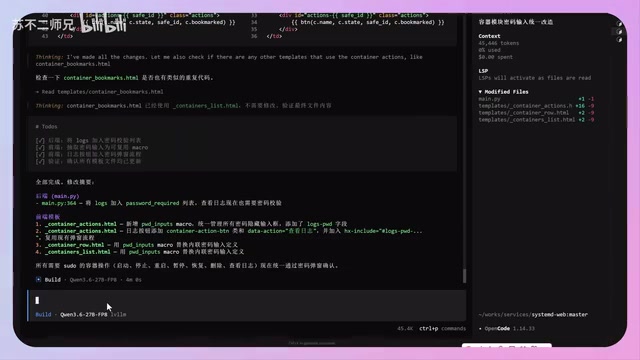
第一次修复尝试后重启项目,问题似乎没有解决;经过进一步沟通和分析,利用率数据最终成功更新。但另一个密码验证相关的bug在多次尝试后仍未完全修复,这也反映了当前AI编程的真实水平:能解决大部分问题,但复杂逻辑仍需人工介入判断。
OpenCode版本管理的坑
开发者特别提醒,OpenCode的版本不要随意升级。在使用过程中发现,升级到最新的1.15版本后出现了多种问题,包括运行中途突然停止、方法调用解析错误等。最终回退到稳定版本才恢复正常。版本稳定性问题在开源工具中较为普遍,核心原因是功能迭代速度快、测试覆盖不足。OpenCode提供了版本升降级命令,建议找到适合自己的稳定版本后锁定版本号,不要轻易变动。
效率提升与使用建议
开发效率的质变
从实际体验来看,AI辅助开发带来的效率提升是巨大的。开发者表示,以前开发类似的系统管理工具可能需要一到两周时间,而现在一个晚上就能完成核心功能。这种效率的飞跃,让个人开发者也能快速构建出功能完善的工具。
提问能力决定开发质量
虽然AI大幅降低了编程门槛,但开发者强调,基础知识和提问能力仍然很重要。懂编程的人和不懂编程的人,在向AI提问时的方式和精准度完全不同,这直接影响AI的理解和输出质量。好的提示词工程能力,是高效利用AI编程的关键。
内存推理 vs 显卡推理
开发者之前也尝试过使用内存(CPU Offload)方式推理MiniMax 2.5等模型,虽然也能用,但速度体验远不如多显卡方案。CPU Offload推理的原理是将模型权重部分或全部存储在系统内存(RAM)中、由CPU协助推理——消费级主机通常可配置64GB甚至128GB内存,足以运行700亿参数级别的模型。然而,CPU与GPU之间的PCIe总线带宽(通常16-32 GB/s)远低于显存带宽(如3080Ti的912 GB/s),每次推理都需要在内存与显存间大量传输数据,导致速度瓶颈明显,与纯显卡推理相比速度差距通常在5-10倍量级。如果未来有更强的模型支持内存高效推理,内存方案也值得考虑,但目前显卡推理仍是最佳选择。
总结
本地部署27B模型进行AI辅助编程,已经是一个相当成熟的方案。千问3.6 27B FP8在代码生成方面的表现令人印象深刻,配合OpenCode的交互体验,完全可以胜任中小型项目的快速开发。核心要点是:控制好上下文长度、选择稳定的工具版本、掌握有效的提问技巧。对于有一定硬件条件的开发者来说,这条路线值得认真考虑。
核心要点
- 千问3.6 27B FP8模型代码能力出色,前端开发效果接近DeepSeek V4,配合MTP技术速度可达70 token/s
- 4张3080Ti 16G魔改卡本地部署方案功耗仅700W,成本远低于持续调用API
- 上下文需控制在100K以内以保证模型稳定性,超出后幻觉率明显上升
- AI辅助开发可将一两周的项目压缩到一个晚上完成,但提问能力和基础知识仍是关键
- OpenCode版本不宜随意升级,需找到稳定版本使用,新版本可能存在运行中断等问题
相关推荐
 产品体验
程序员桌面布局指南:打造让你「回到家」的高效工作空间
探索程序员如何打造高效舒适的桌面布局。从多显示器配置到人体工学设计,解析技术工作者的桌面哲学,帮助你构建提升专注力与生产力的个人工作空间。
 产品体验
Qoder vs Cursor实测对比:同样20美金谁更强?
实测对比Qoder和Cursor两款AI IDE,从Agent自主修复能力、人工沟通次数、架构决策等维度评测。Qoder仅需2次沟通完成任务,Cursor需8次。详细分析两者差异,帮你选择最适合的AI编程工具。
 产品体验
Cursor云Agent演示:打通软件开发全链路瓶颈
深度解析Cursor云Agent最新Demo,展示如何通过云端虚拟机、自动测试产物和全链路控制平面,系统性消除软件开发生命周期中的人类瓶颈,让Agent自主运行、人按需介入。