本地部署Laya决策模型:45ms响应、零成本的开源替代方案
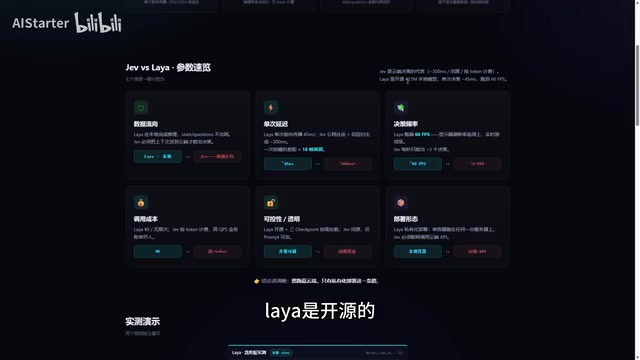
开源本地决策模型Laya以421MB体积、45ms延迟全面超越云端收费方案Jev,并支持一键部署。
本文围绕两款实时决策模型展开对比:云端闭源的Jev与开源本地的Laya。在同一游戏场景测试中,Jev因云端网络往返延迟约300ms而迅速失败,而Laya本地运行仅45ms延迟、可达60fps,最终以26比1的比分胜出。Laya不仅性能更优,还完全开源、零Token费用、数据不出本地。针对开源模型部署门槛高的问题,UP主将Laya上架至Panel AI平台,实现一键部署,用户只需搜索、安装、复制API地址即可接入。部署时需注意提前调通服务器网络,避免大体积镜像下载失败。任何支持该API地址的应用均可接入Laya完成决策任务,扩展性灵活。
一场决策模型的对比引发的讨论
最近两周,一个名为 Jev(视频中读作JUG)的决策模型在圈内颇受关注,但它有一个明显的短板——不开源,且按 Token 计费。仅仅三天后,一个开源模型 Laya 就被拿出来做正面对比,成为讨论焦点。
从 B站 UP 主的实测演示来看,两者在同一游戏场景下的表现差距肉眼可见。左侧运行 Laya、右侧运行 Jev 的对比中,Jev 很快就 GAME OVER,而 Laya 仍在稳定运行,最终比分定格在 26 比 1。UP 主直言,效果"差的不是一点半点"。
这种差距的根源并不复杂:Jev 是云端决策模型,每次决策都要等待服务器响应,延迟自然更高;而 Laya 是本地运行,省去了网络往返的时间开销。
Jev 与 Laya 的核心参数对比
把两者的关键参数摊开来看,差异一目了然:
Jev:云端决策的代表
- 决策延迟约 300 毫秒
- 闭源,按 Token 计费
- 数据需要上行到服务器
Laya:轻量开源方案
- 模型体积约 421MB
- 单次决策仅 45 毫秒
- 可跑到 60fps
- 完全开源,数据留在本地
300 毫秒对 45 毫秒,这在实时决策场景(例如游戏 AI)中是决定性的差距。对于需要连续、高频决策的任务,云端方案的每一次网络往返都会累积成明显的卡顿,而本地模型几乎可以做到实时响应。更关键的是,Laya 把数据留在本地,既省去了 Token 费用,也规避了数据上行带来的隐私顾虑。
这里的"决策模型"指的是专门为实时行为控制设计的轻量推理模型,与通用大语言模型(LLM)有本质区别。通用 LLM 的参数量通常在数十亿到数千亿级别,推理一次需要大量显存和算力;而决策模型的目标是以极低延迟输出离散动作指令(如上、下、左、右),因此可以被压缩到几百 MB 以内,在普通硬件上实时运行。Laya 的 421MB 体积和 45ms 延迟,正是针对这一场景做了高度裁剪的结果——它不需要理解复杂语义,只需要根据当前状态快速输出一个动作决策。这也是为什么它能达到 60fps 级别的响应频率,而同等规模的通用模型根本无法做到。
为什么此前没人讲清楚部署方法
UP 主提到一个现实问题:看了一圈相关视频,几乎没人说明 Laya 到底该怎么部署,"压根就不知道,也不好弄"。这也是开源模型落地时常见的门槛——模型本身开放,但环境配置、依赖安装往往劝退普通用户。
针对这一痛点,UP 主把 Laya 上架到了 Panel AI(视频中称 PANDAI),做成了一键部署的形式,并且程序本身免费。这相当于把原本需要手动折腾的部署流程,压缩成了应用市场里的"点一下"。
开源模型的"部署门槛"是社区长期存在的痛点。即便模型权重和代码完全公开,用户仍需自行处理 Python 环境版本、CUDA 驱动兼容性、依赖库冲突、端口配置等问题,任何一个环节出错都可能导致安装失败。对于没有 Linux 或容器化经验的用户,这些步骤往往需要数小时甚至数天排查。容器化(如 Docker 镜像)技术的出现大幅简化了这一过程——它将模型和所有运行时依赖打包成一个标准镜像,用户只需拉取镜像并启动容器即可,无需关心底层环境。Laya 在 Panel AI 上的一键部署正是基于这一机制,镜像体积较大也正是因为其中包含了完整的模型文件和运行环境。
通过 Panel AI 一键部署 Laya 的流程
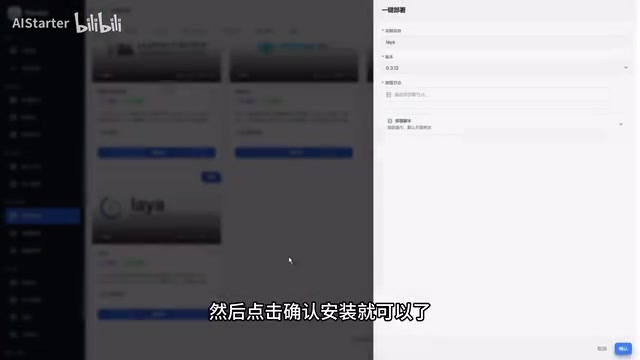
整个部署过程被简化到了几步:
- 打开 Panel AI,进入应用市场
- 在"全部"中搜索 Laya,或直接下拉找到它
- 点击一键部署,选择节点后勾选,确认安装
- 安装完成后,在应用列表中找到 Laya 并打开
- 打开后页面会给出一个 API 地址,复制它
- 将该地址粘贴到 demo 工具中,点击保存并应用即可接入
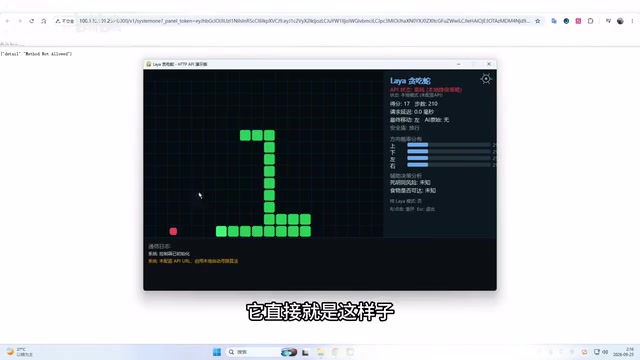
UP 主特地做了一个 demo 来验证部署是否成功。由于他把服务部署在公司服务器上,演示时帧率仍能达到 60~80fps;如果是本机或局域网部署,延迟会更低、更流畅。
值得一提的是,只要是支持该 API 请求地址的应用,都可以接入 Laya,让它来完成决策任务。这种基于标准 API 的接入方式,扩展性相对灵活。
这里的 API 地址本质上是一个本地或局域网内的 HTTP 服务端点,格式通常形如 http://localhost:端口号 或 http://内网IP:端口号。Laya 部署完成后会在后台启动一个推理服务,外部程序通过向该地址发送 HTTP 请求(携带当前游戏状态作为输入),即可收到模型返回的动作指令。这种设计遵循了"模型即服务"(Model as a Service)的理念,使得 Laya 可以像调用外部 API 一样被任意支持 HTTP 的客户端接入,而不局限于特定编程语言或框架。开发者只需更换 API 地址,就能在本地推理和云端推理之间灵活切换,迁移成本极低。
实际决策效果与使用注意事项
演示中还展示了对照组:在"纯 Laya 且没有启动"的状态下,游戏角色会直接撞墙、很快死掉。这说明 Laya 的核心作用是提供上下左右的方向决策,一旦缺失就失去了智能行为。启用后,角色的行动就变得有条理起来。
部署环节有一个需要特别注意的点:Laya 的镜像包含模型、体积较大,如果直接用免费镜像加速服务,容易出现抖动、导致安装失败。UP 主建议先在系统设置里把服务器的网络环境调通,再执行安装,成功率会明显提高。
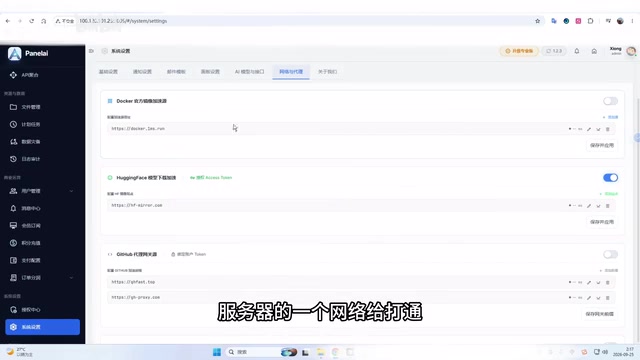
此外,Panel AI 平台上还有不少项目已经进入正式版,包括模型、插件、技能等,都支持一键安装。应用部署完成后,可在"资源授权"或插件设置里勾选,让项目调用本地模型运行。
小结
Laya 的价值不在于参数有多惊艳,而在于它给出了一条务实的路径:用一个仅 421MB 的开源本地模型,替代按 Token 计费的云端决策服务,把单次决策延迟从 300 毫秒压到 45 毫秒,同时实现零成本和数据本地化。对于实时性要求高、又不想被云端费用和延迟束缚的开发者来说,这是一个值得尝试的方向。而借助 Panel AI 的一键部署,原本的技术门槛也被大幅降低。
相关推荐

气态巨行星上的浮空城市:为什么人类终将移居木星云端
SFIA 主持人 Isaac Arthur 重新定义气态巨行星浮空城市:它们不是等待聚变的燃料站,而是散装氢、氦、氮的"质量城市"。本文解析其工程原理、供电方案与从工业前哨到文明家园的演化逻辑。

用Claude Code一天半做出AI测验:Vibe Coding的真实样本
一位开发者用Claude Code结合Opus 5.5与Fable 5.1,在一天半内做出一款PS1复古风格的AI主题测验游戏。本文解析这个业余项目背后的AI辅助编程实践与行业启示。

用Claude+Muse打造自动化膳食规划:AI如何替代HelloFresh
一位不懂编程的Reddit用户用Claude和Muse搭建了自动化膳食规划系统,涵盖菜单规划、沃尔玛自动下单、厨房平板界面,号称HelloFresh杀手。本文解析其工作流与AI生活自动化的启示。