本地部署Qwen3.5:用Ollama与OpenClaw打造免费AI智能体

用Qwen3.5+OpenClaw+Ollama在本地搭建零订阅、数据不出机的全功能AI智能体。
本文介绍如何将阿里巴巴的Qwen3.5多模态模型、OpenClaw智能体运行时与Ollama本地推理服务三者整合,构建一套完全离线、无需云端订阅的AI智能体栈。Qwen3.5采用Gated Delta Networks与稀疏MoE混合架构,35B版本在24GB显存下即可支持256K上下文与图像理解。Ollama通过兼容OpenAI的本地接口屏蔽底层复杂度,OpenClaw则作为常驻运行时连接Telegram、Slack等消息渠道,提供持久记忆、工具调用与Playwright浏览器自动化。文章从环境准备、安装配置、Apidog链路验证,到性能优化、实际工作流与安全加固,覆盖完整落地路径,并指出每处细节配置对速度与可靠性的实质影响。
每天运行强大的AI智能体,云端账单会迅速攀升。而本地部署给出了另一条路径——用Qwen3.5提供前沿级的多模态推理能力,搭配OpenClaw构建持久化的智能体工作流,再用Ollama完成简单的本地服务。三者组合后,你能在自己的机器上得到一个全天候运行、无需订阅的完整AI智能体。
本文梳理从环境准备到优化调试的完整链路,帮助你搭建一套完全自主可控的本地AI栈。
Qwen3.5为何适合本地智能体
阿里巴巴推出的Qwen3.5是其首个原生视觉-语言模型家族。旗舰版397B-A17B采用混合架构,将Gated Delta Networks与稀疏专家混合(MoE)结合,每个token仅激活170亿参数。这意味着你能在显著更低的显存占用下获得强劲性能。
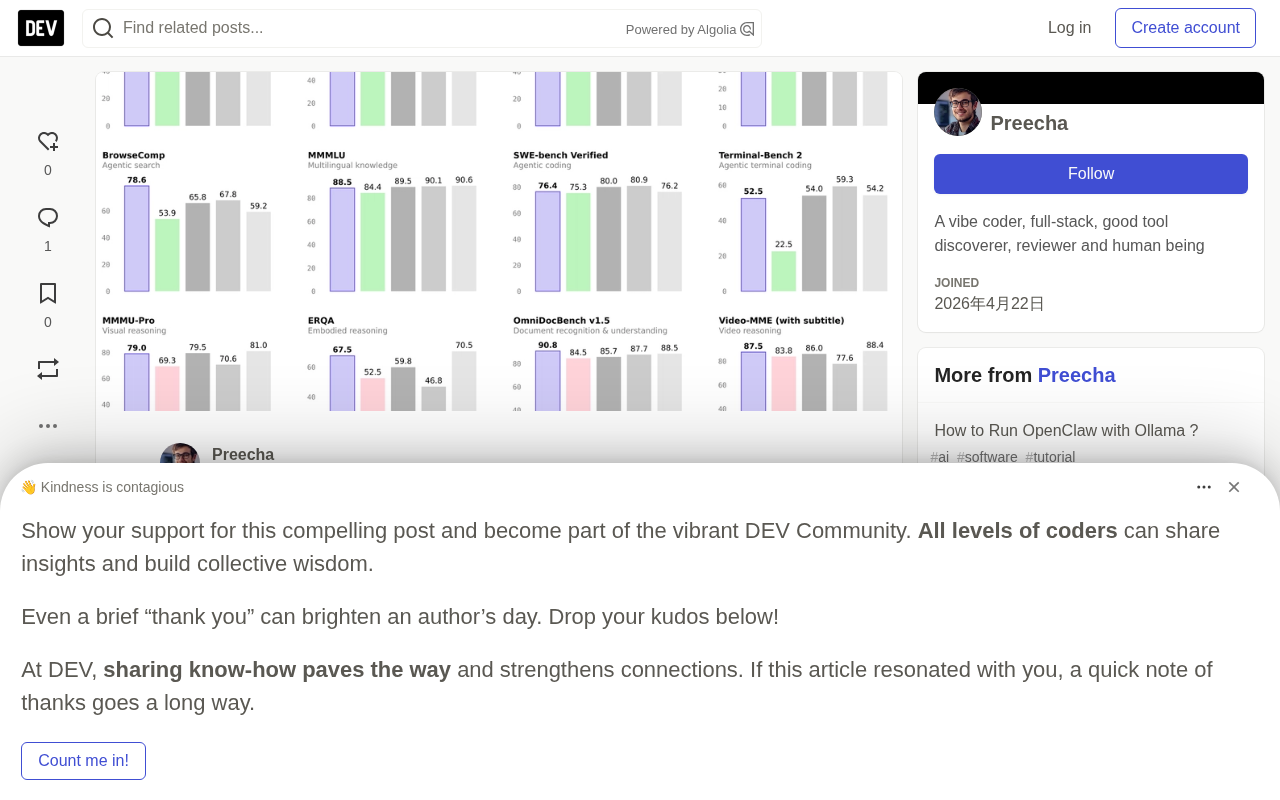
Ollama上可直接拉取的实用标签包括:
qwen3.5:35b—— 适配24GB显存,支持256K上下文,具备完整的文本与图像能力qwen3.5:122b—— 需要81GB显存,用于更深层的推理
本地运行qwen3.5意味着数据不出本机。该模型在TAU2-Bench上得分86.7,在MMMU上得分85.0,足以胜任混合文本、截图与工具调用的智能体任务。
稀疏专家混合(MoE,Mixture of Experts)是一种将模型拆分为多个"专家"子网络的架构设计。推理时,每个token只经过门控网络选出的少数几个专家,而非激活全部参数。以397B-A17B为例,总参数量虽达3970亿,但每次前向传播仅调用170亿,计算量与同等激活规模的稠密模型相当,却保留了大模型的知识容量。Gated Delta Networks则是一种线性注意力机制的变体,通过门控差分更新来替代标准Transformer中计算复杂度为O(n²)的自注意力,在处理超长上下文时显存占用更为平稳。两者结合使得Qwen3.5在消费级GPU上运行256K上下文成为现实,而非仅停留于理论参数。
OpenClaw如何把模型变成真正的智能体
OpenClaw广告作为常驻的智能体运行时,可一次性连接WhatsApp、Telegram、Slack、Discord或Signal。智能体会持续监听,当你发送消息时,OpenClaw将请求路由给qwen3.5,调用工具、通过Playwright控制浏览器、编辑文件、更新日历,并能主动响应。
它在会话之间持久化存储记忆,长期记住你的项目与偏好。你可以安装社区技能,也可以让qwen3.5按需编写新技能。由此,OpenClaw成为一个永不休眠的个人数字助手。
持久化记忆是OpenClaw区别于单次对话的核心机制。传统大模型每次对话都从空白上下文开始,无法跨会话记住用户偏好或项目状态。OpenClaw通过在本地数据库中存储结构化的记忆条目,在每次请求前将相关记忆检索并注入到系统提示中,使模型"看起来"能够记住历史。Playwright浏览器自动化则赋予智能体操控真实网页的能力:它可以点击按钮、填写表单、截取当前页面状态,再将截图送入Qwen3.5的视觉通道进行理解,从而完成需要视觉感知与操作闭环的复杂任务,例如登录网页后台、提取动态渲染的数据等。
Ollama让集成变得简单
Ollama在本地提供模型服务,并在11434端口暴露一个兼容OpenAI的接口。你只需将OpenClaw指向http://localhost:11434/v1,并把模型设为qwen3.5:35b,剩下的量化、GPU卸载与上下文管理Ollama会自动处理。
这套方案在消费级硬件上也能实现较快的token生成,同时保留智能体长对话所需的完整256K上下文窗口,既避免了云端成本,也杜绝了数据外泄。
兼容OpenAI接口(OpenAI-compatible API)是指Ollama在11434端口实现了与OpenAI官方REST API相同的请求与响应格式,包括/v1/chat/completions、/v1/models等端点及其JSON结构。这意味着任何原本为调用GPT-4而编写的客户端代码,只需将base_url从https://api.openai.com改为http://localhost:11434/v1、将api_key设为任意非空字符串,即可无缝切换到本地模型,无需修改业务逻辑。量化(Quantization)则是将模型权重从32位或16位浮点数压缩为4位或8位整数的技术,以少量精度损失换取显存占用减半乃至更大幅度的降低,是在消费级硬件上运行大参数模型的关键手段。
环境准备与安装
开始前,确认你的机器满足以下条件:
- 操作系统:macOS 14及以上、Ubuntu 22.04/24.04,或启用WSL2的Windows 11
- 显存:35B模型至少24GB显存,或Apple Silicon上32GB统一内存
- 磁盘:保留30GB可用空间
- 软件:Node.js 22+与Ollama 0.17+
若内存不足,可退而求其次选择更小的量化模型。
安装Ollama:
# macOS
brew install ollama
brew services start ollama

# Linux
curl -fsSL https://ollama.com/install.sh | sh
systemctl enable --now ollama
确认服务并拉取模型:
ollama list
ollama pull qwen3.5:35b
下载通常耗时10到30分钟。随后用ollama run qwen3.5:35b进入交互模式验证推理,输入/bye退出。由于OpenClaw依赖兼容接口,务必检查:
curl http://localhost:11434/v1/models
返回列表中出现qwen3.5:35b,说明桥接已就绪。
启动OpenClaw并接入模型
一条命令即可完成安装与启动:
ollama launch openclaw --model qwen3.5:35b
Ollama会补装缺失组件、启动网关并打开TUI向导。你连接消息渠道、确认模型提供方、保存配置即可,网关运行在8080端口。随后在Telegram向机器人发送“列出我的下载文件夹里的文件”,OpenClaw便会调用qwen3.5返回结果。
也可手动配置:编辑~/.openclaw/openclaw.json,设置Ollama的base URL,再用openclaw start重启。两种方式结果一致。
用Apidog测试整条链路
验证本地栈是否可靠,Apidog是个趁手的工具。新建项目后,将base URL设为http://localhost:11434/v1,添加一个指向/chat/completions的POST请求,带上Content-Type与Authorization: Bearer ollama头,请求体中指定qwen3.5:35b模型、system/user消息、temperature与max_tokens。
发送后,Apidog会实时展示流式token。你可以为状态码200添加可视化断言,并把请求保存为测试场景——每次改动配置后重跑,就能第一时间发现问题。再建一个针对OpenClaw网关(http://localhost:8080/v1)的集合,即可测试端到端的消息路由,Apidog的schema校验还能确认工具调用格式符合OpenClaw的预期。
此外,Apidog的可视化设计器可导入官方OpenAI规范并针对qwen3.5参数定制,自动生成交互式文档,还能创建mock响应,在完整OpenClaw环境搭建前就模拟工具调用,加快开发与边界测试。
进阶配置与性能优化
需要更轻量的量化时,可自定义Modelfile:
FROM qwen3.5:35b
PARAMETER num_gpu 999
PARAMETER num_ctx 131072
用ollama create qwen3.5:35b-q4 -f Modelfile构建后,在OpenClaw配置中切换到新标签。通过在消息中发送base64图像即可启用视觉能力,qwen3.5能处理OpenClaw在浏览器任务中捕获的截图,从而自动化需要视觉理解的表单。技能方面,openclaw skill install @community/calendar等命令安装的技能会注册JSON schema,模型可自动学会调用。
性能上:设置OLLAMA_NUM_GPU=999启用全部GPU层,用nvidia-smi监控,Apple Silicon上开启flash attention;通过周期性摘要提示控制上下文膨胀。35B模型在4090级显卡上可达每秒45到60个token,建议据硬件选择变体。借助Apidog的性能测试跑完100次请求测延迟,再调节temperature与max_tokens逼近目标响应时间。
实际工作流与故障排查
这套栈能承载不少真实场景:发送“评审我仓库里的PR并建议重构”,智能体会克隆仓库、分析代码并生成补丁;要求“检查收件箱里的航班确认信并加入日历”,OpenClaw会解析邮件更新日历;发送PDF截图请求摘要,qwen3.5可准确提取文本并跨天保持上下文;你甚至能启动多个工作区,让35B处理通用任务、另一个专用编码模型处理代码,网关负责正确路由。
常见问题的排查思路也很直接:出现“Model not found”时运行ollama list并修正配置中的标签;延迟过高则用journalctl -u ollama查日志并增加GPU层;工具调用解析失败时将temperature锁定在0.7后重跑;OpenClaw掉线用openclaw configure --section channels刷新令牌。每次都可借助Apidog重测同一请求确认改善。
安全与长期维护
本地部署的最大优势在于数据可控,但仍需做好加固:以专用用户账户运行OpenClaw,为工具执行启用沙箱,绝不将11434或8080端口公开暴露(出行时通过SSH隧道或Tailscale访问),安装前审查每个技能来源,开启记忆加密,并定期备份~/.openclaw目录。
维护方面,阿里巴巴会持续发布更小的Qwen3.5变体,Ollama跟进迅速,用ollama pull qwen3.5:35b --force即可更新。OpenClaw技能库每周扩充,更新后保留原有测试集合、仅替换模型标签重跑Apidog测试,即可低成本维持可靠性。值得一提的是,这套OpenClaw配置与模型无关——换成DeepSeek广告同样能得到一个完全离线、无需API订阅的本地AI助手。
从环境准备到优化调试,每一个看似微小的配置选择——正确的模型标签、准确的base URL——都会在速度与可靠性上产生明显差异。当你跑通整条链路,就会真切感受到一个完全本地化智能体的能力边界。
相关推荐

一句提示词引发的全球PHP安全风暴:AI是救星还是隐患?
一句AI提示词竟引发全球PHP安全危机,维基百科、互联网档案馆受波及。本文梳理事件脉络,解析OpenAI与亚马逊的争议,探讨AI时代漏洞发现门槛降低带来的安全悖论与开发者应对策略。

当AI被拿走:依赖捷径如何削弱你的解题韧性
一项涉及1,222人的研究发现:使用AI答题后,一旦AI被移除,人们放弃解题的比例高于从未使用AI的对照组。文章分析AI依赖对学习韧性和元认知的影响,并探讨AI学习工具的设计启示。

Carta联手NewView:让创业公司员工提前套现股权
Carta 与 NewView Capital 合作推出新计划,简化创业公司 tender offer 流程,帮助员工提前出售股权套现。本文分析该合作的核心机制、员工股权流动性痛点及对创业公司股权激励的影响。