本地部署Qwen3 Next实测:128G显存跑MoE大模型的真实体验

本文评测Qwen3 MoE开源模型本地部署表现,解析其架构优势与推广内容中的夸大成分。
文章围绕一位B站UP主对Qwen3 Next MoE模型的本地部署测评展开,该模型采用混合专家架构,权重约130G但推理时仅激活部分参数,在128G显存的RTX 5000级设备上实现了241-274 token/秒的解码速度。作者认为本地部署的核心价值在于用一次性硬件投入换取长期的使用自由、数据隐私和低延迟,并演示了AI智能体自主完成3D建模任务的能力。文章同时对视频内容的可信度保持审慎态度,指出其存在模型名称口误、性能数据缺乏复现条件、"接近AGI"的说法存在营销夸张,以及明显的产品推广意图等问题,建议读者结合第三方独立评测再做判断。
被低估的开源MoE模型
开源大模型的竞赛进入到一个新的阶段,参数规模不再是唯一的衡量标准,架构效率和本地可部署性开始受到更多关注。这次体验的主角是 Qwen3 系列的 Next 版本(原视频中口述为"Qwen3.8 Flash Next",疑为模型名称的口误),采用 MoE(Mixture of Experts,专家混合)架构。
MoE 架构的核心优势在于,虽然模型总参数量不小(权重约 130G),但推理时只激活部分"专家"网络,因此在相同算力条件下能获得远超同体量稠密模型的实际表现。UP主在视频中强调,这个模型的实力"被严重低估",并非权重体积大就一定吃资源,关键要看激活参数和架构设计。
MoE(Mixture of Experts)架构的基本原理是将模型内部划分为多个"专家"子网络,每次推理时由一个轻量级的"路由器"(Router)根据输入内容动态选择其中少数几个专家参与计算,其余专家的参数在该次推理中保持静默。这与传统稠密模型(Dense Model)每次推理都激活全部参数的方式形成鲜明对比。以 Qwen3 MoE 系列为例,总参数可能达到数百亿甚至更多,但单次推理实际激活的参数量可能只有总量的十分之一左右,这使得其推理计算量接近一个小得多的稠密模型,但理论表达能力却能保留大模型的规模优势。MoE 架构的主要挑战在于:全量权重仍需加载进显存或内存,因此对存储带宽要求较高;同时多专家的负载均衡设计复杂,训练难度也高于稠密模型。Mixtral、DeepSeek广告、Qwen3 等近年来的代表性开源模型都采用了这一架构,标志着业界对"用架构效率换算力成本"这一路线的集体押注。
硬件平台与性能表现
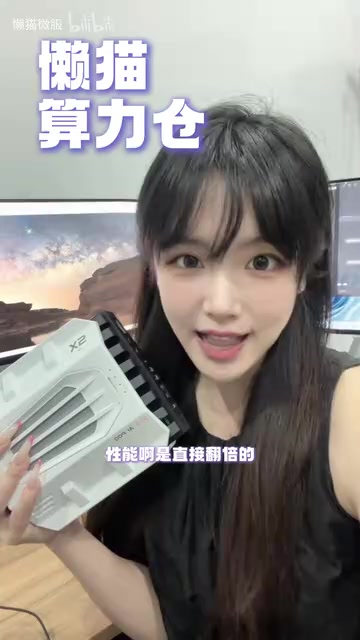
测试平台是一台搭载 128G 显存、NVIDIA RTX 5000 级别显卡的本地算力设备(视频中称为"懒猫算力舱")。把 130G 权重的 MoE 模型放在这样一台设备上运行,UP主给出的描述是"性能直接翻倍""跑起来非常丝滑、不卡顿"。
真正值得关注的是解码速度这一硬指标:
- 常规稳定速度:约 241 token/秒
- 峰值速度:约 274 token/秒
需要说明的是,原视频口述为"TB每秒",从上下文判断应为 token/秒(tokens per second),这是衡量大模型推理吞吐量的标准单位。这样的解码速度对于本地单机部署而言相当可观,意味着交互式使用几乎没有等待感。
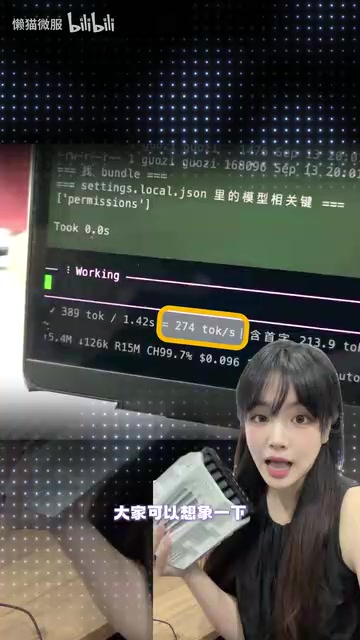
Token/秒(tokens per second,TPS)是衡量大模型推理速度的核心指标,指模型每秒能够生成的词元数量。人类正常阅读速度约为每分钟 200-400 个英文单词,换算成 token 大约对应每秒 5-10 token;因此 241 token/秒的生成速度远超人眼阅读速度,意味着模型输出几乎是"瞬时可见"的,主观体验上不存在明显等待。值得注意的是,TPS 受多重因素影响:量化精度(FP16、INT8、INT4等)越低,速度越快但精度有所损失;上下文长度越长,KV Cache 占用越大,速度通常会下降;Batch Size(并发请求数)增大时,单请求速度也会降低。因此在没有明确这些参数的情况下,241/274 token/秒的数字只能作为特定条件下的参考,不宜直接与其他评测数据横向比较。
本地AI部署的实际价值
UP主提出了一个值得思考的观点:当本地模型的推理速度能稳定做到每秒数百 token 级别时,工作中几乎所有 AI 相关任务都可以迁移到本地设备完成。这背后的逻辑是:
一旦本地推理性能跨过某个阈值,云端 API 的调用成本、数据隐私风险、网络延迟等问题都可以被规避。对于高频使用 AI 的个人或团队来说,一次性的硬件投入可以通过长期使用"实打实地回本"。
这是本地化部署一直以来的核心卖点——用前期硬件成本换取长期的使用自由和数据主权。不过是否真正划算,仍取决于个人的使用频率、任务复杂度以及对隐私的需求程度。
智能体建模任务实测
视频中最有看点的部分,是UP主用该模型驱动的智能体(Agent)来操控电脑完成自主建模任务。这个测试场景参照了 OpenAI 发布开源模型时用 3D 建模做演示的思路。
UP主对结果的评价相当高,认为开源大模型"已经可以接近 AGI 级别的智能体能力"。这个说法需要辩证看待——AGI(通用人工智能)是一个被广泛讨论且定义模糊的概念,用它来形容单个任务的完成度存在明显的夸张成分。更客观的描述应该是:当前开源模型驱动的智能体,在特定的操作电脑、调用工具完成结构化任务上,已经展现出不错的可用性。

AI 智能体(Agent)是指以大语言模型为"大脑"、能够自主规划步骤并调用外部工具(如代码执行器、文件系统、浏览器、GUI 操作接口等)来完成复杂任务的系统。与单纯的问答不同,Agent 需要模型具备任务拆解、上下文追踪、错误纠正和多步推理能力。操控电脑完成 3D 建模这类任务,通常依赖计算机视觉模块识别屏幕状态,再结合模型输出的操作指令(鼠标点击、键盘输入等)形成闭环。这类"GUI Agent"近两年已成为学术界和工业界的热点方向,代表性工作包括 OpenAI 的 Operator、Anthropic 的 Computer Use 以及多个开源框架。Agent 能力的评估难点在于任务成功率受软件版本、操作系统环境、任务定义边界等因素影响较大,单次演示成功并不等同于系统具备稳定可靠的泛化能力。
内容可信度的几点提醒
这段内容来自单一来源(B站UP主),且带有明显的产品推广性质——视频结尾引导用户"评论区扣1"领取算力舱实测数据,意图销售本地算力设备。因此在参考时需要保持审慎:
- 模型名称与单位口误较多:"Qwen3.8 Flash Next""TB每秒"等表述与业界标准术语不符,建议以官方命名为准。
- 性能数据缺乏复现条件:241/274 token/秒的测试没有说明具体的量化方式、上下文长度、batch 设置等关键参数。
- AGI 的提法过度营销:单一建模任务的成功不足以支撑"接近 AGI"的结论。
总体而言,这类内容对了解本地部署 MoE 模型的大致体验有一定参考价值,但具体性能和"回本"结论建议结合第三方独立评测再做判断。
相关推荐

n8n实战全教程:从零构建可扩展的AI自动化系统
n8n实战全教程详解:从基础概念到AI Agent、知识库、记忆系统、多Agent协作,再到事件驱动、人机协同与生产级监控,系统掌握可扩展AI自动化工作流的构建方法。

当AI一天解出372道数学难题:数学家为何愤怒而非欢呼
OpenAI 的大语言模型一天解出 372 个开放数学问题,陶哲轩等数学家却集体抵制。本文解析数学家愤怒背后的两大理由、装箱问题与整数乘法下界的争议,以及AI对数学与软件工程人才培养的深远冲击。

决策模型对决LLM:4.8倍速度、7.4倍成本的实测启示
开发者在1000条真实招聘数据上实测决策模型(Jev)与大模型(Gemini):速度快4.8倍、成本低7.4倍、准确率仅差1.6个百分点。最优解并非替换LLM,而是决策模型加置信度检查再由LLM兜底的分层架构。