本地代码索引:削减94%的AI编程Token消耗

从一张账单说起
开发者 Raj 和他的朋友 Foss 一起做项目,日常使用 Claude Code、Cursor、Copilot、Codex 等一系列 AI 编程工具。某个月账单还算正常,下个月却突然暴涨。项目没变,工具没变,唯一的区别就是用得更多了。
当他们深入排查时,发现了一个反直觉的事实:大部分费用并不是花在 AI 的"思考"上,而是花在发送了太多无用的上下文——那些模型根本不需要的文件、不相关的代码,却在每一次查询时被反复发送。
他们做了一次实测:在自己的项目上,一次典型查询发送了 45,000 tokens 的上下文,但真正有用的只有约 5,000 tokens。剩下的 40,000 tokens 毫无价值,却每次查询都要付费。用 Raj 的话说,这就像"每次点一份披萨,却要为你吃不完的另外九份付钱"。
Token 计费机制与上下文窗口的经济学:Token 是大语言模型处理文本的基本单位,理解其计费逻辑是控制成本的第一步。大致上每个英文单词约对应 1-2 个 token,中文字符则通常每字对应 1-2 个 token。主流 AI 编程工具(如 Claude、GPT-4 等)均按照输入 token 和输出 token 分别计费,且两者价格差异悬殊——以 Claude 3.5 Sonnet 为例,输入约为每百万 token 3 美元,输出则高达 15 美元。尽管单价上输出更贵,但实际使用中输入量往往远超输出量,使得输入端成为真正的费用大头。更关键的是,每次 API 调用都会将完整的上下文窗口内容计入输入费用——哪怕你的问题只有 10 个字,只要附带了一万行代码作为上下文,你就要为这一万行全额付费。
这里有一个容易被忽视的架构陷阱:上下文窗口越大,浪费越严重。GPT-4 Turbo 支持 128K tokens,Claude 3.5 支持最高 200K tokens,这种扩展带来了更强的处理能力,但也带来了一个反效果——越大的上下文窗口,越容易被 AI 工具自动填满。现代 AI 编程工具(如 Claude Code、Cursor)在发起每次查询时,会自动抓取当前打开的文件、项目配置、最近的对话历史等内容填充上下文,这一过程对用户透明,却往往导致大量冗余信息被无声地发送出去。窗口越大,自动填充的内容越多,账单也随之水涨船高。这一现象在信息检索领域被称为"上下文污染"——有效信息被大量无关内容稀释,不仅推高成本,还会降低模型的推理质量。
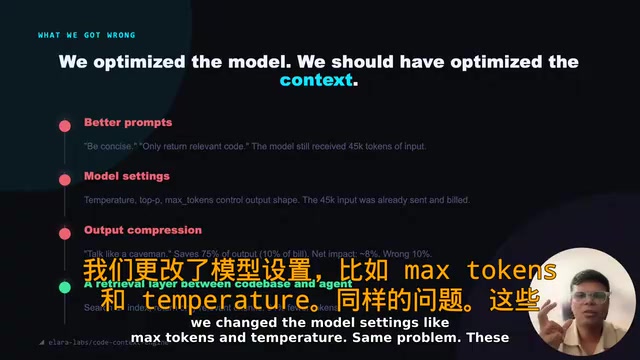
三次失败的尝试
在找到真正的解决方案前,他们试过三条路,前两条都失败了。
尝试一:优化 Prompt
他们在提示词里写"请简短,只展示相关代码"。听起来合理,但根本无效——因为模型在读到这句提示之前,那 45,000 tokens 的上下文早已发出去了。成本在读取提示词之前就已经产生。
尝试二:调整模型参数
他们尝试修改 max token、temperature 等设置。同样的问题:这些参数只影响输出,而钱花在输入上。
这里值得厘清两个参数的实际作用:
max_tokens限制的是模型单次回复的最大长度,temperature控制的是输出的随机性与创造力(0 为确定性输出,1 为高度随机)。两者都作用于模型生成阶段,对已经发出的输入 token 没有任何影响。这是很多开发者容易混淆的认知误区——以为调整这些参数能"省钱",实则只是在影响输出质量,而非成本结构。
尝试三:压缩输出
这条路确实有点效果。他们让模型写更短的回答,输出量减少了 75%。但关键在于:输出只占总成本的约 10%。把一个小数字砍掉 75%,得到的还是个小数字,远远不够。
关键结论:钱在输入端
这是整个分析中最核心的认知:
- 输入(文件、搜索结果、上下文)占总成本约 90%
- 输出(AI 写回的代码)仅占约 10%
这意味着:
- 把输出砍掉 75%,总成本只省约 8%
- 把输入砍掉 94%,总成本能省约 61%
同样的数学,结果天差地别。结论清晰:要修就修输入端,那才是 Token 费用流走的地方。
解决方案:本地代码搜索层
他们构建了一个运行在本地的搜索层,夹在代码库和 AI 之间。不再把整个文件塞给 AI,而是让 AI 去检索一个索引,只取回真正需要的那一小段代码。
RAG 技术架构在代码场景下的演进:这套本地代码搜索层,本质上是检索增强生成(Retrieval-Augmented Generation,RAG)架构在代码场景下的具体实现。RAG 由 Meta AI 研究院于 2020 年提出,核心思想是将外部知识库的检索结果动态注入到大模型的上下文中,让模型在不重新训练的情况下获取最新或专有知识。
RAG 自提出后已历经多代演进:从最初的单向量检索(Naive RAG),到引入重排序模型的高级 RAG(Advanced RAG),再到能进行多步推理的模块化 RAG(Modular RAG)。在代码库场景下,RAG 面临独特挑战:代码的语义单元(函数、类)边界明确,适合按结构切分,而非像普通文档那样按字符数滑窗截断;但代码中存在大量跨文件依赖,单纯的文本相似度无法捕捉函数间的调用关系——函数之间的调用图(Call Graph)是纯文本检索天然无法感知的隐式结构知识。这正是下文"追踪调用关系"这一步的核心价值——它将静态文本检索升级为对代码图结构的感知,使系统能够沿调用链找到语义相关却文本差异显著的代码段。
整个流程分五步:
- 切分代码:把代码拆成有意义的小单元——函数、类、方法,而不是随机切块。
- 双路搜索并行:同时跑语义搜索和关键词搜索,再合并结果。这是节省 Token 的主要来源。
- 进一步压缩:只保留函数名和描述,把 50 行的函数压到 5 行。
- 追踪调用关系:记录哪个函数调用哪个函数,找到一段代码就能顺藤摸瓜找到相关代码。
- 打分过滤:每个结果都有分数,分数过低就不发送,杜绝"坏上下文"污染查询。
全部运行在本地,不上传云端。
为什么要跑双路搜索
因为两种搜索各有短板,且这两种短板在技术原理层面就注定了各自的盲区。
语义搜索与关键词搜索的技术互补性:关键词搜索(如 BM25 算法)基于精确字符匹配,速度极快但无法理解同义词和语义变体——它只认识你写下的确切字母序列,对"authenticate"和"login"之间的语义关联一无所知。语义搜索则依赖向量嵌入(Embedding)技术——将代码或文本转化为高维向量空间中的点(通常 512 至 4096 维),语义相近的内容在向量空间中距离更近,通过余弦相似度等方式计算相关性。
代码领域常用的嵌入模型包括专为代码优化的 CodeBERT、GraphCodeBERT(后者还能感知代码数据流图),以及 OpenAI 的 text-embedding-ada-002 等通用模型。向量检索通常借助 FAISS、Chroma、Weaviate 等向量数据库实现——其中 FAISS 是 Meta 开源的轻量本地方案,支持十亿级向量的高效检索,适合本文这类追求低延迟的场景。两者结合的方式被称为混合检索(Hybrid Search),在信息检索领域已有大量研究证明其效果优于任一单一方法。RRF(Reciprocal Rank Fusion)是常见的结果融合算法,通过对两路结果的排名倒数求和实现归一化合并;本文作者采用的加权打分公式(50% 语义 + 30% 关键词 + 20% 新近度)则是一种更直接、可解释性更强的实用主义路线。
语义搜索擅长找"意思相关"的代码,却会漏掉精确名称——你搜 authenticate user function,它可能给你另一个含义相近的 auth 函数。关键词搜索擅长精确名称,却会漏掉相关概念——你搜 login flow,它会漏掉所有写成 sign in 的代码。
单独用任一种,大约每 4 个结果就漏 1 个;两者结合,漏检率降到约十分之一。它们互补短板,共同提升上下文质量。

最难的部分:判断相关性
真正的难点不是找到结果,而是判断结果是否真的相关。有时搜索返回 10 个结果,却没一个对——如果拿这些坏结果去问 AI,它会给出"自信的错误答案",这比没有答案更糟。
他们试过让 AI 自己评判结果,太慢,每次多花 2-3 秒;试过固定分数阈值,又太死板,短问题即使完美匹配也会被误判低分。
最终采用了一个简单公式:50% 语义得分 + 30% 关键词得分 + 20% 代码新近度,阈值根据当前结果动态调整。整个过程仅需 0.4 毫秒,无需额外的 AI 调用。核心教训:简单公式在大多数场景下胜过复杂模型。
这一结论在机器学习领域有其理论支撑,对应著名的"奥卡姆剃刀原则"(Occam's Razor)在统计学中的延伸——模型复杂度与泛化能力之间存在权衡(Bias-Variance Tradeoff)。在数据量有限、场景相对固定的本地代码检索任务中,轻量线性公式往往比深度神经网络具有更好的稳定性,且更容易调试和解释,维护成本也更低。
真实数据:每次查询削减 94% Token
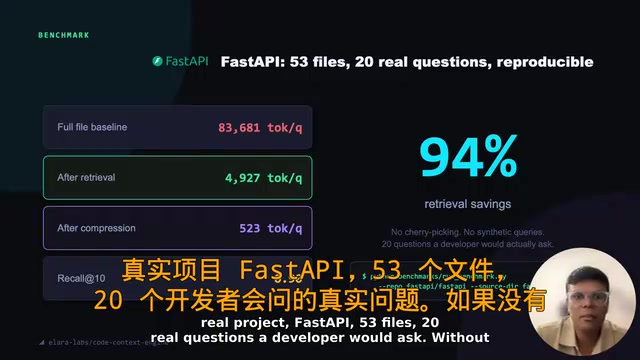
他们在开源真实项目(FastAPI,53 个文件)上,用 20 个开发者会真实提出的问题做了基准测试:
- 不使用工具:每问 83,000 tokens
- 使用本地索引工具:每问 4,900 tokens(减少 94%)
- 叠加压缩后:聚焦到 523 tokens
- 准确率:仍能在 90% 的情况下找到正确代码
测试方法完全公开,任何人都能自行复现验证。
诚实面对局限
Raj 对 94% 这个数字保持了难得的克制。这个数字建立在"最坏情况"——每次读取全部文件——的基础上。现实中像 Claude Code 这样的工具本身已经比这更聪明,因此真实节省会低于 94%。
更重要的局限:大型混合代码库很难处理。 在一个 396 个文件的大型项目上测试时,召回率几乎跌到零。
召回率与代码架构的单一职责原则:信息检索中,召回率(Recall)衡量"所有真正相关的结果中,系统找到了多少";准确率(Precision)衡量"系统返回的结果中,有多少是真正相关的"。两者往往此消彼长——放宽检索门槛可以提高召回但会引入噪声,提高门槛则召回下降,这一权衡被称为 Precision-Recall Tradeoff,是信息检索领域的经典难题。
在代码检索场景中,大型混合职责文件(一个文件包含多种不相关功能)会严重干扰向量嵌入的质量,因为文件的整体向量无法准确代表其中任何一个具体功能,导致所有查询都命中"语义上模糊"的这个文件,却找不到真正需要的那段逻辑。这也解释了为何"每个文件只做一件事"的代码库效果更好——这恰好对应软件工程中的单一职责原则(Single Responsibility Principle,SRP),由罗伯特·马丁(Robert C. Martin)在 SOLID 原则体系中系统化提出。该原则在 AI 时代获得了全新的实用价值:良好的代码架构不仅对人类开发者友好,也直接提升了 AI 检索工具的准确率,产生了可量化的经济效益——代码质量与 AI 使用成本之间,出现了一条此前从未被明确量化的因果链。
规律是:如果每个文件只做一件事,效果很好;如果文件职责混杂,就会失灵。此外他们为了速度选用了小而快的检索模型,重建索引不到一秒——大模型能找到更多,但他们选择了速度而非完美。
这套方案的设计哲学始终如一:简单选择往往胜过复杂方案——用小数据库而非大型基础设施,用两个搜索而非一个花哨算法,用本地而非云端。
共享索引与记忆:跨工具复用上下文
多数开发者会同时使用多个工具(Claude Code 处理难题、Cursor 快速编辑、Copilot 做小补全),但这些工具每次都从零开始,彼此不共享任何东西——你要把同一套代码库向三个不同的 AI 重复解释三遍。
这个问题在技术层面有其根本原因:每个 AI 工具都维护着自己独立的会话状态和上下文缓存,工具之间既无通信协议,也无共享存储机制。随着工具数量增加,这种重复解释的浪费呈线性放大。
MCP 协议与跨工具上下文共享的行业标准化趋势:这一痛点正在推动行业层面的标准化努力。Anthropic 于 2024 年推出的 Model Context Protocol(MCP) 试图建立统一的上下文交换标准,允许不同 AI 应用通过标准接口共享工具调用、资源访问和对话历史。MCP 采用客户端-服务器架构,AI 助手作为客户端,外部工具和数据源作为服务器,双方通过标准化 JSON-RPC 消息格式通信,支持资源(Resources)、工具(Tools)和提示(Prompts)三类原语的统一描述。与 USB 统一了硬件接口的逻辑类似,MCP 的目标是终结"每个 AI 工具都要单独适配每个数据源"的碎片化现状。
本文描述的共享索引方案与 MCP 的设计哲学高度一致——都是将上下文的构建和管理从各个 AI 工具中解耦出来,形成一个独立的共享层。只是本文选择了在行业标准尚未普及之前,以工程实现先行落地这一理念。随着 MCP 生态的成熟,这类本地共享索引有望通过标准协议直接暴露给所有兼容工具,届时"一次索引、多工具复用"将成为开箱即用的能力,而非需要自行搭建的基础设施。
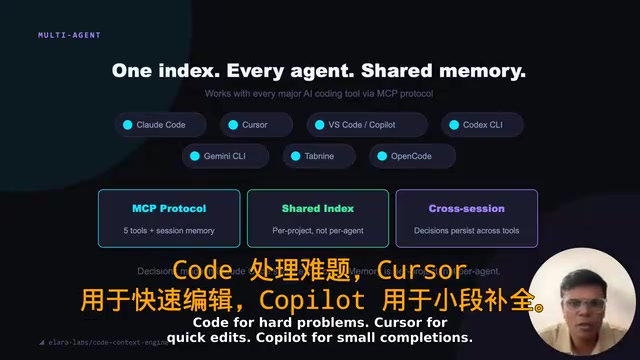
他们的方案是构建一个共享索引,所有工具连接同一个索引、共享同一套搜索结果。并加入了记忆机制:当一个工具学到了关于项目的知识,这份知识会保留到下一次会话,换个工具也能直接复用上下文,彻底消除重复解释的浪费。
在一个真实项目上的成绩单:247 次查询,节省了 1240 万 tokens,约合 186 美元未被花掉。其中 84% 的节省来自搜索层,其余来自压缩。工具会追踪每次查询,对比"本该发送的"和"实际发送的",再乘以模型价格得出真实节省数字。
结语:优化输入,比选模型更重要
Raj 的核心观点直击当下 AI 编程的痛点:我们总在争论用 Opus 还是 Sonnet 哪个模型最好,但模型选择可能只占成本的 30%,另外 70% 取决于你喂给它什么。
这个判断有其数学依据:在同等上下文质量下,不同模型之间的价格差距通常在 3-5 倍以内;而上下文从 83,000 tokens 压缩到 4,900 tokens,相当于近 17 倍的费用削减。两相比较,上下文优化的杠杆远大于模型选择。
答案不是更强的模型,而是发送更少、更精准的上下文。这个名为 CCE 的工具已经开源免费,值得每个被 AI 账单困扰的开发者跑一周,看看自己真实的数字。
核心要点
- 钱在输入端:输入上下文约占总 Token 成本的 90%,优化输出只是在小数上做文章。
- RAG 是解法本质:本地代码搜索层的核心是检索增强生成架构,将"发送全部"变为"按需检索"。
- 混合检索优于单一方法:语义搜索与关键词搜索各有盲区,两者结合可将漏检率从 25% 降至约 10%。
- 代码架构影响 AI 成本:单一职责原则不只是工程规范,也直接决定 AI 检索的准确率和经济效益。
- 简单公式胜过复杂模型:0.4 毫秒的加权打分远优于 2-3 秒的 AI 自评,在约束场景下奥卡姆剃刀有效。
- 共享上下文层是趋势:MCP 等行业协议正在标准化这一能力,提前以工程方式落地是务实选择。
相关推荐

Meta重返开源:30B模型Muse Glimmer单张24G显卡可跑
Meta重返开源,推出30B参数的开放权重模型Muse Glimmer,单张24GB显卡即可运行,采用Apache 2.0许可证,支持多模态与推测解码加速。海外博主实测其编程、建模与前端设计能力,带你了解这款亲民本地大模型的真实表现。

AI+SRC自动化挖洞实战:用AI智能体重构漏洞挖掘三步法
本文详解AI+SRC自动化漏洞挖掘的完整思路,对比传统挖洞三步法与AI智能体加持后的变化,涵盖资产盘点、误报筛选、报告生成及AI Agent选型要点,助你高效入门SRC漏洞挖掘。

实测DeepSeek桌面Agent:0.35美元自动生成视频
海外博主实测DeepSeek桌面Agent(DeepSeek Harness):仅0.35美元自动生成完整视频,设置每日自动简报,两分钟从大白话构建可运行App。三项任务全部完成仅花0.59美元,附详细表现与成本分析。