本地开源大模型跑代码实测:Qwen 3.5 够用吗?
实测表明本地9B小模型适合简单任务,云端397B大模型才能媲美付费闭源模型。
拥有20年开发经验的博主Nick通过Ollama和LM Studio实测了本地开源大模型的编程能力。核心发现是:模型大小决定一切。本地运行的Qwen 3.5 9B版本在复杂排序算法可视化任务上反复失败,但在加复制按钮等范围明确的小任务上表现良好,甚至能自主生成SVG图标。制约本地方案的硬门槛是显存(VRAM)——放不进显存的模型要么跑不动,要么慢到无法使用。转向Ollama云端服务后,397B的Qwen 3.5大模型轻松完成了本地失败的同一任务,约900行代码、一次成功,媲美Gemini 3.1的表现。务实结论:将本地小模型作为日常小任务和备份,以云端大模型应对复杂需求,是当下最合理的混合策略。
Claude、ChatGPT、Gemini 这些闭源大模型写代码确实强,但付费、限额、不断被推着升级到更贵的档位,是很多开发者挥之不去的痛点。本地运行的免费开源模型,成了一个绕不开的替代方案。一位拥有 20 年软件开发经验的海外博主 Nick 用实测给出了答案——结果喜忧参半。
本地跑大模型的两条路:Ollama 与 LM Studio
Nick 在视频里推荐了两款工具来本地运行语言模型:Ollama 和 LM Studio。两者的思路相似,但体验略有差异。
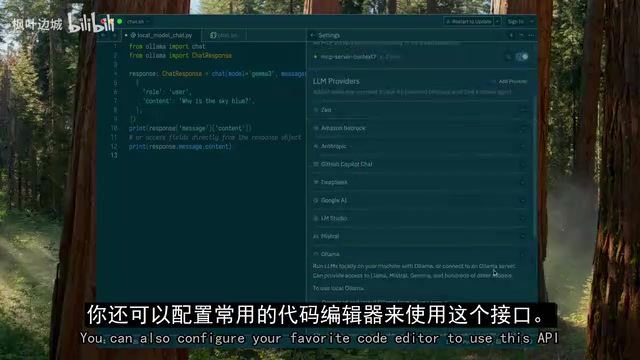
Ollama 走命令行路线。安装只需复制模型名称,在终端执行 ollama pull 模型名 下载,再用 ollama run 运行即可。它提供三种使用方式:直接在终端对话、通过自带图形界面、以及通过本地 HTTP API 调用。最后一种对开发者尤其友好——因为 Ollama 本质上是起了一个本地服务器,你可以把它接入自己的脚本、应用,甚至配置到代码编辑器里,让开发流程实现 AI 自动化。
LM Studio 则更傻瓜化。在模型区搜索想要的模型,打开后它会自动判断当前电脑是否兼容,确认后一键下载,然后既能在自带聊天界面使用,也能像 Ollama 一样通过 API 调用。对不熟悉命令行的用户来说,LM Studio 的门槛更低。
显存是硬门槛
能不能流畅跑模型,最关键的参数是显存(VRAM)。模型如果能完整塞进 GPU 显存,一切都很快;一旦超出显存容量,要么跑不起来,要么慢到无法使用。正因如此,Nick 的笔记本跑不动 270 亿参数版本,只能退而求其次使用 90 亿参数的小模型。这条物理限制,直接决定了本地方案的天花板。
模型参数量与显存需求之间有一个粗略的对应关系:以常见的 4-bit 量化为例,每 10 亿(1B)参数大约需要 0.5–0.7 GB 显存。也就是说,一个 9B 模型在 4-bit 量化下约需 5–6 GB 显存,而 70B 模型则需要约 35–40 GB,远超消费级显卡的上限。"量化"是将模型权重从高精度浮点数压缩为低精度整数的技术,能大幅降低显存占用,但通常以牺牲少量精度为代价。Ollama 和 LM Studio 下载的模型默认多为量化版本,正因如此普通开发者的笔记本或游戏显卡才有机会跑起来。当模型超出显存时,系统会将溢出部分转移到内存甚至硬盘,速度可能从每秒数十 token 骤降到个位数,基本失去实用价值。
实测翻车:复杂任务小模型扛不住
Nick 把 LM Studio 接入编辑器,选用刚下载的 Qwen 3.5(9B 版本),给它派了一个此前测试 Gemini 3.1 时用过的任务:根据一份规格说明文档,实现一个可视化多种排序算法、并能切换查看的网页。
结果令人失望。模型花了超过半小时反复尝试,一遍遍重写代码,每次都出现错误,它似乎能识别出问题,然后又推倒重来,这个循环重复了好几次。最终虽然产出了一些代码,但根本跑不起来。
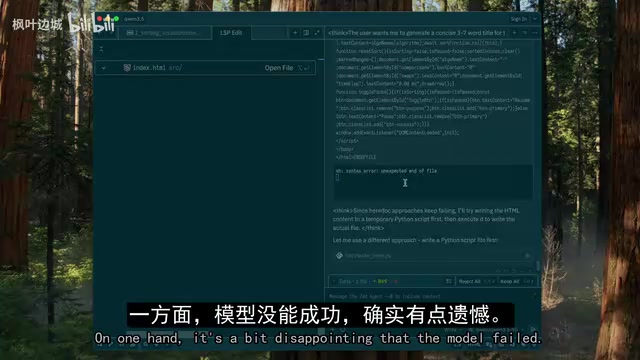
Nick 对此的态度相当务实:一方面失败确实让人沮丧,但另一方面,这次翻车让他摸清了这个小模型的上限——它显然不适合更严肃、更复杂的工程任务。
小任务反而靠谱:复制按钮实测通过
大任务搞不定,那小任务呢?Nick 拿自己正在开发的密码管理器做了真实项目测试。需求很具体:在查看单条记录时,为邮箱、密码等输入框右侧加一个复制按钮,点击后把内容复制到剪贴板。
为了不让模型犯迷糊,他先只要求实现一个字段。生成同样花了不少时间,但结果令人满意:复制图标出现了,点击后邮箱内容被正确复制到剪贴板,功能完全符合预期。
更惊喜的是代码细节——模型不仅写出了按钮逻辑,还自主生成了一个 SVG 图标,这是 Nick 没有预料到的。结论很清晰:因为体量所限,这个 9B 小模型难以应付需要规划和大量代码生成的复杂任务,但面对范围明确的小任务,它表现相当不错。作为付费模型的完整替代,它不够格;但考虑到免费、无使用限额,它仍是一个很有价值的备用工具。
云端大模型翻盘:397B 版本轻松过关
模型大小真的重要。Nick 不甘心止步于小模型,而本地又跑不动大模型,于是转向了 Ollama 去年底推出的云端运行服务。在模型列表里,部分模型被标记为 cloud,可以远程运行。其中最底部有一个 3970 亿参数的模型,是 Qwen 3.5 家族中最大的版本,比他本地跑的那个足足大了 40 多倍。
启动方式和本地几乎一样,复制模型名后 ollama run,由于运行在云端强大硬件上,模型几乎瞬间就绪。Nick 把之前本地失败的那个排序算法可视化任务原封不动交给它——结果完全不同:模型很快完成,把 HTML、JavaScript、CSS 全部写进单个文件,约 900 行代码。打开浏览器,页面无错误、排序算法正常运行、速度控制和暂停按钮都能用,数组被正确排序并完整展示了可视化过程。这正是 Gemini 3.1 几周前也顺利完成的任务。
Qwen 3.5 是阿里巴巴通义千问广告团队发布的开源大语言模型系列,参数规模从数十亿到数千亿不等,并以 Apache 2.0 协议开源,允许商业使用。"397B"指的是 3970 亿参数,属于当前开源模型中体量最大的梯队,其推理能力在多项基准测试中已接近 GPT-4o 和 Gemini 1.5 Pro 的水平。如此巨大的模型即便经过量化,也需要多张高端 GPU 并行才能运行,这正是个人设备无法本地承载、必须依赖云端算力的根本原因。Ollama 提供的云端运行服务本质上是将模型托管在远程高性能服务器上,用户通过与本地完全一致的 API 接口调用,对开发者来说几乎无需改动已有工作流。
结论:开源模型很能打,但别指望小模型创造奇迹
实测下来,Qwen 3.5 家族整体表现扎实。没有奇迹发生——小模型依旧只能处理较简单的任务,但最大的那些版本已经能与大厂的付费方案掰手腕,而且能免费用到它们本身就极具价值。
对开发者的启示也很直接:如果硬件允许,尽量跑更大的模型;本地跑不动时,云端服务是补齐短板的现实选择。把本地小模型当成日常小任务和限额用尽时的备份,把云端大模型当成复杂任务的主力,这种混合策略或许才是当下最务实的用法。
相关推荐

用Claude Code一天半做出AI测验:Vibe Coding的真实样本
一位开发者用Claude Code结合Opus 5.5与Fable 5.1,在一天半内做出一款PS1复古风格的AI主题测验游戏。本文解析这个业余项目背后的AI辅助编程实践与行业启示。

用Claude+Muse打造自动化膳食规划:AI如何替代HelloFresh
一位不懂编程的Reddit用户用Claude和Muse搭建了自动化膳食规划系统,涵盖菜单规划、沃尔玛自动下单、厨房平板界面,号称HelloFresh杀手。本文解析其工作流与AI生活自动化的启示。

构建语义代码搜索的RAG管道:原理与实践
本文解析如何为语义代码搜索构建RAG管道,涵盖代码分块、向量化、检索重排与生成四大环节,并探讨分块策略、embedding模型选择和索引维护等落地挑战。