本地跑AI编程模型全攻略:Ollama+VS Code+Cline实战
用Ollama+VS Code+Cline三件套,在家用显卡上免费搭建媲美顶级闭源模型的本地AI编程环境。
本文介绍了一套以Ollama、VS Code和Cline插件为核心的本地AI编程环境搭建方案,无需付费、无Token限制、数据完全私密。模型选择依显存而定:8–12GB显存推荐Ornith 1.5,24–36GB推荐Qwen3 Coder(约30B参数)。作者援引SWE-bench Pro基准数据,称Qwen3 Coder得分61.7,超过付费闭源模型Opus 4.6 MAX的53.4分,并通过3D地球、Flappy Bird等一次性生成案例验证实战能力。进阶功能包括MCP工具调用和无审查模型支持。文章指出,这一组合的核心价值不在于跑分冠军,而在于消费级硬件已能承载接近前沿水平的编程能力,对注重隐私与成本的开发者极具参考意义。
想在自己的电脑上跑一个不花一分钱、不受任何限制、还能保证隐私的AI编程模型?这不再是天方夜谭。一位B站UP主通过 Ollama + VS Code + Cline 的组合,在家用游戏电脑上搭建了一套完整的本地AI编程环境,并声称其核心模型在智能体编程基准上已经超越了顶级闭源模型。本文梳理其完整搭建流程,并剖析本地模型崛起背后的意义。
三件套:Ollama、VS Code 与 Cline
整套方案的基础是三个免费工具的组合,流程比想象中简单。
第一步是安装 Ollama,它是本地运行大模型的核心引擎,负责模型的下载、管理与推理。到官网下载安装即可,几乎是一键完成。
第二步是安装 VS Code(Visual Studio Code),这是目前最流行的代码编辑器,相当于你写代码和运行模型的主界面。它与 Cursor 类似,但作为元老级编辑器,配合插件生态非常成熟。
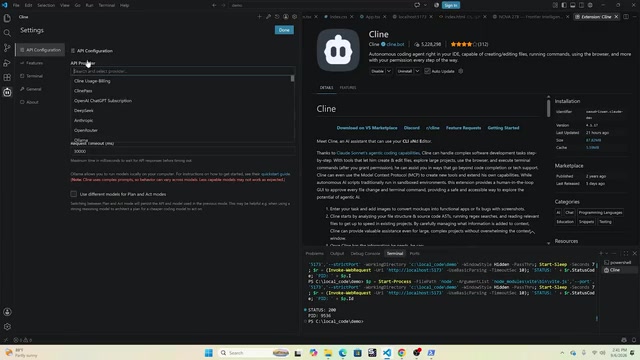
第三步是在 VS Code 的扩展市场里搜索并安装 Cline 插件。Cline 是一个 AI 编程智能体插件,安装后进入其设置,把 API 提供商(API Provider)设置为 Ollama,它就能自动识别你在 Ollama 中下载好的所有模型。
配置过程中有个关键参数是上下文窗口大小。UP主使用的是 RTX 5090 显卡,设置为 64K;如果显存有限,可以降到 32K。需要注意的是,Ollama 和 Cline 两端的上下文数值要保持一致,否则容易出问题。
Cline 的定位值得单独说明。它不是简单的代码补全插件(如 GitHub Copilot),而是一个具备「智能体」能力的编程助手:它可以自主读写文件、在终端执行命令、调用浏览器预览结果,并在多步骤任务中持续规划与纠错。这类工具通常被称为 Agentic Coding Assistant,与 Cursor 的 Composer 模式、Windsurf 的 Cascade 模式属于同一赛道。Cline 的优势在于完全开源(MIT 协议)、支持任意 API 后端,因此可以无缝接入本地 Ollama 模型,而不像某些商业产品只能调用指定云端服务。上下文窗口(Context Window)则决定了模型每次能「看到」多少代码和对话历史:64K 约等于五万个汉字或数千行代码,窗口越大,模型处理复杂项目时丢失上下文的概率越低,但对显存的消耗也越高。
按显存选模型:从 8GB 到 36GB
模型选择是整套方案中最需要权衡的环节,核心依据是你的显卡显存容量。UP主推荐借助 Can I Run It 这类工具,根据硬件配置查询最适合运行的开源模型。
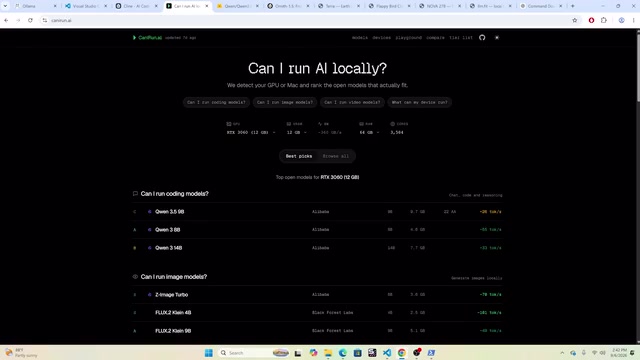
8GB–12GB 显存:推荐使用一个名为 Ornith 1.5(约1.59B参数)的小模型。别看它体积小,在编程基准测试上拿到了约47分,而同级别的 QW 3.5(约0.59B)只有21.3分,差距明显。对于低显存的笔记本或入门显卡,这是性价比较高的选择。
24GB–36GB 显存:UP主强烈推荐 Qwen3 Coder 8B(约30B级别,文中称 QW3.8 27B),这也是教程主力演示的模型。模型下载命令非常直接,在终端(Windows用PowerShell,Mac用CMD)运行 ollama pull 加模型名即可。整个模型约17–20GB,下载完成后会自动出现在 Ollama 的模型列表中。

本地模型真能超越 Opus 4.6 MAX?
这是全片最具争议也最吸睛的论点。UP主引用了模型在 Hugging Face 页面上的基准数据:在 SWE-bench Pro(业界公认衡量智能体编程能力的首选基准)上,Qwen3 Coder 模型得分 61.7,而 Opus 4.6 MAX 为 53.4。
换句话说,大约半年前还需要付费、还频繁触发 Token 限制的顶级闭源模型,如今可以在本地免费运行,且在该基准上反超。UP主坦言曾因 Opus 的 Token 限制而极度沮丧,而本地运行彻底摆脱了这一痛点。
需要理性看待的是,这里的「超越」仅限于单一基准分数,且本地模型通常会比前沿模型落后数月。但UP主的观点值得玩味:大多数日常编程任务其实并不需要最前沿的模型,当成本为零时,几分的差距几乎可以忽略。
SWE-bench 是由普林斯顿大学团队提出的智能体编程基准,测试方法是将真实 GitHub 仓库中的 Bug 修复任务交给模型,要求模型自主定位问题、修改代码、通过单元测试,全程无人工干预。这使它比「写一段排序算法」之类的玩具题更能反映真实开发能力。SWE-bench Pro 是其难度更高的升级版,题目来源更广、测试集防泄露机制更严格,业界普遍认为它比原版更难刷榜。值得注意的是,不同机构提交 SWE-bench 结果时所用的「脚手架」(即调用模型的外层 Agent 框架)差异很大,得分受框架设计影响显著,因此同一基准上不同来源的分数未必完全可比,这也是「理性看待」建议的技术背景。
实战演示:从 3D 地球到 Flappy Bird
为了验证能力,UP主展示了几个一次性生成(one-shot)的案例。
一个是可交互的 3D 地球:可以切换昼夜、添加光晕、显示极光、城市灯光、云层大气,还能调节旋转速度。据称整个项目大约三分钟就构建完成,而类似效果在 GPT-5 刚发布时都难以做到。
另一个是经典的 Flappy Bird 克隆,同样约三分钟生成且运行流畅。UP主对比称,三个月前测试付费版 Grok 都没能做出这么好的效果。

这里有个容易踩坑的细节:在 VS Code 中打开新文件夹时,系统会进入「受限模式」用于安全浏览,必须点击信任此文件夹,否则 Cline 面板可能不显示。
进阶玩法:MCP 与无审查模型
Cline 还支持配置 MCP(Model Context Protocol),可以接入免费或付费的 MCP 服务,让开源模型调用外部工具。UP主演示了用 MCP 配合模型生成一个使用 shadcn/ui 的单页落地页(为虚构 AI 模型 Nova 27B 做产品页),全程本地运行、零 Token 消耗,成品设计相当扎实。
另一个卖点是无审查(uncensored)版本。UP主使用了来自 OpenRouter 社区的 Qwen3 Coder 无审查版,同样通过 Ollama 拉取运行。这类模型基本做到零拒绝,加上完全本地运行、数据不外传,兼顾了私密性与无限制使用。
MCP(Model Context Protocol) 是由 Anthropic 于 2024 年末提出并推动开放的标准协议,目标是让 AI 模型以统一方式调用外部工具和数据源,类似于给模型装上「插头」,插上不同的「插座」(MCP Server)就能访问文件系统、数据库、网页搜索、代码执行环境等能力。由于协议开放,社区已涌现出大量免费 MCP Server,Cline 对此有原生支持。无审查(Uncensored)模型通常是在原始基础模型上跳过或弱化 RLHF(基于人类反馈的强化学习)安全对齐步骤后微调得到的版本,能响应标准模型会拒绝的敏感或灰色地带请求。本地运行此类模型在技术上完全可行,但使用者需自行承担内容责任;其「数据不外传」的特性,使得隐私层面的顾虑相对较小。
本地编程的拐点已至
这套方案的真正价值,不在于单个模型跑分多高,而在于它揭示了一个趋势:消费级硬件已经能承载接近前沿水平的编程能力。免费、私密、无 Token 限制、数据不上传给大公司——这些特性组合起来,对注重隐私和成本的开发者极具吸引力。
当然,本文结论大多来自单一来源的演示,跑分对比和「超越 Opus」的说法仍需谨慎看待,实际体验会因硬件和任务类型而异。但对于手头有 24GB 显存左右显卡的开发者来说,花十几分钟搭一套本地环境试试,确实是笔稳赚不赔的买卖。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。