本地跑AI每小时0.12欧,调用前沿模型API反而更划算?
本地AI推理成本远不止电费,吞吐量、折旧与模型质量共同决定真实性价比。
一位用户疑惑本地运行大模型每小时仅需0.12欧元电费,是否比付费调用前沿API更划算。文章指出,这一比较存在根本性的计量单位错配:本地成本以时间计费,云端API以token计费,必须将两者换算到同一基准(每百万token成本)才能公平对比。更重要的是,电费只是冰山一角,完整的总拥有成本还应涵盖硬件折旧(仅RX 7900 XTX的折旧每小时就可能超过电费本身)、推理速度带来的时间成本,以及本地小模型与前沿大模型之间不可忽视的质量差距。文章最终给出结论:高频满载用户本地推理有成本优势,而间歇性使用或对任务质量要求较高的用户,按量付费的云端API通常更为经济。
一个被反复讨论的本地推理成本问题
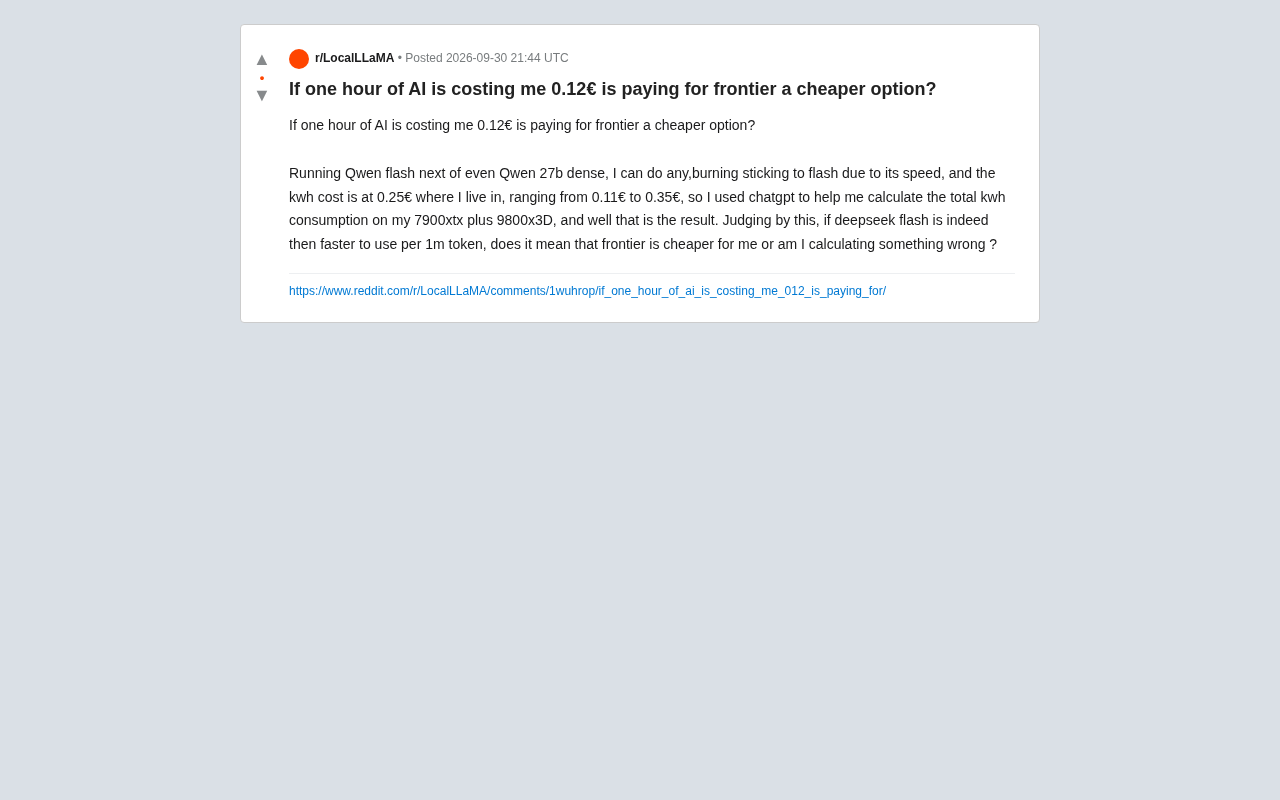
一位 Reddit 用户抛出了一个颇具代表性的疑问:如果在本地运行大模型,每小时的电费成本约为 0.12 欧元,那么直接付费调用前沿模型(frontier models)的 API,是不是反而更便宜?
这位用户的硬件配置是 Radeon RX 7900 XTX 显卡搭配 Ryzen 9 7800X3D(原文写作 9800X3D)处理器,运行的模型包括 Qwen Flash 和 Qwen 27B dense。由于 Flash 版本速度更快,他主要坚持使用它。当地电价约为 0.25 欧元/千瓦时,波动区间在 0.11 到 0.35 欧元之间。他借助 ChatGPT 估算了整机功耗,得出每小时约 0.12 欧元的运行成本。
核心困惑在于:如果像 DeepSeek广告 Flash 这类模型在云端按百万 token 计费时速度更快、单价更低,那是不是意味着对他个人而言,直接用前沿模型 API 比自建本地推理更经济?
为什么「每小时成本」和「每 token 成本」不能直接对比
这个问题的关键,在于两种计费维度的错配。本地运行的成本是以时间(每小时电费)来衡量的,而云端 API 的成本是以吞吐量(每百万 token)来衡量的。要做公平对比,必须把两者换算到同一基准上。
本地每小时 0.12 欧元看起来极低,但真正决定性价比的是这一小时里你究竟生成了多少 token。如果一张消费级显卡在一小时内只能生成几十万 token,那么折算到每百万 token 的成本可能并不像表面那么诱人。反之,如果模型小、吞吐高,本地的边际成本会被摊得非常薄。
换算公式其实很直接:
本地每百万token成本 = (每小时电费) / (每小时生成的token数 / 1,000,000)
只有算出这个数字,才能和云端 API 的报价(通常以美元/百万 token 计)放在一起比较。原帖用户只计算了电费,却没有把吞吐量纳入分母,这正是「是不是算错了」的症结所在。
理解吞吐量对成本换算的影响,需要对消费级 GPU 的实际推理速度有基本预期。以 RX 7900 XTX(24 GB VRAM)为例,在运行量化后的 Qwen 27B dense 模型时,生成速度通常在 20–40 tokens/秒区间;若切换到参数量更小的 Flash 系列(约 7B 量级),速度可提升至 60–100 tokens/秒。以 70 tokens/秒估算,一小时可生成约 2.52 亿 token,折算后每百万 token 的电费成本约为 0.48 欧元。而 DeepSeek 等主流云端服务的 Flash/轻量级模型报价通常在 0.1–0.5 美元/百万 token 区间,两者已相当接近。这说明在吞吐量较高且模型较小的情形下,本地电费成本并不一定比云端贵,但一旦加入折旧等隐性成本,优势便会收窄甚至反转。
被忽略的隐性成本
仅用电费来代表本地推理的总成本,是一种明显的低估。完整的拥有成本(TCO)至少还应包含以下几项:
硬件折旧
一张 RX 7900 XTX 的购置成本不低,按使用寿命摊销到每小时后,往往会超过电费本身。如果一台机器主要就是为跑 AI 而买,这部分不应被忽略。
时间与速度
原帖用户已经注意到 Flash「因为速度快」而被优先使用。速度本身就是成本——更慢的本地推理意味着更长的等待,而前沿模型的 API 通常在延迟和吞吐上更有优势。对需要快速迭代的工作流来说,时间成本可能远超那 0.12 欧元。
质量差异
这是最容易被电费账单掩盖的一点。本地可运行的 Qwen Flash 或 27B dense 模型,与真正的前沿模型(如顶级闭源大模型)在推理能力、复杂任务表现上存在差距。如果任务对质量敏感,便宜的本地模型可能需要更多轮次才能得到满意结果,反而推高了实际成本。
总拥有成本(TCO,Total Cost of Ownership) 是评估技术方案经济性时的标准框架,指在产品或系统整个生命周期内所发生的全部直接与间接费用之和。对于本地 AI 推理场景,TCO 除电费外,还涵盖硬件购置与折旧、散热与电源损耗、维护与故障排查的时间投入、操作系统与驱动的版本管理成本,以及机器占用的物理空间与噪音代价。以 RX 7900 XTX 为例,该卡售价约 900–1000 欧元,若按 3 年使用寿命和每天 4 小时运行计算,仅折旧一项每小时就约为 0.23 欧元,已高于原帖中 0.12 欧元的电费。这意味着即便电费看起来微不足道,完整的每小时持有成本实际上可能是电费的两倍以上,直接改变本地方案与云端 API 的比价结论。
前沿模型(Frontier Models) 特指在发布时代表当前技术水平最高点的大型语言模型,通常参数量在数千亿级别,并经过大规模强化学习与人类反馈对齐(RLHF)训练。典型代表包括 GPT-4o、Claude 3.5 Sonnet、Gemini 1.5 Pro 等闭源模型。与之相对,可在消费级硬件上本地运行的模型(如 Qwen 7B Flash 或 27B dense)属于边缘推理模型,在多步推理、代码生成、长文档理解等复杂任务上与前沿模型存在明显能力差距。这一差距在评估「性价比」时不可忽视:若某项任务使用本地模型需要 5 轮对话才能完成,而前沿 API 一次即可,则前者的实际 token 消耗与时间成本可能远高于后者,即便单 token 价格看起来更低。
什么时候本地划算,什么时候 API 划算
综合来看,答案并不是非此即彼,而是取决于使用模式:
- 高频、长时间、持续负载:如果显卡几乎全天候满载运行,本地的边际电费优势会显现,尤其在电价较低的时段。
- 低频、间歇性使用:机器大部分时间闲置却仍在折旧,这种情况下按量付费的 API 几乎总是更划算。
- 对质量要求高的任务:前沿模型 API 的能力溢价往往值回票价,本地小模型难以替代。
- 隐私、离线、无限调用需求:这类场景下本地部署的价值不在于省钱,而在于控制权和数据安全。
对原帖用户的具体情形,建议是先实测本地模型在一小时内的真实 token 产出,算出每百万 token 的本地成本,再把显卡折旧和自己的时间成本加进去,然后与 DeepSeek 等云端服务的报价逐项对照。只有这样,「frontier 是否更便宜」才有一个诚实的答案。
结语
这个看似简单的提问,实际上触及了本地部署 AI 时最常见的认知误区:把电费等同于总成本,又用不同的计量单位去比较两种方案。电费只是冰山一角,吞吐量、硬件折旧、速度和模型质量共同决定了真实性价比。对大多数间歇性、重质量的个人用户而言,前沿模型的 API 往往确实是更经济的选择;而对负载饱和、追求数据自主的重度用户,本地推理才有机会跑赢账单。
相关推荐

用Claude Code一天半做出AI测验:Vibe Coding的真实样本
一位开发者用Claude Code结合Opus 5.5与Fable 5.1,在一天半内做出一款PS1复古风格的AI主题测验游戏。本文解析这个业余项目背后的AI辅助编程实践与行业启示。

用Claude+Muse打造自动化膳食规划:AI如何替代HelloFresh
一位不懂编程的Reddit用户用Claude和Muse搭建了自动化膳食规划系统,涵盖菜单规划、沃尔玛自动下单、厨房平板界面,号称HelloFresh杀手。本文解析其工作流与AI生活自动化的启示。

构建语义代码搜索的RAG管道:原理与实践
本文解析如何为语义代码搜索构建RAG管道,涵盖代码分块、向量化、检索重排与生成四大环节,并探讨分块策略、embedding模型选择和索引维护等落地挑战。