本地跑AI模型该买什么硬件?显存与带宽决定一切
用内存容量与带宽两个核心参数,量化判断本地AI硬件选购中Mac与PC各自的真实优劣。
本文为「本地跑大语言模型该选Mac还是PC」这一常见争论提供了可量化的判断框架。核心逻辑归结为两个参数:内存容量决定能否装下模型,内存带宽决定跑多快,并给出「带宽÷模型体积」的速度预估公式。文章通过多款硬件的实测跑分,揭示出PC高端显卡(如RTX 4090)在token速度与提示处理上占优,但受限于24GB显存无法运行超大模型;而Mac/DGX Spark等统一内存设备容量更大、更适合运行新一代混合专家架构(MoE)大模型。两大趋势——MoE模型普及与内存价格飞涨——正进一步向大统一内存设备倾斜。选购建议是反向工程:先确定目标模型与用途,再匹配硬件,二手RTX 3090是性价比首选。
想在自己电脑上跑大语言模型,到底该选Mac还是PC?这是本地AI社区争论不休的话题。一位同时拥有RTX 4090、M5 Max MacBook Pro和英伟达DGX Spark的创作者,用真实跑分数据给出了一套可以量化的判断框架。核心结论其实很简单:别只看价格和品牌,先搞懂两个参数——内存容量和内存带宽。
AI模型本质是一堆数字,关键看能不能装进快内存
一个AI模型本质上就是数十亿个数字。当模型标注为「8B」时,指的是80亿个参数,而不是8GB。如果以全精度(每个参数16位)存储,80亿个参数约占16GB空间;而通过量化压缩到4位,大约只需4GB,再加上一点运行开销和对话上下文占用。
以当前最优秀的本地模型之一Qwen 3(约270亿参数)为例,它的4位版本必须完整放进「快内存」里才能真正可用。这里的关键在于:模型不能放在SSD或硬盘上,甚至不能放在普通系统内存里,它必须待在GPU能直接访问的内存中。
对Windows设备来说,这指的是独立显卡上的VRAM(显存);对Mac或DGX Spark这类设备来说,则是系统与GPU共享的统一内存(Unified Memory)。这个「容量」直接决定了你能否运行某个模型——如果显卡只有16GB显存,就无法完整装下一个17GB的模型。要么装得下,要么装不下,没有中间地带。
**量化(Quantization)**是理解本地AI的基础概念。神经网络的参数原本以32位或16位浮点数存储,但推理时并不需要这么高的精度。量化技术通过降低每个参数的位数(如从16位压缩到4位甚至2位),可以将模型体积缩减到原来的1/4甚至更小,代价是极小的精度损失。目前最常见的本地推理格式是GGUF(由llama.cpp主导),支持Q4_K_M、Q5_K_M、Q8_0等多种量化级别——数字越大精度越高但体积越大。以Qwen3 30B为例,Q4版本约17GB,Q8版本则约30GB。选择量化级别本质上是在「模型能否塞进内存」和「回答质量」之间做权衡,对于大多数日常任务,Q4精度已经足够。
一个公式预测模型跑多快:带宽除以模型体积
第二个关键参数是带宽(Bandwidth),它决定了模型运行速度。这里有个很少被提及的事实:模型每生成一个token,都要把整个模型从内存里完整读一遍。也就是说,运行Qwen 3时,每吐出一个字都要重新读取17GB数据。
由此得出一个实用公式:速度上限 = 内存带宽 ÷ 模型体积。
以M5 Max为例,其内存带宽约为614GB/s,运行17GB模型时理论上限约36 tokens/s,而作者实测约为31 tokens/s,相当接近。换成传说中的Mac Studio M5 Ultra(约1.2TB/s带宽),理论可达71 tokens/s;若运行更小的Qwen模型,甚至能到182 tokens/s。这个公式虽非100%精确,但能让你在花钱之前就大致预判性能。
这也解释了Mac与PC之争的本质:快而小 vs 大而慢。RTX 4090的显存读取速度超过1TB/s,但只有24GB;而统一内存池容量大、更便宜,速度却略逊于独立显卡的专用显存。
真实跑分:同一个模型,不同硬件差距巨大
作者引用Context Studio的硬件指南,展示了各类硬件运行Qwen 3(27B)的token解码速度(均为无优化基线):
- RTX 5090(32GB):约75 tokens/s
- RTX 4090:约46 tokens/s
- RTX 3090:约40 tokens/s
- M5 Max:31.4 tokens/s
- DGX Spark:12–17 tokens/s
- Ryzen AI Max:11.5 tokens/s
按作者经验,50–60 tokens/s以上就非常快,35–40也完全可用。但有个必须警惕的现实:一旦模型装不下显存、哪怕只有一小部分溢出到系统内存,速度会被腰斩甚至更惨。有研究做过实验,同一个小模型在RTX 5090显存里跑是151 tokens/s,一旦放进系统内存就只剩8 tokens/s——性能几乎直接砍掉95%。所以务必确保模型完整放进显存或统一内存。
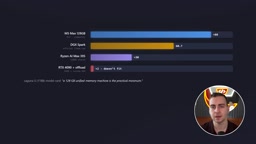
当模型变大时情况会反转。以GPT-OSS 120B(约60GB)为例,M5 Max(128GB)实测可达60–70 tokens/s(偶有报告88),DGX Spark约50,Ryzen AI Max约30;而RTX 4090/5090因为装不下,只能跑出1–2 tokens/s。追求最高智能的大模型时,大容量设备反而完胜高速小显卡。
别忽略提示处理速度:英伟达的真正优势
Token解码速度只是故事的一半,**提示处理(Prompt Processing)**同样关键——它决定机器读完你喂进去的文档后多久才开始回答。在同一组Qwen基准里,RTX 4090的输入处理速度约3000 tokens/s,而M5 Max约800 tokens/s。如果你要喂整个代码库或超长文档,英伟达的领先优势会非常明显。
提示处理速度的差异根源在于两种硬件的并行计算架构不同。英伟达GPU拥有大量专为矩阵乘法优化的CUDA核心,并配备Tensor Core加速,处理长序列输入时能够高度并行化,因此预填充(prefill)阶段吞吐量极高。Apple Silicon的GPU设计更偏向统一内存的高效读取而非大规模并行矩阵计算,在解码阶段(逐token生成)因为带宽优势表现不俗,但在一次性消化大量输入时明显落后。这一差异对实际工作流影响很大:如果主要用途是普通对话,提示通常很短,差距可以忽略;但若是RAG(检索增强生成)场景、代码库分析或将整本书喂入上下文,英伟达方案的响应起始延迟会比Mac短得多。
两个变化正在改写本地AI格局
第一是混合专家模型(MoE)的普及。 近期几乎所有大模型都是稀疏架构:DeepSeek广告 V4 Flash有2840亿参数但每个token只激活130亿;Qwen3 Coder Next有800亿参数但仅激活30亿。按前面的公式,这类模型只读取被激活的专家,因此需要巨大内存来容纳全部参数,却只需适中带宽即可快速运行——这恰恰是大容量Mac、DGX Spark等统一内存设备的强项,而非游戏显卡的强项。某模型卡甚至直接写明「128GB统一内存是运行它的实用底线」。模型开发者正在为统一内存而非独立GPU设计模型。
第二是「内存末日」。 AI数据中心正在吞噬全球内存供应,直接冲击了GPU定价,连DGX Spark的价格都从3900美元涨到了4699美元。内存既是AI最需要的东西,也是最贵的东西。
此外,苹果用M5芯片补上了一个大短板:每个GPU核心内加入了神经加速单元,提示处理速度比M4提升三到四倍。英伟达此前近10:1的领先,如今缩小到2–3:1。Mac虽仍落后,但不再因速度被「取消资格」。
**混合专家模型(Mixture of Experts,MoE)**的架构原理值得展开说明。传统的密集(Dense)Transformer模型在处理每个token时会激活全部参数;而MoE模型将参数分成若干"专家"模块,每次只由一个路由网络选择少数几个专家参与计算。这意味着模型需要将所有专家都加载进内存(以便随时调用),但实际计算量只对应被激活的那部分参数。对硬件的影响是:内存容量需求按总参数量计算,而速度瓶颈主要取决于激活参数量对应的带宽消耗。例如DeepSeek V4 Flash总参数2840亿但每token只激活130亿,其有效带宽需求远低于同规模密集模型,这使得带宽相对较低但容量超大的统一内存设备成为极具性价比的运行平台。
从300美元到数万美元的选购阶梯
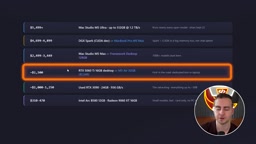
作者给出了一份不同预算的硬件梯队(价格随周、地区、配置波动,仅供参考):
- 顶级:Mac Studio M5 Ultra,1.2TB/s带宽、最高512GB统一内存,本地运行的终极设备,但价格极其昂贵。
- 约5000美元档:DGX Spark(更适合微调与无头服务器环境)或MacBook Pro M5 Max(内存更快但同容量贵得多,128GB版本可能逼近万元)。
- 中端:Mac Studio M5 Max桌面版、Framework Desktop(128GB统一内存)、RTX 5060 Ti(16GB,需搭配整机约1500美元起)、M5 Air(32GB,带宽慢但容量大)。
- 最佳性价比:二手RTX 3090,24GB显存、936GB/s带宽,作者直言「如果只为本地AI买一台,我会选它」。
- 入门:Intel Arc B580、RX 9060 XT等16GB卡,能跑但模型选择有限、性能一般。
创作者的个人取舍
同时拥有4090、M5 Max(64GB)和DGX Spark的作者坦言,三者都足以胜任本地AI。若只能选一个,他会倾向DGX Spark——128GB内存、速度够用、可常驻后台运行,而且比他那台64GB的Mac更便宜,本地AI表现反而更好(因为Mac缺了那128GB内存)。
最终的选购逻辑是反向工程:先确定你到底要跑什么模型、什么用途,再去匹配能满足需求的硬件。
- 想跑大模型、追求最高智能、为未来更大的模型留空间:选Mac、DGX Spark或Ryzen AI Max这类大统一内存设备。
- 在意原始token速度和提示处理速度,还想做微调、训练、图像视频生成:选独立英伟达GPU(5090/4090的32GB变体,或性价比极高的二手3090)。
没有放之四海皆准的标准答案,关键是看具体benchmark、看别人实测速度、看优化空间,确认达标再下单。
相关推荐

用Claude Code一天半做出AI测验:Vibe Coding的真实样本
一位开发者用Claude Code结合Opus 5.5与Fable 5.1,在一天半内做出一款PS1复古风格的AI主题测验游戏。本文解析这个业余项目背后的AI辅助编程实践与行业启示。

用Claude+Muse打造自动化膳食规划:AI如何替代HelloFresh
一位不懂编程的Reddit用户用Claude和Muse搭建了自动化膳食规划系统,涵盖菜单规划、沃尔玛自动下单、厨房平板界面,号称HelloFresh杀手。本文解析其工作流与AI生活自动化的启示。

构建语义代码搜索的RAG管道:原理与实践
本文解析如何为语义代码搜索构建RAG管道,涵盖代码分块、向量化、检索重排与生成四大环节,并探讨分块策略、embedding模型选择和索引维护等落地挑战。