本地跑大模型工具怎么选?五大主流方案一次讲清

五个本地大模型工具各有定位,按场景选型即可。
文章梳理了五个本地运行开源大模型的工具。llama.cpp 是 C++ 推理引擎,推出 GGUF 量化格式,是多数工具的共同底层;Ollama 在其上封装了模型下载与 OpenAI 兼容 API,适合快速原型;LM Studio 提供图形界面,方便普通用户浏览量化版本、按硬件条件切换模型;vLLM 面向生产多用户场景,靠分页注意力和连续批处理提升吞吐,SGLang 以 Radix Attention 在共享前缀的 RAG 和多轮对话中更快;MLX LM 专为苹果 M 系列芯片的统一内存设计,能加载 PC 需多块显卡才跑得动的模型。作者给出的选型路径清晰,并指出本地推理门槛已从「能不能跑」降为「怎么选」。
开源模型的能力已经足够强,很多场景下不必再依赖托管API。把模型直接跑在笔记本上,对话和数据都不会外泄。但面对 llama.cpp、Ollama、LM Studio、vLLM、MLX LM 这一串名字,到底该用哪个?本文基于B站技术科普视频的梳理,把五个工具的定位、底层原理和适用场景讲清楚。
底层基石:llama.cpp 与 GGUF 格式
llama.cpp 是一个用 C++ 写的推理引擎,CPU、GPU 和苹果芯片都能跑。它最初只是一个业余项目——想在 MacBook 上跑 LLaMA,后来却成了大多数本地工具的底层基础。
它对本地生态最大的贡献是推出了 GGUF 标准文件格式。一个 GGUF 文件就打包了权重、分词器和元数据,还支持量化到 4 比特甚至更低。大模型正因如此才塞得进普通电脑。从 Hugging Face 下载一个 GGUF,给 llama.cpp 传入模型和提示词,就能拿到输出的 token。
如果你想要最轻量的运行环境,或者要部署到资源受限的硬件上——比如边缘设备、没有独显的笔记本——就选 llama.cpp。
量化(Quantization) 是把模型权重从高精度(如 16 位浮点)压缩到低精度(如 4 位整数)的技术。模型参数本质上是一堆数字,原本每个数字占 2 字节甚至更多,量化后每个参数可能只占半个字节。代价是精度略有损失,但对话质量通常下降有限,而模型体积和内存占用能缩小到原来的四分之一甚至更少——这正是 70 亿参数模型能从十几 GB 压到 4GB 左右、塞进普通笔记本的原因。GGUF 常见的 Q4_K_M 这类命名,就表示 4 比特量化的某个变体。
KV 缓存(KV Cache) 是大模型逐 token 生成文本时的中间状态。生成每个新词都要参考前面所有词,为避免重复计算,模型会把已处理内容的键值向量存起来,这就是 KV 缓存。它随上下文长度和并发数线性增长,在多用户场景下往往比模型权重本身还占显存,因此如何管理 KV 缓存成了推理引擎性能的关键,后文 vLLM 的分页注意力正是针对它做的优化。
开发者首选:Ollama
Ollama 对 llama.cpp 做了封装,把它变成了开发者工具。模型下载、量化版本选择、启动本地服务,它都帮你搞定,然后就能和任意大模型聊天。运行 ollama run gemma 这类命令,它会拉取权重、启动本地服务,再给你一个聊天界面,这些都不用手动操心。
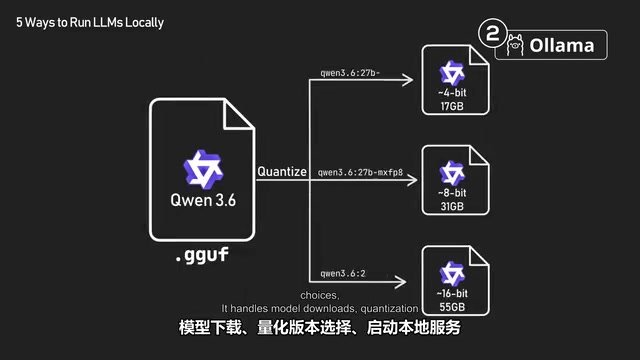
这个服务提供兼容 OpenAI 的 API,任何 OpenAI 客户端库只要改一下 BaseURL 就能用。想最快从选模型走到在代码里调用,就选 Ollama——工程师做 AI 系统原型最常从它入手。
图形界面之选:LM Studio
LM Studio 是一款带图形界面的大模型桌面应用,不用终端、不用配置文件,Linux、Mac、Windows 都能装。在应用里搜模型、点下载就能开聊,底层同样封装了 llama.cpp。
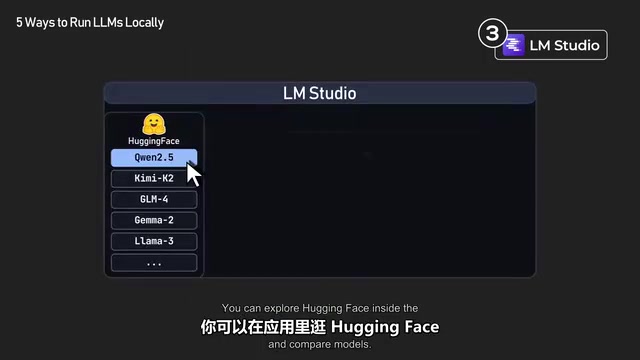
下载之前,界面就会告诉你硬件要求、量化版本、量化选项和 GPU 卸载设置;模型太大跑不动,它会提前警告。你可以在应用里逛 Hugging Face 查看所有量化版本,多下载几个不用重启就能随时切换,很容易找出适合自己硬件和任务的模型。普通用户只想要个简单界面和大模型聊天,选 LM Studio 最省事。
生产环境引擎:vLLM 与 SGLang
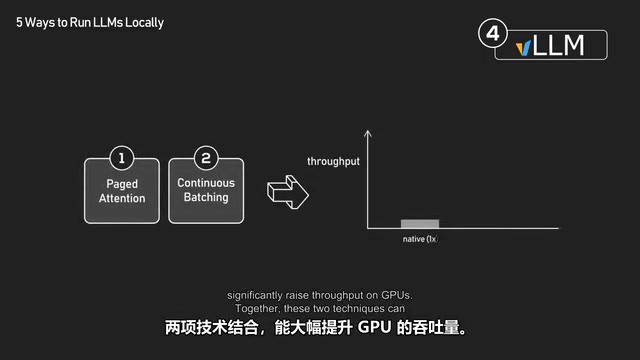
vLLM 是专为多用户并发服务打造的推理引擎。Ollama 适合快速做原型,vLLM 则面向生产——在多块 GPU 上跑高吞吐推理。它的速度主要靠两项技术:
- 分页注意力(PagedAttention):一种更省内存的注意力算法。没有它的话,KV 缓存要存成一整块连续内存,非常浪费;分页注意力把 KV 缓存切成固定大小的块,在显存里不必连续存放,省下来的显存能支持更大的批次,吞吐和并发都上去了。
- 连续批处理(Continuous Batching):一种请求调度技术。没有它的话,GPU 要等一个批次的请求全部完成才能开始下一批;有了连续批处理,一旦空出位置,新请求马上就能加入正在运行的批次。
两项技术结合能大幅提升 GPU 吞吐量。很多公司的内部聊天机器人、编程助手和批处理流水线背后跑的都是 vLLM。
vLLM 的替代方案是 SGLang,由伯克利 LMSYS 团队推出,用了一种叫 Radix Attention 的技术,靠树形结构缓存不同请求之间共用的提示词前缀,所以在 RAG 和多轮对话这类场景下特别快,因为这些提示词往往有很长的相同前缀。xAI 和很多 DeepSeek广告 部署生产环境跑的都是 SGLang。
如果已经过了原型阶段,要让本地模型扛真实流量——上线公司聊天机器人、给团队部署编程助手、跑大规模内部任务——那就用 vLLM 或 SGLang。
吞吐量(Throughput) 与延迟(Latency) 是两种不同的性能指标。延迟指单个请求从发出到拿到结果的时间,用户聊天时最在意它;吞吐量指单位时间内系统能处理多少请求或生成多少 token,服务方最在意它。Ollama 这类工具优先保证单用户低延迟,而 vLLM 这类引擎通过批处理把多个请求拼在一起算,牺牲一点单请求延迟来换取成倍的吞吐量。生产环境要同时服务成百上千用户,GPU 成本按小时计,吞吐量直接决定单位请求的成本,这就是两者定位分化的根本原因。
苹果芯片专属:MLX LM
MLX LM 是苹果推出的工具,专门在 M 系列芯片的设备上跑大模型,关键优势在于内存架构。
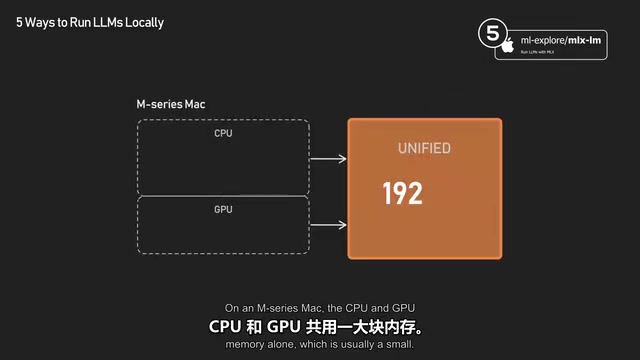
普通电脑的 CPU 和 GPU 内存是分开的,模型只能放进 GPU 的显存,而显存通常都不大。M 系列 Mac 上 GPU 共用一大块内存,一台 192GB 内存的 Mac Studio 能加载在 PC 上得用好几块昂贵显卡才跑得动的模型。MLX LM 就是为充分利用这一点而生的。如果你用的是苹果芯片的 Mac 又想要最快的速度,选它就对了。
统一内存架构(Unified Memory) 指 CPU 与 GPU 共享同一块物理内存,而不是各自拥有独立的内存池。传统 PC 上,模型必须完整拷贝进 GPU 显存才能高效计算,显存不够就只能换卡;而 M 系列芯片的 GPU 能直接访问系统内存,模型加载进内存即可参与计算。代价是这块内存的带宽低于高端独立显卡的显存带宽,所以苹果芯片胜在「能装下」超大模型,在绝对算力上未必比得过多卡工作站。MLX 是苹果专为此架构开源的数组计算框架,MLX LM 则是其上的大模型推理工具。
选型建议与趋势判断
不同人群的建议可以归纳为:快速上手开发先用 Ollama;普通 AI 用户就用 LM Studio;生产环境部署选 vLLM 或 SGLang;苹果芯片用户 MLX LM 是个好选择;而 llama.cpp 是这些工具的底层基础,想深入研究或适配冷门硬件可以直接用它。
两年前在自己电脑上跑前沿模型还不现实,如今这五个工具随便选一个,不到一小时就能搞定。本地推理的门槛已经从「能不能跑」降到了「怎么选更合适」,这也是开源模型生态成熟最直观的信号。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。