本地图像编辑模型何时能追上Nano Banana Pro?

开源图像编辑模型因"拼贴感"难题仍落后于谷歌NBP,社区寄望Krea 3填补缺口。
一位Reddit用户的对比测评揭示了当前AI图像生成开源生态的核心矛盾:文生图领域已有Krea 2等优秀本地方案,但图像编辑(I2I)能力上,距谷歌Nano Banana Pro(NBP)发布近一年,仍无本地模型能够与之竞争。NBP凭借单张参考图即可高度还原人物个体性与三维空间感,被形容为"即时生成LoRA";而现有开源模型在重新构图与重打光任务中,往往只是将人物"粘贴"进新场景,产生明显的拼贴感。Krea 2虽在文生图和低退化LoRA训练上表现优异,却无法弥补编辑能力的缺失。社区将填补这一空白的希望寄托在尚未发布的Krea 3上,这也折射出图像编辑正逐渐成为开源与云端模型竞争的下一个主战场。
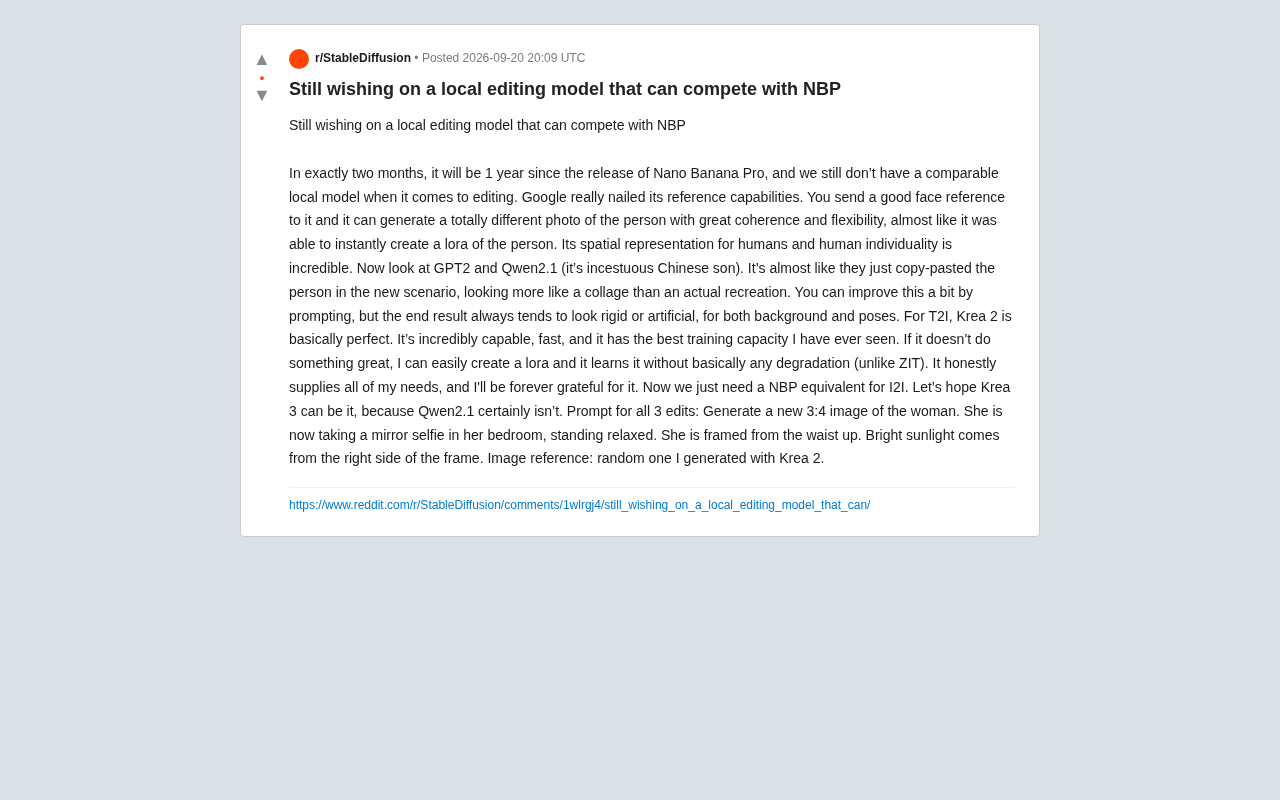
在AI图像生成领域,文生图(T2I)的开源生态已经相当成熟,但图生图与图像编辑(I2I)这块,本地模型与云端顶级方案之间仍横亘着一道明显的鸿沟。一位Reddit用户近期的观察,精准道出了不少创作者的共同困扰:距离Nano Banana Pro(下称NBP)发布即将满一年,社区依然没有等来一个真正能与之抗衡的本地编辑模型。
NBP的参考能力:像是即时生成了一个LoRA
这位用户对Google的NBP给出了极高评价,核心在于它对人物参考图的处理能力。按照描述,只需要提供一张质量不错的人脸参考,NBP就能生成这个人在完全不同场景下的照片,并保持高度的一致性与灵活性——"几乎像是它瞬间为这个人训练了一个LoRA"。
这个类比很值得玩味。在开源社区里,想要稳定复现某个特定人物,通常需要收集多张图片、训练专属LoRA模型,耗时耗力。而NBP把这一整套流程压缩到了单张参考图的推理过程中。用户特别强调,NBP对人体的空间表征以及"人物个体性"的还原能力令人印象深刻——它理解的不只是五官的排列,而是这个人作为独立个体在三维空间中的存在方式。
LoRA(Low-Rank Adaptation)是一种轻量级的模型微调技术,最初由微软研究院提出,后被AI图像生成社区广泛采用。它的核心思路是:不修改预训练模型的全部权重,而是在原有权重矩阵旁注入低秩的"增量矩阵",仅需训练极少量参数即可让模型学会特定风格、人物或概念。在图像生成社区中,用户通常需要为某个特定人物收集10到30张不同角度、光照的参考图,花费数十分钟乃至数小时训练,才能得到一个能稳定复现该人物外貌的LoRA文件。NBP通过单张图片在推理阶段完成类似效果,意味着它在模型内部实现了某种"即时人物绑定"机制,将传统上需要显式训练的知识压缩进了单次前向传播的上下文中,这在技术路线上与LoRA微调有本质区别,更接近于多模态大模型的上下文少样本学习(few-shot in-context learning)能力。
开源编辑模型的通病:更像拼贴而非重建
相比之下,用户对当前的本地方案——他提到的"GPT2"和"Qwen2.1"(并戏称后者是前者"近亲繁殖的中国儿子")——评价则要苛刻得多。他的核心批评是:这些模型做编辑时,"几乎就像是把人物复制粘贴到了新场景里",结果看起来更像拼贴画(collage),而不是真正的重新创作。
这种"贴图感"是当前开源I2I模型的典型短板。虽然通过精心设计的提示词可以缓解一部分问题,但最终成品往往在背景和姿态上都显得僵硬、人工痕迹重。模型缺乏对场景的整体理解,无法让人物自然地"融入"新环境——光照、透视、姿态的连贯性都难以做到位。
为了公平对比,该用户对三个模型使用了完全相同的提示词:"生成一张3:4的新图片,画面中的女性正在卧室里拍镜子自拍,放松站立,取景到腰部以上,明亮的阳光从画面右侧照入。"参考图则是他自己用Krea 2生成的一张随机图像。从他的反馈来看,本地模型在这类需要重新构图与重打光的编辑任务上,与NBP的差距依然明显。
图像编辑任务(Image-to-Image,I2I)在技术层面远比文生图复杂,因为模型必须同时满足两个相互制约的目标:忠实保留参考图中的身份信息(ID preservation),以及合理适应新场景的光照、透视与姿态约束。当前开源模型的"拼贴感"本质上是这两个目标失衡的结果——模型过于依赖参考图的像素级特征,将人物轮廓和纹理近乎原样地"粘贴"到新背景上,而缺乏对三维空间的隐式建模能力,无法推断人物在新视角下的形变、自阴影以及与环境光源的交互关系。云端大模型通常拥有数十亿乃至千亿级参数,并在海量多视角人物数据上进行专项训练,得以建立更深层的三维先验知识;而本地开源模型受限于参数规模和训练数据的规模与多样性,往往只能学到浅层的纹理迁移,难以完成真正意义上的场景重建。
T2I已经够用:Krea 2的训练能力被大力称赞
有意思的是,这位用户对文生图环节反而相当满意。他把Krea 2形容为"基本完美"——能力强、速度快,而且拥有他"见过的最好的训练能力"。
他给出的具体理由是:当Krea 2某些内容表现不够理想时,他可以轻松训练一个LoRA,模型几乎不会出现退化(degradation),这一点明显优于他提到的"ZIT"。对于依赖定制化训练的创作者而言,"低退化"是个极为关键的指标——它意味着你在教模型新东西的同时,不会破坏它原有的能力。用户直言,Krea 2已经能满足他文生图的全部需求。
LoRA训练中的"退化"(degradation)问题,指的是在向基础模型注入新概念后,模型在原有能力上出现性能下降的现象——例如学会了某个人脸特征后,开始在无关生成任务中也强行引入该特征,或者通用解剖结构、光影表达等能力变弱。退化程度与多个因素相关,包括训练步数、学习率、数据集的多样性以及基础模型的架构设计。低退化率是衡量一个基础模型"可训练性"的重要指标,对于需要大量定制LoRA的专业工作流尤为关键——创作者希望每个专属LoRA都能精准控制目标特征,同时对模型整体能力的影响降到最低,从而允许多个LoRA混合叠加使用而不产生不可预测的相互干扰。
缺失的最后一块拼图:一个本地版NBP
综合来看,这条帖子勾勒出的现状是:开源生态在T2I上已经交出了令人满意的答卷,真正的缺口在于图生图与图像编辑。用户把希望寄托在了尚未到来的Krea 3上,认为它有可能成为那个"本地版NBP",同时也明确表示Qwen2.1肯定不是答案。
这个诉求背后其实是一个更普遍的行业趋势判断:图像编辑正在成为下一个竞争焦点。云端模型凭借更大的参数规模和训练数据,在人物一致性、空间理解上建立了优势;而本地开源阵营在文生图领域追平后,能否在编辑能力上完成同样的追赶,将决定它们能否满足专业创作者的完整工作流。
需要说明的是,这些评价来自单一用户的主观体验,其提到的模型名称(如"GPT2""Qwen2.1""Krea 2/3""ZIT")也可能是社区内的非正式称呼或个人简写,结论仅供参考。但它反映的痛点——本地编辑模型的"拼贴感"与人物一致性不足——确实是当下开源图像生态的真实短板,值得关注后续开源模型能否在这一维度取得突破。
相关推荐

Agent Gateway 接入 Cloud Trace:AI智能体请求的端到端追踪
Google Cloud 的 Agent Gateway 现已集成 Cloud Trace(预览阶段),可将一次 AI 智能体请求的智能体、网关、工具与 MCP 服务器全部调用收拢到同一条端到端追踪链路,基于 OpenTelemetry 标准实现,帮助开发者精准定位性能瓶颈。
OpenAI遭遇黑客入侵 Altman面临法律风险累积
OpenAI在内部调查中发现系统遭黑客入侵,CEO奥特曼同时面临法律风险累积。本文梳理AI公司数据安全隐患、企业治理争议与合规挑战,分析事件背后的行业启示。

mcp.so 实用指南:一站式发现MCP服务器扩展AI编程能力
mcp.so 是一个发现 MCP 服务器的目录平台,帮助 AI 编程开发者为智能体连接外部工具和服务。本文介绍它的功能、使用方法以及对 AI 工作流的价值。