本地Whisper vs 云端听写:隐私、延迟与准确率如何权衡

本地Whisper不等于更快更准更私密,隐私、延迟与准确率需按整条管线权衡。
文章把语音听写的选型拆成隐私、延迟、准确率三个问题。隐私上,即使语音转文本在本地,云端LLM格式化仍会让转录文本离开本机,词汇表和剪贴板同步也是侧信道,因此私密是整条数据路径的属性而非单一模型的属性。延迟上,本地不一定更快,取决于模型大小与硬件,首次加载大模型后转录会明显变慢,长语音需依赖停顿分块流式转录来掩盖等待。准确率上,公开WER不代表你的口音与术语场景,文章给出用whisper.cpp配合jiwer对base/small/medium做真实文本基准测试的方法,并指出术语错误应靠词汇表纠正而非更大模型。最后给出本地Whisper加本地OpenAI兼容LLM格式化、断网验证的完全私密配置,并说明云端在弱硬件、多语言和移动端仍占优。
本地Whisper vs 云端听写:隐私、延迟与准确率如何权衡
"直接在本地跑Whisper"是一句听起来很对、但跳过大量细节的建议。本地语音转文本确实有用,但它并不自动意味着更快、更准,甚至不一定完全私密——这取决于你的处理管线里还塞了哪些环节。
本文把选择拆成三个问题:什么数据离开了你的机器、延迟到底花在哪里、以及模型对你的声音有多准。最后给出一个数据不出本机的完整配置方案。虽然以InsertKit作为听写前端举例,但其中的权衡适用于任何技术栈。
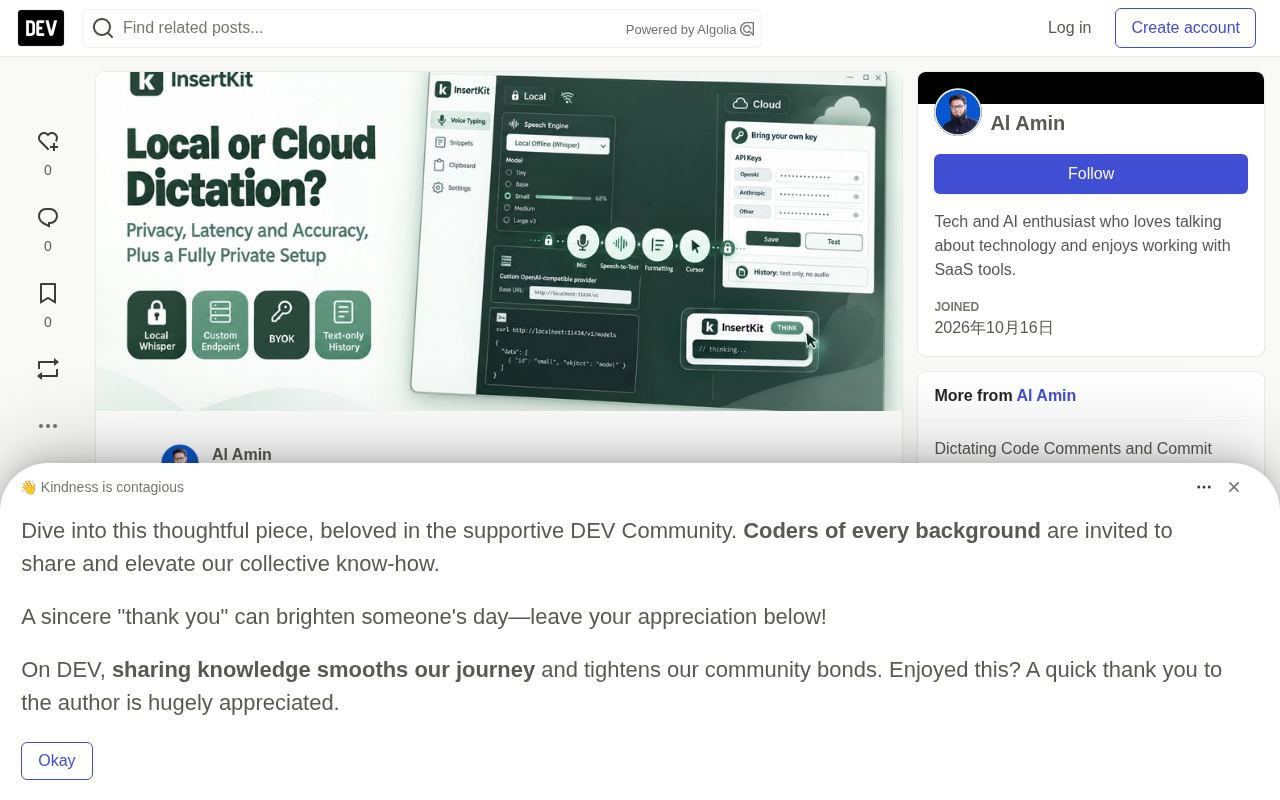
隐私:先画清楚数据流
一套现代听写管线通常包含两个阶段:
麦克风音频 -> [语音转文本] -> 原始转录文本 -> [LLM格式化] -> 光标处文本
每个阶段都可以在本地或远程执行,而人们经常加固了其中一个却忘了另一个。
- 语音转文本:用云端引擎时,音频会被上传到提供商处理;用本地Whisper模型时,音频留在你的机器上。
- 格式化:去填充词、修标点、调整语气通常由聊天模型完成。如果这个模型在云端,那么即使音频没出本机,你的转录文本也已经离开了。
- 侧信道:同步功能也算数。在InsertKit中,片段、剪贴板历史、自定义词汇表和API密钥都会同步到你的账户。如果你的词汇表里包含某个未发布产品的代号,那么即使每个音频片段都在本地,这个词表本身也已经被同步了。
值得精确了解InsertKit存储了什么:设置→用量中的云端语音历史覆盖最近30天,仅文本、不含音频,并配有清除按钮。本地语音历史留在设备上,将其上限设为0即可禁用。
所以"私密"不是一个模型的属性,而是整条路径的属性。
侧信道(side channel) 在安全语境中指不直接传输目标数据、却间接泄露信息的路径。在听写工具里,最典型的侧信道是账户同步:音频和转录文本可能都留在本机,但自定义词汇表、剪贴板历史和片段库如果被同步到云端账户,那么词表中出现的项目代号、客户名称或内部术语就已经离开了你的机器。防御思路是逐项审计“哪些数据会被同步、同步到哪里、能否关闭”,而不是只盯着音频这一条主路径。对敏感场景,最稳妥的做法是关闭同步或使用不绑定账户的本地配置。
延迟:毫秒到底花在哪
本地不一定更快。粗略拆解如下:
云端:上传时间 + 排队 + 快硬件上的推理 + 下载。在良好连接下,短语音可以很快返回,因为提供商在强劲GPU上跑大模型。
本地:零网络,但推理跑在你的CPU或GPU上。现代笔记本上的小模型响应不错;老旧CPU上的大模型可能比你说话的时间还长。
实践中两个关键细节:
- 模型加载:加载大模型后的第一次转录会比后续慢,这一点要有预期。
- 长听写:如果工具等你讲完三分钟的长篇大论才开始转录,你就得在最后等全部处理完。InsertKit会在自然停顿处把长语音切块,在你继续说话时边转边输出,这在本地和云端都能掩盖大部分延迟。
准确率:用你自己的声音做基准测试
公开的词错误率(WER)来自基准数据集,不是你的口音、麦克风或行业术语。十分钟的实际测试胜过任何排行榜。
下面是一个与工具无关的快速方法,用whisper.cpp比较不同Whisper模型大小:
git clone https://github.com/ggml-org/whisper.cpp
cd whisper.cpp
cmake -B build
cmake --build build -j --config Release

for m in base small medium; do
  sh ./models/download-ggml-model.sh $m
done


**词错误率(Word Error Rate, WER)** 是语音识别领域最常用的准确率指标,计算方式为 `(替换词数 + 删除词数 + 插入词数) / 参考文本总词数`。WER 越低,识别越准。但它的局限也很明显:它按“词”而非“语义”计分,一个专有名词拼错和一句语法错误可能被算作同样的代价;而且基准数据集(如 LibriSpeech、Common Voice)的录音条件、说话人口音和领域词汇与你的实际工作场景往往差异巨大。因此排行榜上的 WER 只能作为模型能力的粗略参考,真正有决策意义的数字来自用你自己的录音和真实文本计算出的 WER。
# 把一段60秒的真实工作文本朗读录音转为16kHz单声道WAV
ffmpeg -i sample.m4a -ar 16000 -ac 1 -c:a pcm_s16le sample.wav

for m in base small medium; do
  /usr/bin/time -p ./build/bin/whisper-cli -m models/ggml-$m.bin -f sample.wav -otxt -of out-$m
done
然后把每个输出与你实际说的内容对比打分:
# pip install jiwer
from jiwer import wer

ref = open("reference.txt").read()
for m in ["base", "small", "medium"]:
    hyp = open(f"out-{m}.txt").read()
    print(m, "WER:", round(wer(ref, hyp), 3))
要用真实材料:一条提交信息、一张工单描述、一段满是服务名的段落。通用句子会美化所有模型。
你可能会看到几个规律:
- 更大的模型对口音和噪音处理更好,代价是速度和内存。
- 行业术语在所有尺寸上都容易出错。这是词汇表问题,不是模型大小问题。
- Whisper在静音或噪音上可能产生幻觉,输出没人说过的文本。修剪静音、用好点的麦克风可以减少这种情况。
对于术语问题,修正层比更大的模型更有帮助。InsertKit的自定义词汇表提供词提示和"听到为→写为"的纠正规则,比如post gres→Postgres,并且纠正在格式化前后都会执行,这样LLM无法把它们改回去。
决策简化版
- 音频绝不能离开本机:本地Whisper。
- 普通硬件上要速度:云端,或小的本地模型。
- 困难音频要高准确率:带GPU的大本地模型,或强云端引擎。
- 零配置:无需密钥的托管引擎。
- 气隙环境或离线工作:本地Whisper加本地LLM,或关闭格式化。
许多开发者最终走向混合模式:涉及客户代码或内部文档时用本地,低风险的闲聊用云端。
完全私密的听写配置
以下配置让音频和文本都留在你的机器上。本地Whisper是InsertKit的桌面功能(Windows、macOS、Linux)。
第一步:本地语音转文本
在语音引擎面板中选择本地离线(Whisper),在应用内下载模型。尺寸从Tiny(约75 MB)、Base(约140 MB)到Small(约460 MB)、Medium(约1.5 GB),再到Large v3(约3 GB)。用你的基准测试结果来选。大多数笔记本上Small是个合理的起点。
第二步:本地LLM做格式化
运行一个本地OpenAI兼容服务器。用Ollama:
ollama pull llama3.2
curl http://localhost:11434/v1/models
LM Studio暴露类似的服务器,默认在http://localhost:1234/v1。
在InsertKit中,打开设置→API密钥,添加一个自定义OpenAI兼容提供商:名称、基础URL(例如http://localhost:11434/v1)、服务器需要的密钥,以及模型(自动获取或手动输入)。然后为智能格式化选择该模型。
较小的本地模型做清理格式化已经足够。如果输出太有创造力,在使用我自己的指令下添加一段简短的自定义指令,比如"修正标点并删除填充词。不要添加或更改内容。"
Ollama 是一个在本地运行大语言模型的开源工具,它把模型下载、量化和推理服务打包成一条命令,并在 http://localhost:11434 暴露一个与 OpenAI Chat Completions API 兼容的 HTTP 接口。所谓“OpenAI 兼容”意味着任何原本调用 https://api.openai.com/v1/chat/completions 的客户端,只要把基础 URL 换成 Ollama 或 LM Studio 的本地地址、密钥随便填一个占位符,就能无缝切换到本地模型。LM Studio 是同类工具,提供图形界面和类似的服务端,默认监听 http://localhost:1234/v1。两者都让“本地格式化”不需要改代码就能接入,代价是本地推理速度受限于你的 CPU/GPU 和模型参数量。
第三步:决定格式化不可用时怎么办
启用离线继续工作,这样格式化器无法连接时会粘贴原始转录文本。或者对敏感会话跳过格式化,依靠词汇纠正。
第四步:验证,不要假设
关掉Wi-Fi(Linux上运行nmcli networking off),在编辑器中口述一段话。如果文本仍然出现且已被格式化,说明两个阶段都是本地的。之后记得重新打开网络,因为账户同步需要它。
Linux注意事项
检查设置→通用→Linux依赖。打字和粘贴依赖xdotool和wtype等工具,在Wayland上提示会指向wtype或ydotool。
云端仍然占优的场景
公平地说,云端听写也有其优势:
- 不占本地资源:长构建期间,大模型不会吃掉你的内存或电池。
- 弱硬件上质量稳定。
- 语言覆盖:InsertKit的语音输入覆盖100多种语言并支持自动检测。如果你用多种语言口述,在固定用本地模型前要对每种语言做基准测试。
- 移动端:InsertKit的Android应用使用托管或BYOK引擎,那里没有设备端Whisper。
如果用云端,至少要有意识地选择。InsertKit Free无需密钥但有每日限额,Premium使用积分,BYOK覆盖OpenAI、Groq、Deepgram、AssemblyAI和ElevenLabs等提供商。
收尾
本地Whisper是私密工作的强默认选项,但隐私取决于整条路径,延迟取决于你的硬件,准确率取决于你自己的声音。用真实文本做基准测试,为你的技术栈添加词汇纠正,并在断网状态下验证你的配置。
如果你想尝试这套配置,桌面版构建在 insertkit.com/download。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。