本地运行的AI Agent:断网也能持续工作的新范式

AI Agent 从云端转向本地运行,在连续性、隐私与工具集成上获得优势,但需承担算力与运维代价。
文章从一条推文出发,探讨了 AI Agent 运行位置这一被忽视的架构维度。当前主流 Agent 将推理和执行放在云端,隐含前提是设备必须时刻在线,一旦断网任务链便断裂。本地运行的 Agent 把推理与执行都放在本机,手机仅作遥控器,从而带来三大优势:任务连续性不再受网络绑架、敏感数据无需上传第三方、与本地文件系统和工具链天然契合。但本地方案也有明显代价:算力受硬件限制、运维成本转移到用户、跨设备协同更复杂。文章认为,这一转变代表了 Agent 正从「你调用的服务」变为「你拥有的进程」,其背后是端侧模型能力提升、设备算力过剩与数据主权意识增强等趋势的叠加。
从「云端依赖」到「本地自治」:Agent 运行位置的关键转变
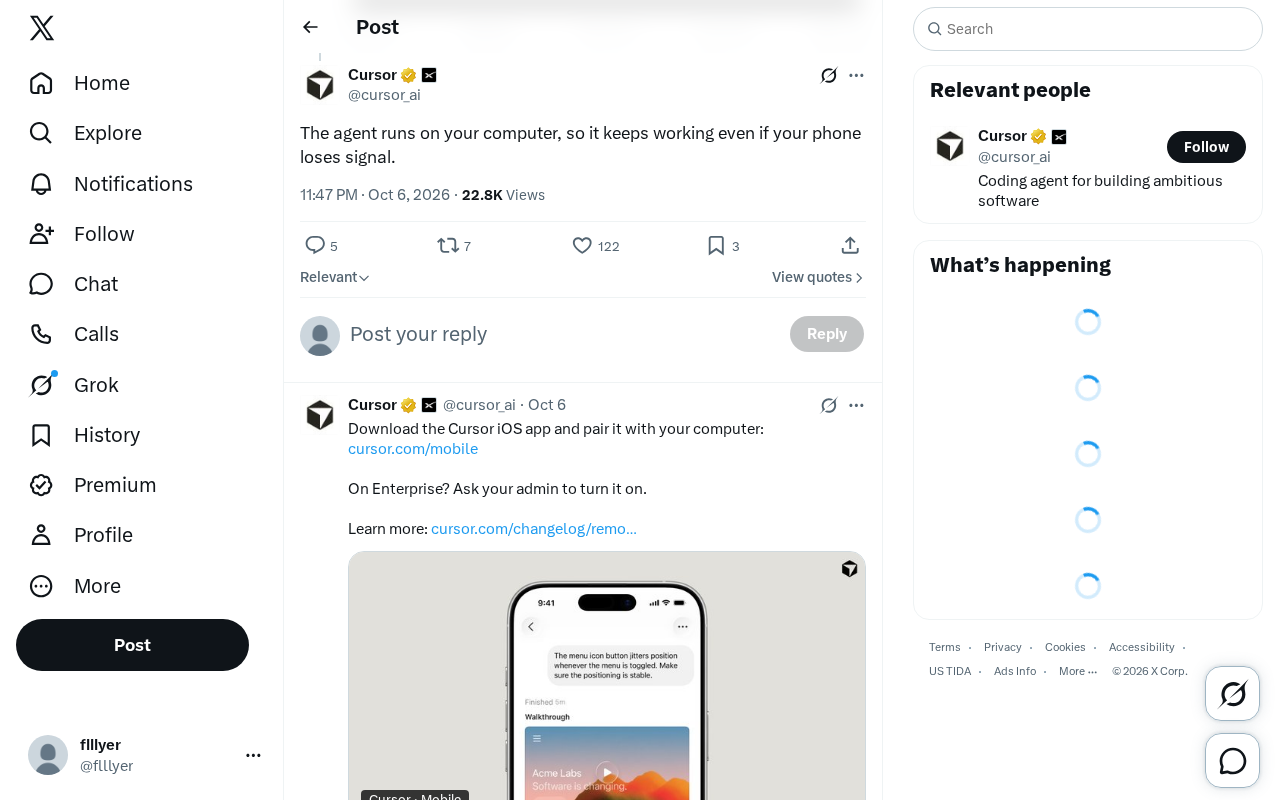
最近在 Twitter 上有一条简短但值得深思的推文:"The agent runs on your computer, so it keeps working even if your phone loses signal."(Agent 运行在你的电脑上,所以即使手机失去信号,它也能继续工作。)
这句话表面在讲「断网可用」,实际点出的是 AI Agent 架构中一个被长期忽视的维度——运行位置。
当前主流 AI Agent 产品大多把推理和执行放在云端:你通过手机或网页发出指令,请求被发送到远端服务器,模型在数据中心完成推理,再把结果推回终端。这套架构的优势是算力集中、模型统一、迭代方便,但它隐含了一个前提——你的设备必须时刻在线。
一旦手机信号中断、Wi-Fi 不稳,或者你只是走进电梯、地下车库,任务链就会断裂。对于「帮我盯着某个流程」「定时整理本地文件」这类需要持续运行的任务来说,这是结构性缺陷。
「在你自己电脑上运行的 Agent」正是针对这个缺陷提出的解法。
**AI Agent(智能体)**与传统的聊天机器人有本质区别。聊天机器人通常是「一问一答」的被动响应模式,而 Agent 具备目标导向的自主性:它能拆解任务、规划步骤、调用工具(如读写文件、执行代码、访问网络),并在多轮循环中根据中间结果调整策略,直到完成目标。正因为 Agent 需要持续运行、反复调用外部能力,它对「运行在哪里」这一物理条件异常敏感。云端 Agent 的每一次工具调用都要经过网络往返,一旦连接中断,整个执行链路就会崩溃;而本地 Agent 把规划、推理和执行都放在同一台机器上,任务状态始终保存在本地进程中,天然具备更强的连续性与容错能力。
本地 Agent 解决了什么问题
连续性不再受网络绑架
把 Agent 部署在本机后,推理与执行都在本地完成。手机只是「遥控器」——发号施令的入口,而不是任务本身的载体。手机断线,Agent 仍在你电脑上按既定计划推进;等你重新连上,看到的是已经处理好的结果,而不是一条「任务失败」的提示。
这与传统「云 Agent + 移动端控制」的体验有本质区别:后者把可用性绑定在移动网络上,前者把可用性绑定在电脑的电源和进程上——而后者通常远比移动信号稳定。
数据不必离开设备
本地运行的另一个直接收益是隐私边界的变化。当 Agent 在本机处理文件、读取目录、调用本地工具时,敏感数据不需要被上传到第三方服务器再返回。对于处理合同、代码库、个人笔记等内容的场景,这一点往往比「断网可用」更具吸引力。
**端侧模型(On-device Model)**是本地 Agent 得以成立的技术前提之一。近年来,随着模型量化、蒸馏和小型化技术的成熟,参数规模在数十亿级别的模型已能在消费级笔记本甚至手机上流畅运行。量化技术通过降低权重精度(如从 FP16 压缩到 INT4)大幅减少内存占用和算力需求,而蒸馏则让小模型学习大模型的输出分布,在特定任务上逼近大模型效果。这意味着本地 Agent 不必依赖云端大模型也能完成相当一部分推理工作。当然,端侧模型的「能力上限」仍受硬件制约,复杂推理任务可能仍需在本地小模型与云端大模型之间做动态分流,这也是「混合架构」正在成为主流选择的原因。
与本地工具链天然契合
本机 Agent 可以直接操作本地文件系统、调用已安装的软件、接入本地数据库或开发环境。这类任务在纯云端架构下往往需要额外的同步层或权限代理,而本地运行把它们变成「本来就在同一台机器上」的简单问题。
代价与取舍:本地 Agent 并不免费
推文强调的是优点,但完整的判断需要看到另一面。
算力约束。 本地能跑的模型规模受限于你的硬件。想要接近云端大模型的能力,需要足够强的 GPU 和内存,这本身是一道门槛。
运维成本转移。 云端 Agent 的升级、维护、故障恢复由服务商负责;本地 Agent 的进程管理、依赖更新、崩溃重启,都落到了用户头上。要让它「持续工作」,你得先保证它不会因为一次系统休眠而静默退出。
跨设备协同变复杂。 任务绑定在某一台电脑上,意味着换设备、多设备并行时,状态同步需要额外设计。云端方案的天然优势在这里反过来成了本地方案的短板。
**进程守护(Process Supervision)**是本地 Agent 实现「持续工作」的关键工程环节。与云端服务由平台自动保障进程存活不同,本地 Agent 需要面对系统休眠、内存回收、意外崩溃等一系列本地环境特有的中断风险。要让它真正「一直在线」,通常需要引入进程守护机制(如 systemd、launchd、supervisor 等),在进程异常退出时自动拉起,并配合日志记录、断点续跑、任务队列持久化等策略,确保重启后能从上次中断处继续执行。这也是本地 Agent 与「一次性脚本」的核心差异:前者要求任务状态可恢复,后者只需一次运行到底。对普通用户而言,这套运维逻辑本身就构成了一定的使用门槛。
这个方向为什么值得关注
这条推文之所以被转发讨论,不在于它宣布了某项新技术,而在于它代表了一类架构选择正在被更多人认真对待:把 Agent 从「你调用的服务」变成「你拥有的进程」。
这个转变背后是几个趋势的叠加——端侧模型能力持续提升、个人设备算力过剩、以及用户对数据主权的敏感度上升。当这些条件同时成立,「Agent 跑在谁的机器上」就不再是实现细节,而是产品定位的核心问题。
对开发者而言,值得思考的是:你的 Agent 在断网、休眠、重启之后,还能不能接着干活?对用户而言,值得问的是:你希望这个替你行事的程序,住在别人的服务器上,还是住在你自己的电脑里?
相关推荐

WorkBuddy全流程教程:从零搭建AI办公自动化智能体
WorkBuddy 全流程教程精讲:从下载安装、三种工作模式到多模态绘本视频实战,再到专家团搭建智能体与工作流配置,帮你用低成本 AI Agent 实现办公自动化。

WorkBuddy智能体全攻略:7天从入门到自动化实战
基于B站256集WorkBuddy全套精讲课程,系统拆解腾讯AI办公工作台的核心能力:Agent原理、Skill封装、连接器跨平台、定时自动化、知识库与零代码开发,附学习路径建议。

8个AI账号翻车7个:我用AI干活的真实复盘
B站8个AI运营账号仅1个跑通。本文拆解"演AI"与"用AI干活"的本质区别,分析5条视频217万播放背后的产能控制、评论区运营和交付节奏策略。