本地自主智能体打造电商listing全流程:架构选型与开源工具实战

为中小电商卖家拆解如何用LangGraph、Instructor等工具,将半自动上架流程渐进式升级为可控的AI Agent工作流。
一位经营dropshipping店铺的卖家希望将手动选品、文案生成、API推送等分散环节整合为端到端的自主智能体工作流。文章围绕其RTX 4070 Ti(12GB显存)的硬件条件,逐一拆解了硬件瓶颈、反爬风险、框架选型三大核心问题,并给出务实建议:本地模型胜任文案批处理,复杂规划交给商用API;平台数据优先走官方目录而非绕过反爬;对线性流程的上架任务,单模型配Instructor+Pydantic约束输出比多智能体更可控。最终推荐以LangGraph为编排骨架、保留human-in-the-loop节点、渐进式扩大自动化边界的方案,而非一步到位追求全自主智能体。
一位经营小型 dropshipping 店铺的卖家在 Reddit 上抛出了一个颇具代表性的问题:如何把半自动的电商 listing 生成流程,升级为端到端的自主智能体(autonomous agent)工作流。这个问题背后,折射出大量中小电商从业者在 AI Agent 浪潮下的真实困惑——本地硬件能否支撑?该选哪套开源框架?多智能体是否值得?
本文结合这位卖家的具体场景,拆解自主智能体在电商选品与上架环节的架构设计思路,并给出工具选型的实用建议。
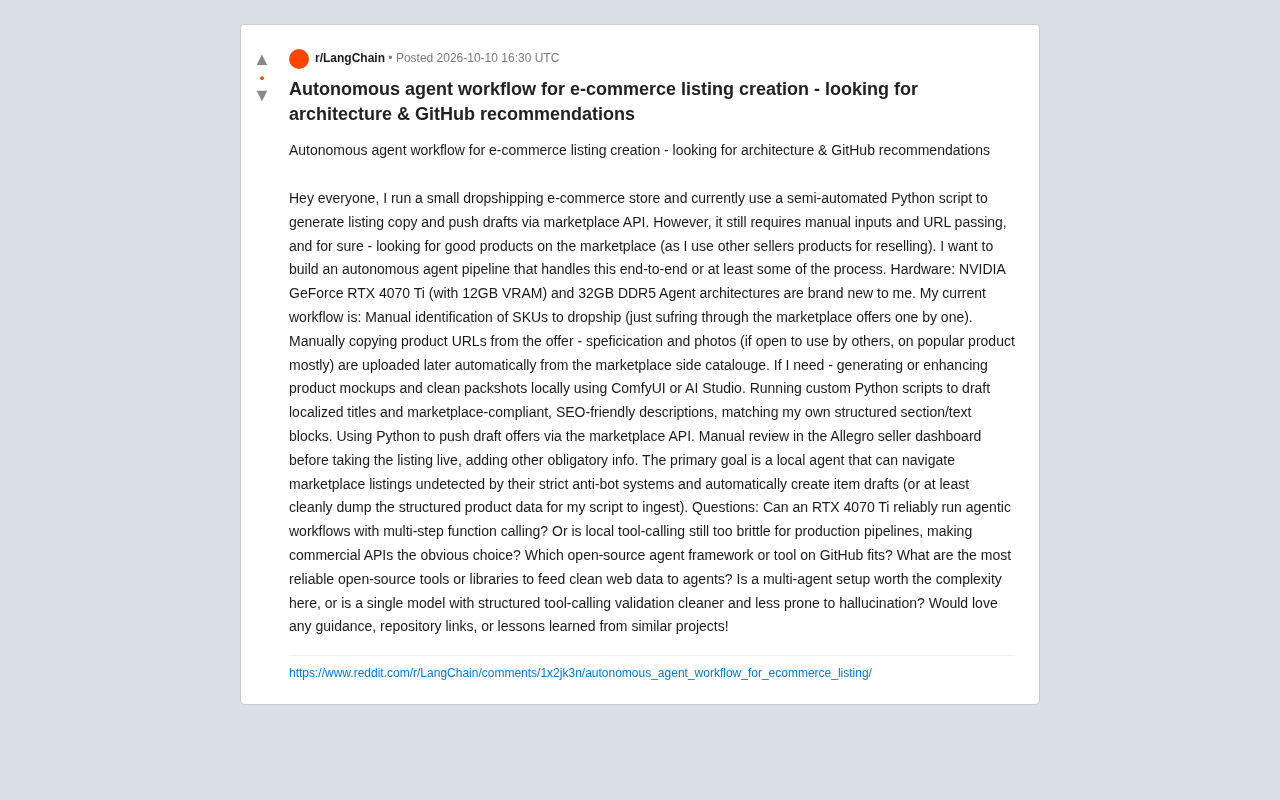
现状:一个典型的半自动电商流程
这位卖家目前的工作流具有很强的代表性,可以拆成几个阶段:
- 人工选品:逐条浏览 marketplace(如 Allegro)上的其他卖家报价,手动挑选适合转售的 SKU。
- 手动传递数据:复制产品 URL,规格与图片随后由平台侧目录自动带入。
- 本地图像处理:用 ComfyUI 或 AI Studio 生成、增强产品效果图与干净的包装图。
- 脚本生成文案:自定义 Python 脚本撰写本地化标题和符合平台规则、SEO 友好的描述,套用自己的结构化文本模块。
- API 推送草稿:通过 marketplace API 把草稿上架。
- 人工复核:在 Allegro 卖家后台补充必填信息后再正式发布。
其核心痛点非常明确:选品和数据抓取仍高度依赖人工,而平台严格的反爬系统(anti-bot)让自动化导航变得棘手。他希望构建一个本地智能体,能在不被检测的情况下浏览商品、自动创建草稿,或至少把结构化产品数据干净地导出给现有脚本使用。
硬件问题:RTX 4070 Ti 跑得动 Agent 吗?
卖家的配置是 RTX 4070 Ti(12GB 显存)加 32GB DDR5 内存。这个配置能否可靠运行多步函数调用(multi-step function calling)的智能体工作流,是他最关心的问题之一。
现实地看,12GB 显存是一道明显的门槛。它足以运行 7B~14B 量级的量化模型(如 Qwen2.5、Llama 3.1 8B 的 4-bit 量化版本),这类模型在结构化输出和基础工具调用上已经可用,但在复杂的多步推理、长链路规划上仍不够稳定。
更务实的结论是:
- 文案生成、字段抽取、SEO 描述改写这类任务,本地模型完全胜任,成本低且数据不出本机。
- 需要高可靠性的规划决策与复杂工具编排环节,本地小模型容易出现幻觉或调用错误,商用 API(如 GPT 系列、Claude)在生产管线中仍是更稳妥的选择。
换句话说,不必非此即彼。合理做法是混合架构:用商用 API 承担规划大脑,用本地模型处理高频、低风险、涉及隐私的批量文本任务,兼顾成本与稳定性。
反爬导航:Agent 架构中最脆弱的一环
卖家希望智能体能“不被检测地”浏览平台 listing。这恰恰是整个设想中技术风险最高、也最需要谨慎的部分。
现代电商平台的反爬系统会综合检测请求指纹、行为节奏、浏览器自动化特征等。用智能体直接驱动浏览器大规模抓取,不仅技术上不稳定,也可能触碰平台服务条款,带来账号风险。
更可持续的思路是:
- 优先使用官方 API 与目录数据。卖家自己已经提到商品规格和图片可由平台目录自动带入,说明合规的数据通道是存在的。
- 若必须抓取,采用成熟的浏览器自动化库(Playwright 配合反检测插件),但要控制频率、尊重 robots 规则。
- 把“导航抓取”与“数据处理”解耦——让智能体专注在拿到数据之后的清洗、结构化与文案生成,而不是把它当成绕过风控的工具。
现代反爬系统(如 Cloudflare Bot Management、PerimeterX)的检测维度已远超简单的 User-Agent 识别,涵盖 TLS 指纹、Canvas/WebGL 渲染特征、鼠标移动轨迹熵值、请求时序分布等数十个信号。即便使用 Playwright 配合 playwright-stealth 等反检测插件,也只能降低而非消除被识别的概率。更值得注意的是,平台服务条款(ToS)通常明确禁止自动化抓取,一旦触发封禁不仅丢失账号,历史销售数据与评价也可能一并消失。因此,把"导航抓取"定位为整个管线中需要人工或合规 API 优先承接的环节,而非智能体自主决策的领域,是降低整体系统风险的关键设计原则。
框架选型:单智能体还是多智能体?
卖家提出了一个关键的架构抉择:是上多智能体(multi-agent)系统,还是用单一模型配结构化工具调用加校验?
对于当前这个场景,答案倾向于后者。多智能体虽然概念时髦,但会显著增加编排复杂度、调试成本和出错面。对于“选品 → 抓数据 → 生成文案 → 推送草稿”这样流程相对线性的任务,一个带结构化工具调用和严格输出校验的单模型管线往往更干净、更可控,也更不容易产生幻觉。
在开源框架层面,可以关注以下几类:
工作流编排
- LangGraph:以图结构定义节点和状态流转,适合这种有明确步骤、需要条件分支和人工复核节点的管线。
- CrewAI / AutoGen:如果未来确实需要多角色协作再考虑,初期不必引入。
结构化输出与校验
- Pydantic + Instructor:强制模型输出符合 schema 的 JSON,是对抗幻觉、保证 listing 字段规范的核心手段。
- Outlines / Guidance:在本地模型上做约束解码,提升结构化输出可靠性。
Instructor 是对 OpenAI 及兼容 API 的轻量封装,它通过 Pydantic 模型定义期望的输出 schema,并在模型返回不合规结果时自动触发重试与修正,本质上是把"函数调用(function calling)"与"数据验证"两步合并成一个声明式接口。对于电商 listing 场景,这意味着可以预先定义包含标题字符数上限、必填属性列表、价格格式等约束的 Pydantic 模型,一旦模型输出违反规则,Instructor 会自动将错误信息回传给模型并请求修正,而不是让一条格式错误的草稿悄悄进入推送队列。Outlines 则在推理层面做约束解码(constrained decoding),直接限制本地模型每一步 token 的采样范围,从概率层面保证输出符合正则或 JSON schema,适合对延迟和准确率要求更高的本地模型场景。
Web 数据获取
- Playwright:浏览器自动化的主流选择。
- Firecrawl / Crawl4AI:专为“喂给 LLM 的干净网页数据”设计的开源工具,能把页面转成结构化、去噪的 Markdown 或 JSON,非常契合卖家“把结构化数据干净导出”的需求。
LangGraph 是 LangChain 团队推出的有状态智能体编排框架,其核心思想是把工作流建模为有向图:节点(node)代表一次 LLM 调用或工具执行,边(edge)代表状态流转条件。与线性链式调用相比,它天然支持循环、条件分支和"人工介入"检查点(interrupt),这对于需要在某个节点暂停等待人工审核的电商上架场景尤为合适。相比之下,CrewAI 和 AutoGen 侧重多智能体角色扮演与任务委派,其底层同样可以使用 LangGraph 作为执行引擎,但额外的协调开销在单一线性流程中往往得不偿失。
推荐架构:务实的渐进式方案
综合来看,与其一步到位做全自主智能体,不如采用渐进式升级:
- 保留现有脚本作为执行层,它已经能稳定推送草稿,没必要推倒重来。
- 用 LangGraph 搭建编排骨架,把人工复核保留为流程中的一个显式节点(human-in-the-loop),既安全又符合平台合规要求。
- 用 Instructor + Pydantic 约束所有 LLM 输出,确保标题、描述、字段严格匹配结构化模板。
- 数据抓取优先走官方 API/目录,必要时用 Crawl4AI 做补充,而非让智能体冒险绕过风控。
- 模型分层:本地 4070 Ti 跑文案批处理,复杂决策调用商用 API。
这样的方案在 12GB 显存的硬件约束下是现实可行的,也把平台封号、幻觉上架等风险降到最低。
写在最后
自主智能体在电商运营中确实有巨大想象空间,但对中小卖家而言,真正的价值不在于“全自动”,而在于把重复、低价值的环节交给可控的管线,同时在选品判断和合规复核这类高风险节点保留人工把关。先用结构化工具调用把流程跑稳,再逐步扩大自动化边界,是比盲目堆砌多智能体更明智的路径。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。