AI周报:顶级编程模型回归、谷歌Flash新检查点与视频生成竞争

顶级编程模型全球回归,安全机制同步升级
经过近三周的下线,Anthropic旗下旗舰编程模型(素材中称为"Cloud Fable 5")终于重新上线全球市场。此前,受美国政府临时出口管制影响,Anthropic被迫暂停了该模型的全球访问。随着管制正式解除,该模型已在Cloud AI、Cloud API、Cloud Code及Cloud Cowork等多个产品线恢复可用。
出口管制的地缘政治背景:美国政府对AI模型实施出口管制的底层逻辑,源于"两用技术"(dual-use technology)的监管传统——即同一技术既可用于民用又可转为军事用途。AI大模型因其在代码生成、蛋白质结构预测、自动化推理等领域的广泛能力,被视为潜在的战略敏感技术。BIS的管制框架沿用了冷战时期"瓦森纳协定"的出口控制思路,并在近年技术竞争升温背景下大幅扩容。2023年起,美国商务部工业与安全局(BIS)开始将部分先进AI模型纳入出口管制框架,理由是防止技术被用于军事或大规模杀伤性武器研发。这一机制与芯片出口管制(如限制向中国出售H100 GPU)形成配套体系,共同构成美国对AI技术传播的战略管控。对Anthropic这类公司而言,全球用户访问受限不仅是商业损失,也倒逼其加速构建合规框架,包括与政府合作的预发布测试机制和越狱信息共享协议。对Anthropic的临时管制虽已解除,但其背后折射出的"技术主权"与"全球化商业利益"之间日趋紧张的结构性矛盾,仍将持续塑造顶级AI实验室与政府的关系模式。
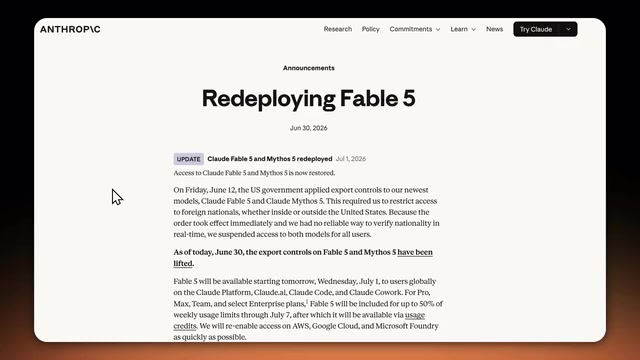
这次回归并非简单的"原样复活"。Anthropic借机引入了一整套新的网络安全分类器,用于检测和拦截危险请求。
网络安全分类器的技术原理:这类分类器是AI安全对齐工程的核心组件之一,属于"护栏系统"(guardrail system)的重要组成部分。其技术路线通常包括:基于大量有害/无害样本微调的二分类器、结合强化学习从人类反馈(RLHF)得到的偏好模型,以及规则引擎与神经网络的混合架构。训练数据通常来自红队(red teaming)攻击样本、人工标注的有害内容库,以及合成生成的对抗性案例。在架构层面,现代分类器往往采用"轻量级探针"叠加"主干模型内置拒绝机制"的双层设计:前者负责快速粗筛,后者在生成阶段进行精细判断。分类器的核心挑战在于精度与召回率的平衡——过于敏感会误拦截合法的安全研究或渗透测试请求(即误报),过于宽松则放行真正危险的查询(漏报)。值得注意的是,分类器本身也面临"对抗性提示"(adversarial prompt)的持续攻击,攻击者通过角色扮演、语义迂回、多语言混用等方式尝试绕过检测,这促使分类器训练进入"攻防军备竞赛"的持续循环。Anthropic坦承调优期间误报率偏高,将部分正常编程任务降级处理,正是这一工程现实的真实体现。
由于分类器仍在调优阶段,部分正常的编程和调试任务可能暂时回退至较低配置模型(Cloud Opus 4.8)处理,直到误报率进一步降低。
部署策略上也有明显调整:对于Pro、Max团队及部分企业用户,该模型在7月7日前将占用最多50%的每周使用额度,之后转向使用额度积分系统。Anthropic还宣布将与亚马逊、微软等合作伙伴共建行业共享框架,评估AI越狱风险,并加强与美国政府在预发布模型测试、越狱信息共享和AI安全研究方面的合作。
性能实测:质量领先,但成本是最大门槛
实际测试表明,该模型的编程能力并未因风波缩水。在HTML5物理引擎测试中,它在多个场景下全面超越GLM 5.2、GPT 5.5和Opus 4.8——代价是高昂的费用,约为Opus 4.8的六倍。
具体数据对比:构建三个独立canvas物理演示时,该模型使用约6.2万tokens,成本约3美元;GPT 5.5使用3.7万tokens,成本约1美元;Opus 4.8仅用2.2万tokens,成本0.5美元;GLM 5.2使用3.6万tokens,成本仅8美分。
理解Token经济与成本结构:Token是大语言模型处理文本的基本计量单位,大致对应英文中0.75个单词或中文1-2个汉字。模型的定价通常按输入token和输出token分别计算,顶级模型的输出token价格往往数倍于输入。顶级模型的高token单价,本质上反映了其推理阶段对高端GPU集群(如H100、B200)的巨量占用——一次复杂编程任务的推理,可能消耗数百GPU秒的算力资源。与此同时,中国团队(如GLM背后的智谱AI)通过混合精度训练、KV缓存复用、量化部署等工程优化手段,将单位token的推理成本压缩至极致,形成差异化竞争优势。上述成本差异(顶级模型约3美元 vs. GLM 5.2仅8美分)折射出当前市场的分层格局:这种成本鸿沟正在催生AI应用市场的"双轨制"——高价值、低频次的专业任务倾向选用顶级模型,而高频次、标准化的日常任务则快速向低成本模型迁移,"性价比"也因此正成为除能力之外最重要的模型选型维度。
从结果看,该模型在所有场景中均交出8分以上的成绩,包括逼真碰撞、正确物体物理和干净的破坏效果,无漂浮或穿模现象。GPT 5.5是最接近的竞争者,甚至在"怪物卡车"测试中略胜一筹。GLM 5.2虽未赢得任何单项,但以极低成本实现了不错的生成质量,性价比突出。
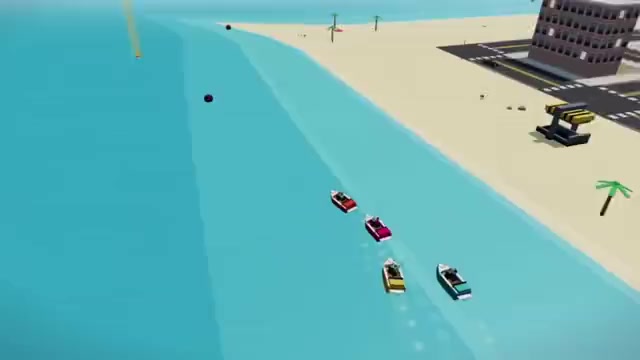
最令人印象深刻的演示,是有人挑战让该模型"重建GTA 6"。整个演示仅通过一条提示词生成——模型编写了全部游戏代码,并用程序化方式生成了每一个3D资产,没有任何外部模型或预制资源。这种"一条提示词生成完整交互场景"的能力,展现了当前顶级编程模型的惊人潜力。
谷歌新一代Gemini Flash检查点悄然测试
谷歌正在LM Arena上测试新的Gemini Flash检查点,早期反馈显示其表现明显优于当前版本。这一动作恰逢Gemini近期争议不断——多个检查点表现令人失望、研究人员陆续离开平台,新版本更像是谷歌的一次有力回应。
LM Arena的评测机制:LM Arena(前身为Chatbot Arena)是由加州大学伯克利分校团队开发的开放式AI模型评测平台,采用"盲测匹配"机制:用户在不知道模型身份的情况下与两个模型交互并投票,系统据此计算基于Elo评分的能力排名。Elo评分体系借鉴自国际象棋等竞技运动的排名算法,核心优势在于通过大量成对比较(pairwise comparison)积累统计显著性,规避了传统基准测试(如MMLU、HumanEval)被过度优化的"刷榜"问题。然而该机制也存在系统性偏差:用户群体以英语母语者和技术从业者为主,导致排名结果对非英语能力和非技术任务的代表性不足;此外,用户投票偏好本身可能受到模型"讨好倾向"(sycophancy)的影响——表达更流畅、态度更友好的模型往往获得更高票数,未必真实反映逻辑推理能力的强弱。科技公司在正式发布前将模型以匿名形式投入Arena测试,已成为行业惯例——一方面获取真实用户反馈,另一方面也是一种低调的市场预热策略。
关于命名,业界尚无定论。有人在模型标识中发现了"Gemini 4 Flash Preview"和"Gemini 3.6 Flash Preview"两种字样,最终可能以Gemini 3.6 Flash、Gemini 4 Flash或其他版本号发布。测试者普遍认为,这并非代际飞跃,而是一次扎实的增量升级,输出质量有可感知的提升。
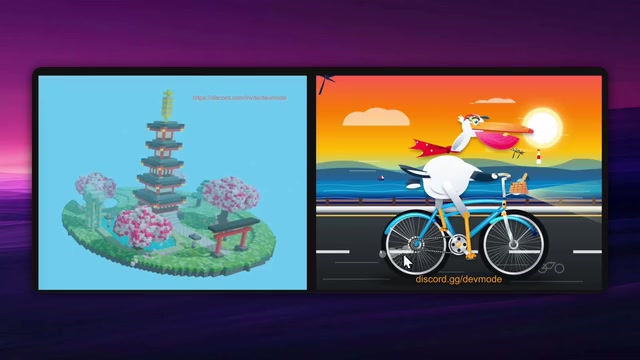
在SVG生成这一Gemini传统强项上,新检查点表现依旧出色:无论是"骑自行车的鹈鹕"(细节丰富到连轮胎烟雾都有体现),还是PS5、Xbox手柄的SVG生成,质量均远超一般Flash级别。体素艺术(voxel art)方面表现中规中矩,属于Flash变体的合理水平。
此外,谷歌DeepMind还额外发布了两款模型:Nanobanana 2 Lite(号称最快最便宜的Gemini图像模型,适合大规模日常图像生成)和Gemini Omni Flash(面向开发者的视频生成与编辑模型,已通过Gemini API和Google AI Studio开放)。
GPT-5.6 Codex上下文窗口引发关注
关于GPT-5.6在Codex中的表现,新报告指出其上下文窗口可能为37.2万tokens。这一信息来自openclause commit中被发现的模型配置,尚未获得OpenAI官方确认。
上下文窗口的技术意义与工程挑战:上下文窗口决定了模型在单次推理中能够"记住"和处理的信息量。从技术角度,窗口大小受限于Transformer架构中注意力机制的计算复杂度——标准自注意力的计算量与序列长度呈O(n²)增长,百万token级别的上下文需要巨大的显存和计算资源。为此,业界发展出多种优化方案:稀疏注意力、滑动窗口注意力(如Mistral采用的GQA),以及基于状态空间模型的替代架构(如Mamba)。然而即便在技术上支持超大上下文,大多数模型在实际处理中存在"迷失中间"(lost in the middle)现象——对上下文头尾信息的响应显著优于中间段,长程依赖的有效提取能力远弱于理论上限。为此,业界还发展出位置编码优化(如RoPE、ALiBi)和外部记忆增强(RAG,检索增强生成)等配套技术。37.2万token窗口约等于300页A4文档,虽远低于Gemini 1.5 Pro的100万token,但对绝大多数代码库分析任务已足够。用户期待与实际落地之间的落差,折射出商业部署中性能、成本与延迟三角约束的真实张力,具体情况仍需等待OpenAI官方说明。
视频生成赛道:速度与质量的权衡博弈
视频生成领域的竞争正在白热化。在一项头对头基准测试中,谷歌Gemini Omni Flash与SeaDance 2.0、Happy Horse 1.1和Veo 3.1进行了直接对比。
视频生成模型的技术架构演进:当前主流视频生成模型大多基于扩散变换器(Diffusion Transformer,DiT)架构,其核心是将视频帧序列编码为潜在空间(latent space)中的时空token序列,再通过迭代去噪过程还原高质量视频内容。相比早期基于U-Net的扩散模型,DiT在扩展性(scalability)上表现更优,参数量增加能带来接近线性的质量提升。Veo、SeaDance、Happy Horse等模型在此基础上引入了光流估计、物理先验约束和多模态条件注入等机制,以提升场景逻辑一致性。视频生成面临的根本挑战在于"时序一致性"与"物理合理性"的协同保障——前者要求相邻帧在外观上保持连贯,后者要求场景中的物体运动遵循基本物理规律。当前业界正在探索将物理仿真引擎的约束信号注入扩散过程,以及通过世界模型(world model)预训练提升模型对因果关系的内在理解。Omni Flash在"无人机撞电线杆"场景中的失败,恰恰暴露了轻量化Flash模型在物理常识推理上的短板——这类能力需要大量参数存储物理世界的隐式模型,与追求速度和低成本的Flash定位存在根本性取舍。
结果印证了"Flash"的定位:Omni Flash生成一段10秒视频仅需31秒,成本约1.32美元,是最快最便宜的选项。但质量也是最弱的——在"无人机穿越火车驶向纽约"的场景中,无人机会直接撞上电线杆,场景逻辑处理能力明显不足。相比之下,SeaDance 2.0画面最干净,Happy Horse对提示词理解到位,Veo 3.1整体最自然。
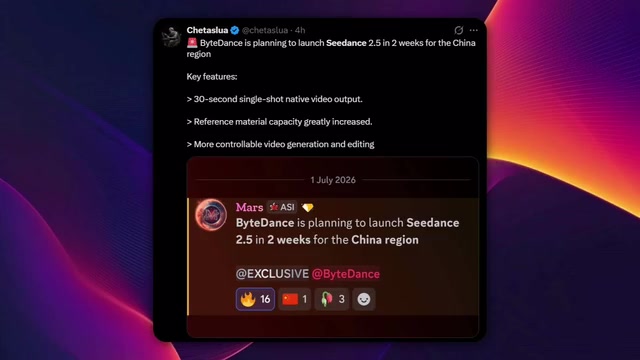
在SeaDance方面,字节跳动据报道将在两周内于中国市场推出SeaDance 2.5,预计带来30秒单镜头原生视频生成、更高的参考素材容量,以及更可控的视频生成与编辑能力。30秒单镜头原生生成是当前技术瓶颈之一——更长时序意味着模型需要在更大的时间跨度内维持全局一致性,对架构和训练策略都提出了更高要求。更长的单镜头输出和更强的可控性,正是当前视频生成模型最需要突破的方向,若属实将是SeaDance的一次重大飞跃。
其他值得关注的AI动态
除上述重磅更新,本周还有几个值得留意的进展:
- ZAI(GLM系列背后的团队) 推出新IDE工具,支持长时间自主编程工作流和带验证的编程任务,可在Linux、Windows和macOS上使用。
- 马斯克的xAI 发布Voice Agent Builder,这是一个基于Grok Voice的无代码语音代理构建平台,定价每分钟5美分,让开发者和企业无需从零编写代码即可构建类人语音代理。
- Figure AI机器人 或许是本周最具产业意义的信号。Figure 03据报道正被部署到宝马工厂,用于真实的物流和制造任务——这意味着Figure不再只是展示Demo,而是真正进入实际生产环境处理重复性体力劳动。
具身智能的产业化路径:具身智能(Embodied AI)指能够在物理世界中感知、推理并执行动作的智能系统,是AI从"数字世界"向"物理世界"延伸的关键跨越。具身智能的产业化进程正在经历从"实验室演示"到"受控场景部署"再到"开放环境泛化"的三阶段跃迁。工厂制造场景之所以成为首选落地点,是因为其具备三大有利条件:环境相对封闭(减少开放世界的不确定性)、任务高度结构化(便于策略训练与迁移)、失败成本可控(工人与机器人协作模式下安全风险可管理)。Figure AI的技术路线通常包含三个层次:底层运动控制(基于强化学习的步态与抓取策略)、中层任务规划(视觉语言模型驱动的场景理解与指令分解)和上层人机交互(自然语言指令接收与反馈),其技术栈整合了大模型推理能力与自研的机器人运动控制系统,代表了"大模型赋能机器人"这一新范式的典型实践。与此对比,传统工业机器人(如ABB、KUKA)依赖预编程轨迹,缺乏环境适应能力;波士顿动力等前辈也长期停留在Demo展示阶段,而Figure选择以"有限场景、真实部署"换取商业验证,其估值的快速跃升,正是资本市场对这一策略的高度认可。
小结
本周的密集更新再次印证了AI行业的迭代速度。从顶级编程模型的回归与安全机制升级,到谷歌Flash模型的低调测试,再到视频生成赛道"速度"与"质量"的权衡博弈,每个方向都在快速演进。Figure AI进入真实工厂的消息,则预示着具身智能正从演示走向落地。随着更多新模型即将登场,接下来的一段时间将持续热闹。
相关推荐

AI+SRC自动化挖洞实战:用AI智能体重构漏洞挖掘三步法
本文详解AI+SRC自动化漏洞挖掘的完整思路,对比传统挖洞三步法与AI智能体加持后的变化,涵盖资产盘点、误报筛选、报告生成及AI Agent选型要点,助你高效入门SRC漏洞挖掘。

实测DeepSeek桌面Agent:0.35美元自动生成视频
海外博主实测DeepSeek桌面Agent(DeepSeek Harness):仅0.35美元自动生成完整视频,设置每日自动简报,两分钟从大白话构建可运行App。三项任务全部完成仅花0.59美元,附详细表现与成本分析。

Antigravity 2.0 保姆级教程:MCP、Skill与自动化全解析
Antigravity 2.0 保姆级教程,详解项目/会话/Agent 三大核心概念、消息队列与权限设置、自动化任务、MCP 连接 Figma、Skill 专业技能,并演示设计稿转代码、Android 应用生成、产品页 1:1 复刻等 6 个实战案例。