本周AI大事:Claude取消限额、GPT-6.1、千问入苹果

本周AI头部玩家从模型竞速转向任务成本、系统入口与生态卡位的综合竞争。
过去一周,OpenAI、谷歌、Anthropic和阿里密集发布更新。OpenAI推出主打电脑操作的GPT-6.1 Terra,宣称同任务成本约为Opus 5.5的九分之一,并披露三项科研成果待外部核查。谷歌两周内连发Gemini 4 Argon和Carbon,后者以59分登顶智能榜,同时首次将TPU送上卫星跑通推理。Anthropic将Claude Max 20X更名为Ultra并取消5小时限额,OpenAI随即把Codex Pro和企业高级版用量上限翻倍。阿里千问接入苹果智能,计划11月4日开发者测试、12月正式推送。开源与硬件侧,MiniMax H3 Flex把采样压缩到6步,智源发布Go3和灵取OS。Anthropic还披露研究模型在五大平台发现漏洞并串成5条可执行攻击链。整体看,竞争焦点正转向任务执行成本、系统级入口和开发者配额。
本周AI速览:从模型竞速到生态卡位
过去一周,AI 领域的节奏明显加快。OpenAI、谷歌、Anthropic 和阿里接连放出重要更新,覆盖模型能力、产品定价、终端入口和太空计算等多个维度。据 B 站 UP 主的梳理,这些变化并非孤立事件,而是指向同一个趋势:头部玩家正在从单纯的模型比拼,转向任务执行、生态绑定和成本控制的综合竞争。
OpenAI:GPT-6.1 Terra 主打电脑操作,科研能力同步曝光
OpenAI 本周发布了 GPT-6.1 Terra,核心卖点是帮助用户操作电脑。官方给出的说法是,完成同样的任务,成本大约只有 Opus 5.5 的九分之一。这个成本差距如果属实,意味着在自动化办公、浏览器操作等场景里,模型调用的经济性会有数量级的改善。
OpenAI 总裁 Greg Brockman 表示,他本人用这个模型操作电脑已经比他亲自操作还快。这个表态带有一定的宣传色彩,但也侧面说明模型在任务链执行上的流畅度有提升。
除了产品层面的更新,OpenAI 还披露自家模型本周交出了三项科研成果,其中一项证明了一个困扰数学家几十年的猜想,并顺带解决了著名的挂谷猜想。目前 OpenAI 已请外部专家进行核查。科研能力是模型深度推理能力的一种体现,但外部验证尚未完成,结论仍需谨慎看待。
模型“操作电脑”属于计算机使用代理(Computer Use Agent)方向:模型通过截图理解界面,再生成鼠标点击、键盘输入等动作,在浏览器或桌面应用中完成多步任务。相比传统的API调用,这类任务对视觉定位、状态跟踪和错误恢复要求更高,也更容易因一步出错而连锁失败。因此评价这类模型不能只看单步准确率,还要看长任务链的完成率和成本。文中提到的“成本只有九分之一”,通常指在相同任务完成率下的单次任务推理开销,而非单纯的token单价;实际经济性会随任务复杂度、重试次数和人工接管率而波动。
谷歌:Gemini 4 连发两版,TPU 上太空
谷歌在两周内连发两个模型,先是 Gemini 4 Argon,本周又推出 Gemini 4 Carbon。据 UP 主引用 Artificial Analysis 的智能榜数据,Gemini 4 Carbon 直接以 59 分登顶。在找漏洞的测试中,它拿到了 88.2% 的成绩。不过普通用户暂时还用不上,谷歌先面向网络安全团队分批开放,这说明该模型的能力方向更偏向安全研究与高风险场景。
更引人注意的是硬件层面的动作。谷歌把 TPU 送上了卫星,第一次在太空跑通了模型推理,地面收到的第一条回复是一首诗。太空计算目前更多是技术验证性质,但它为未来在轨数据处理和低延迟推理提供了一个可参考的样本。
TPU(张量处理单元)是谷歌自研的专用AI加速芯片,主要用于矩阵运算密集的模型训练与推理。把TPU送上卫星并跑通推理,技术难点不在算力本身,而在太空环境的辐射、散热、供电和远程运维:宇宙射线可能造成比特翻转,卫星的功耗与散热预算又极其有限。在轨推理的价值在于减少原始数据下传的带宽压力和时延,例如遥感图像可以先在卫星上完成筛选或初步识别,只回传关键结果。不过目前这仍属验证性质,离规模化在轨计算中心还有距离。
Anthropic 与 OpenAI 的额度博弈
Anthropic 把 Claude 的 Max 20X 套餐改名为 Ultra,价格保持不变,同时直接取消了 Ultra 用户的 5 小时限额。对于高频使用 Claude 的开发者来说,这是实打实的体验改善,长时间会话不再被窗口打断。
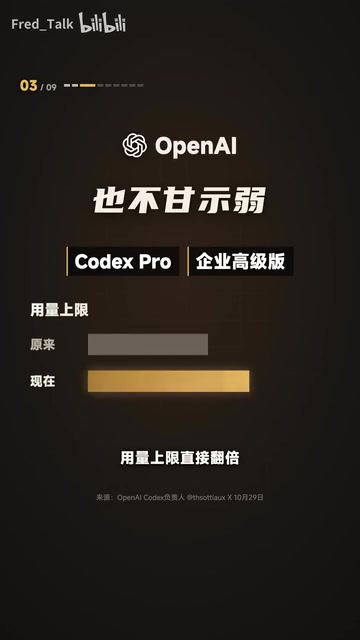
OpenAI 随即做出回应,Codex 的 Pro 和企业高级版用量上限直接翻倍。两家在编程辅助工具上的竞争已经从模型能力延伸到配额政策,用户是这一轮博弈的直接受益者。
千问接入苹果智能,国内模型进入系统级入口
阿里宣布千问接入苹果智能,Siri、写作工具和视觉智能都能调用千问。按照规划,11 月 4 日先上开发者测试版,12 月正式推送。
这一步的意义不在于模型参数,而在于入口。系统级集成意味着千问可以在用户不主动打开独立应用的情况下被调用,触达范围和使用频次都会显著扩大。对国内大模型厂商来说,这是生态卡位的关键一战。
开源与硬件:MiniMax、智源、谷歌各有动作
开源侧,皮卡在 MiniMax H3 上继续训练,开源了 H3 Flex 采样,把采样步数从 50 步压缩到 6 步。官方表示,一条 15 秒带配乐的视频最快 7 秒就能生成。视频生成的速度瓶颈正在被逐步压缩,这对内容生产工作流的影响很直接。
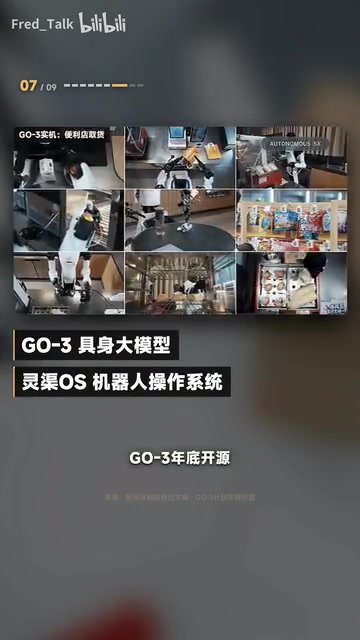
智源在创新日发布了巨声大模型 Go3 和机器人操作系统灵取 OS,Go3 计划年底开源。机器人操作系统的发布,说明国内机构在具身智能的基础软件层也开始布局。
Anthropic 的安全研究:五条可执行攻击链
Anthropic 披露,内部一个 Claude 研究模型在 Chrome、Safari、Android、Windows 和 Linux 中都找到了漏洞,并串联成 5 条真正能跑通的攻击链。相关漏洞均已修复。
这条信息的价值在于,它展示了模型在安全审计场景中的实际产出能力。漏洞挖掘从辅助提示走向可执行攻击链的构建,说明模型对复杂系统的理解深度在提升,同时也提醒防守方需要加快响应节奏。
“可执行攻击链”指把多个独立漏洞按利用顺序串联起来,形成从初始入口到最终控制或数据窃取的完整路径。单个漏洞可能只造成信息泄露或权限提升,但组合后可以突破沙箱、绕过缓解机制,危害显著放大。这类工作通常遵循“发现—验证—修复—披露”的负责任披露流程,厂商在补丁发布后才会公开细节。模型能自主完成漏洞发现并构建攻击链,说明其在代码审计和系统推理上具备实用价值,但也带来双用途风险:同样的能力可能被用于攻击。因此行业普遍强调访问控制、使用审计和模型行为监控。
本周观察
把上述事件放在一起看,几条主线比较清晰。模型能力仍在快速迭代,但竞争的焦点正在转向任务执行成本、系统级入口和开发者配额。OpenAI 用成本优势切入电脑操作,谷歌用安全场景和太空计算做差异化验证,Anthropic 用取消限额巩固开发者粘性,阿里则借助苹果生态扩大触达。下周值得关注的是千问开发者测试版的实际表现,以及 OpenAI 科研成果的外部核查进展。
相关推荐

AI能直接读懂神经网络权重:模型能力已超出预期?
Reddit开发者实验显示,语言模型能直接阅读神经网络权重并推断其功能。Astra、Opus 5.5和Muse Spark 1.3均通过测试,引发对模型泛化能力与训练来源的讨论。

印度微短剧市场爆发:EloElo获NBCUniversal 8000万美元投资
印度社交娱乐平台EloElo获NBCUniversal 8000万美元投资,加码微短剧平台StoryTV。StoryTV月活超3300万,印度微短剧市场正吸引全球资本关注。

多旋翼无人机声学检测:融合手工特征与预训练嵌入
研究揭示无人机声学检测中随机划分导致数据泄漏,提出源不相交评估协议下融合手工声学特征与YAMNet嵌入的堆叠集成方法,准确率达95.29%,为低成本无人机探测提供可靠基准。