Benchpress:别信OCR榜单,用自己的文档实测
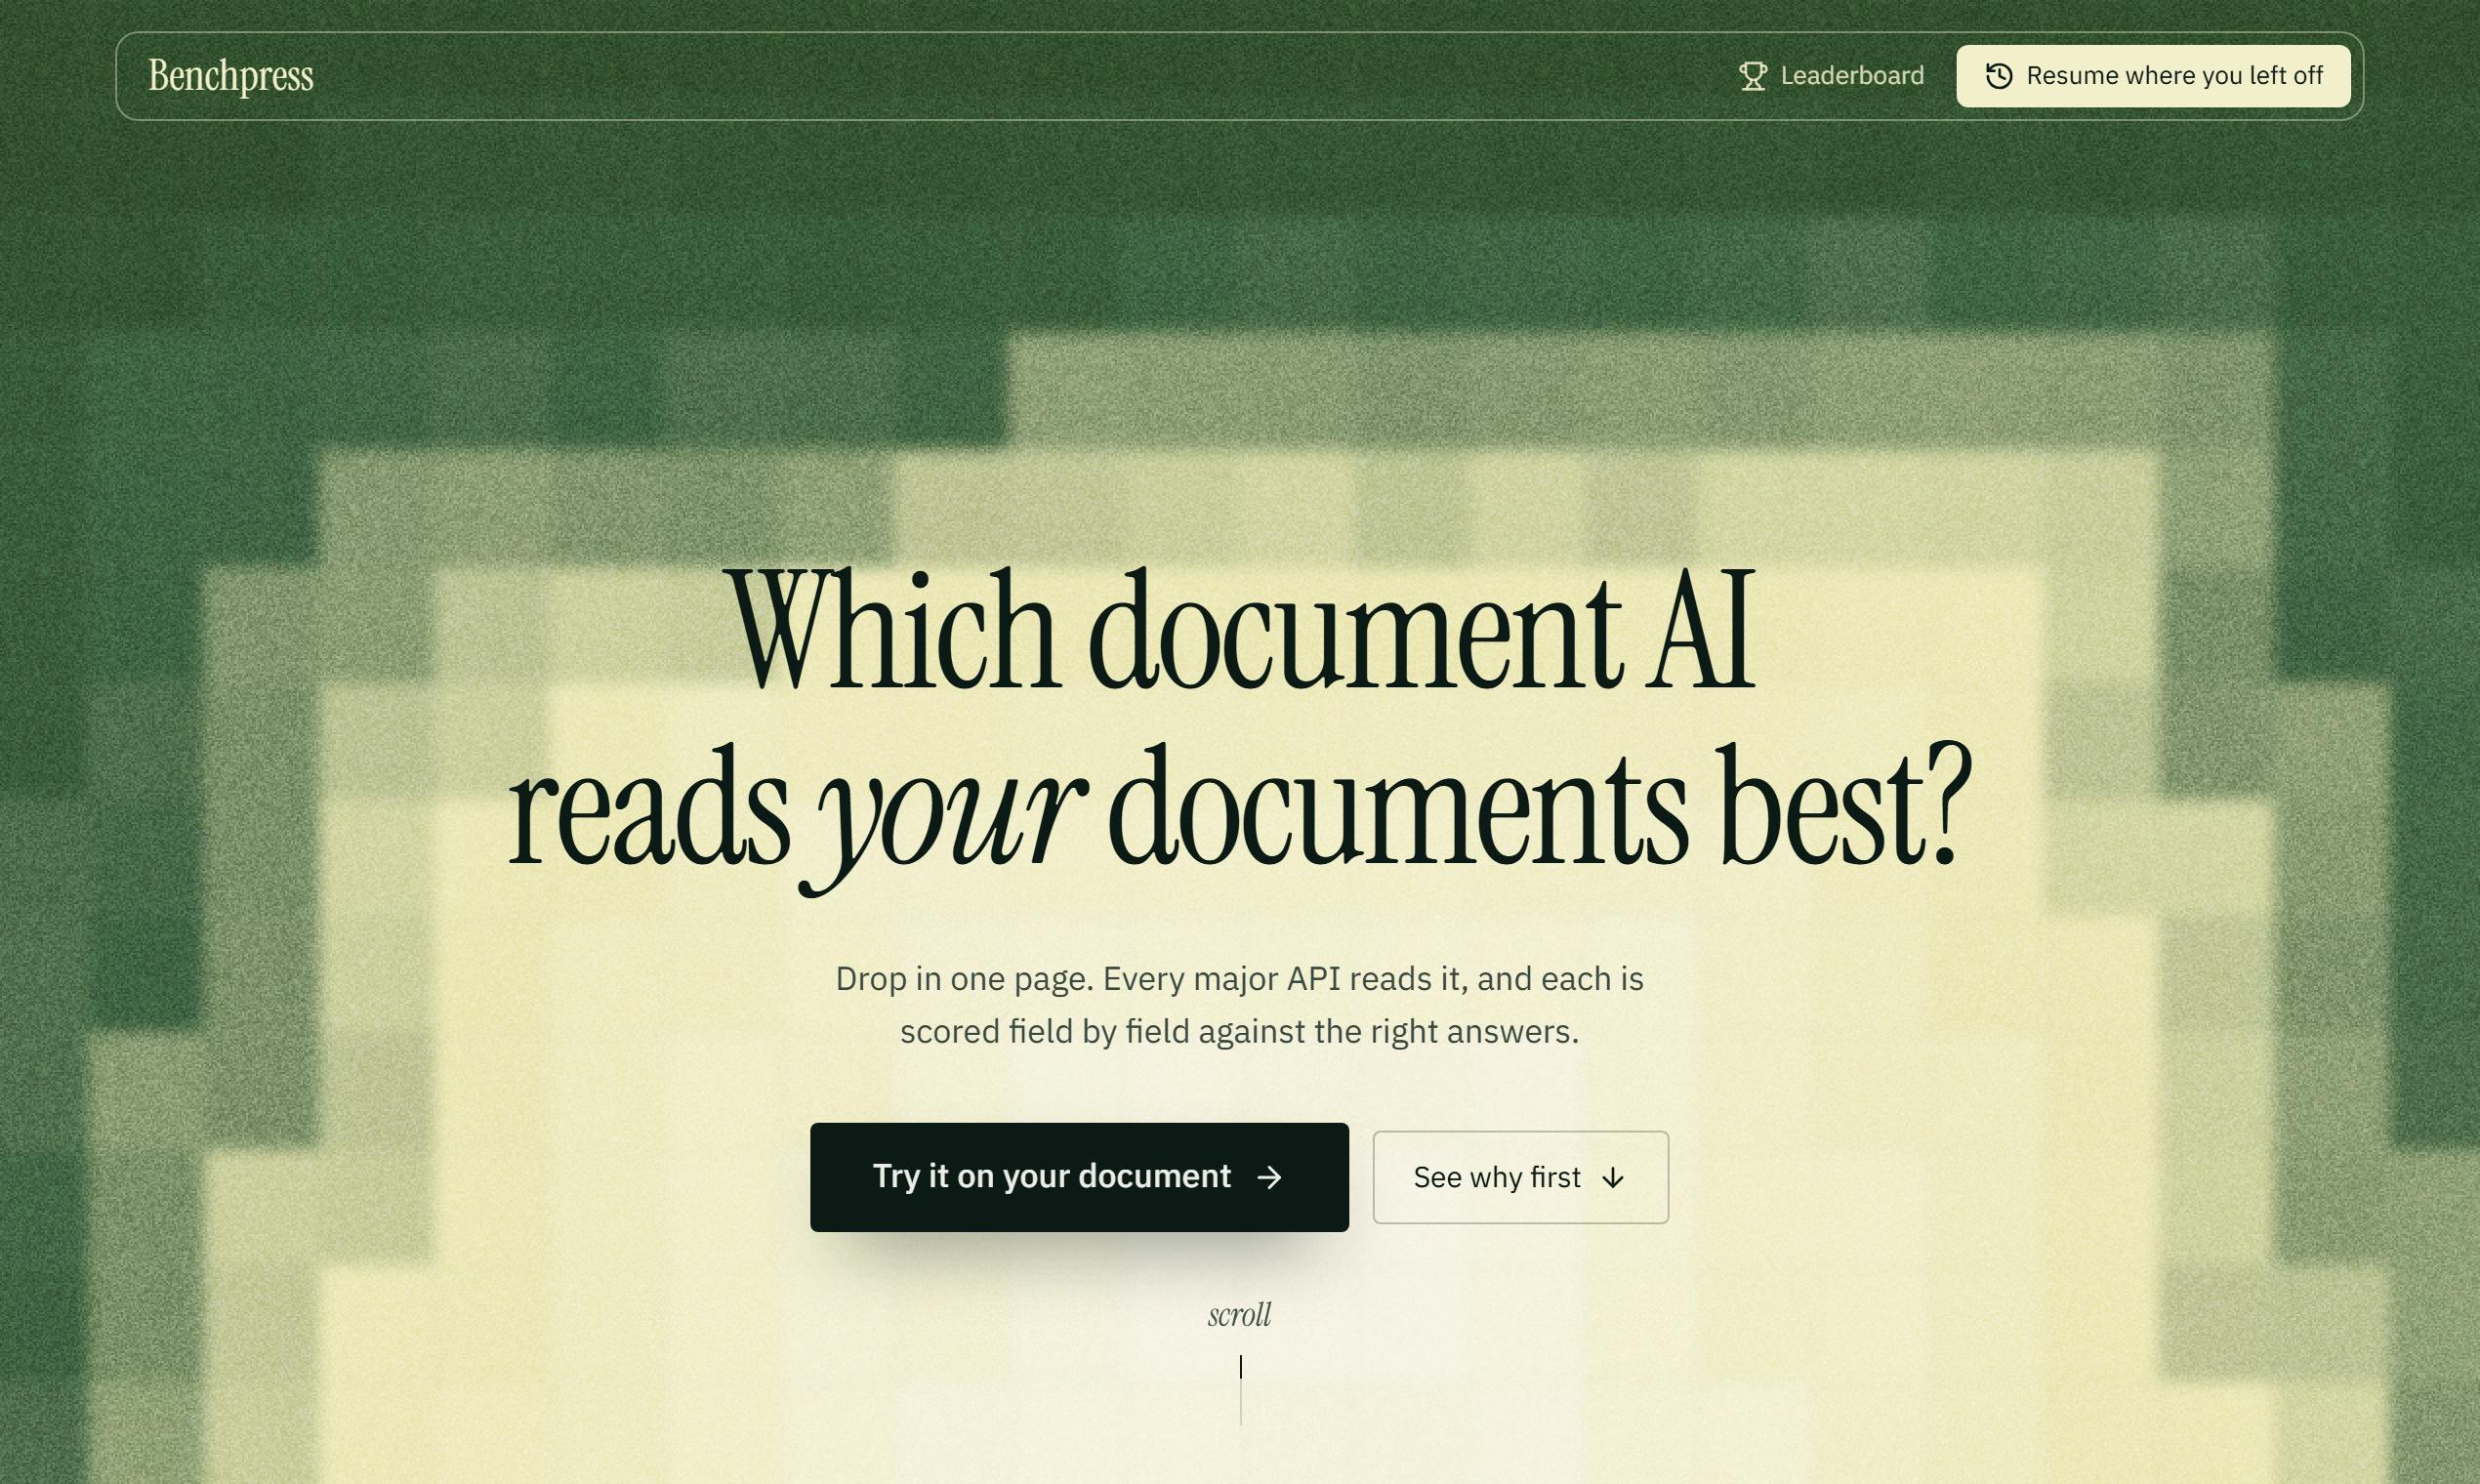
Benchpress 让用户用自己的一页文档横向实测各家 OCR 与文档 AI 模型。
文章介绍了 Product Hunt 上的新产品 Benchpress,它针对 OCR 榜单失真问题,允许用户上传一页自己的文档,同时跑遍主流 OCR 和文档 AI 模型,直观对比谁读对了、在哪里出错。文章指出,学术基准的数据分布与真实业务文档差异巨大,厂商还可以选择性公布自己领先的榜单,导致“榜单第一”的参考价值下降。Benchpress 把横向对比的门槛降到接近零,并提供速度和成本两个工程选型维度,贴合开发者的实际决策需求。不过其单页测试样本量有限,适合作为初筛工具,最终选型仍需更大规模验证。
OCR 模型的营销话术越来越统一:各家都在某个榜单上拿了第一。但当你把自家扫描件、发票或手写笔记丢进去,结果往往和宣传页上的数字对不上。Product Hunt 上出现的 Benchpress 试图解决这个问题——它让你用自己的一页文档,同时跑遍主流 OCR 和文档 AI 模型,看谁真的读对了。
榜单第一的含金量正在下降
Benchpress 的 slogan 说得很直白:"Every OCR model is #1 somewhere." 这句话背后是 OCR 评测长期存在的一个结构性问题。学术基准通常由特定类型的数据集构成,比如干净排版的英文扫描件,模型在这些数据上刷分容易,但真实业务里的文档千奇百怪——表格线倾斜、印章遮挡、中英混排、手写批注,这些场景的表现很难从公开榜单上看出来。
更微妙的是,厂商可以选择性地只公布自己领先的基准。一个模型在某个子任务上排第一,并不代表它在你的发票识别任务上同样可靠。Benchpress 的切入点就是把评测权从厂商手里拿回来,交给用户自己的文档。
OCR 领域的公开评测基准有很多,比较常见的有 FunSD(表单理解数据集)、CORD(印尼收据数据集)、SROIE(扫描收据信息抽取)以及中文场景下的 ICDAR 系列竞赛数据。这些基准的共同特点是数据分布相对固定、标注质量可控,因此适合做模型间的横向比较,但它们与真实业务文档之间的分布差异(domain shift)往往很大。模型在基准上刷到 SOTA,只能说明它拟合了那类数据的统计特征,并不保证在印章、水印、低分辨率拍照件或中英混排表格上同样稳健。这也是为什么业内一直有“benchmark 饱和”的说法——当头部模型的分数差距缩小到 1% 以内时,榜单的区分度已经接近噪声水平,厂商转而通过选择子集、选择指标来制造“第一”。
一页文档,跑遍所有模型
根据 Benchpress 的产品描述,使用流程被压缩到了极简:上传一页文档,所有主流 OCR 和文档 AI 都会读取这一页。随后你可以看到每个模型的识别结果,直观对比谁读对了、谁在哪里出错。
这个设计的价值在于把"横向对比"的门槛降到了接近零。传统做法是分别注册各家 API、写脚本调用、自己设计评测指标,光是准备工作就要花掉半天。Benchpress 把这一串流程打包成一次上传,让开发者可以快速判断某个模型是否值得接入自己的流水线。
产品还额外提供了两个维度:速度和成本。OCR 选型从来不只是准确率问题,一张发票识别准确率 99% 但单页成本是竞品三倍的模型,在批量场景下未必划算。Benchpress 把 fastest 和 cheapest 单独列出来,贴合了实际工程决策的关注点。
理解 Benchpress 的定位,需要区分 OCR 与文档 AI 这两类模型的能力边界。传统 OCR 主要解决“把图像中的文字转成字符”的问题,输出的是带坐标的文本行;而文档 AI(document AI)通常在此之上做版面分析、表格结构还原、关键字段抽取,输出结构化 JSON。二者的评测指标也不同:OCR 常用字符错误率(CER)和词错误率(WER),文档 AI 则更关注字段级准确率和表格还原的 TEDS 分数。Benchpress 把两类模型放在同一页文档上对比,实际上是在做端到端的“可读性”比较,这对需要直接消费结构化结果的业务场景更有参考价值,但也意味着不同类型的模型在同一维度上比拼时,需要留意它们输出的形态是否可比。
对开发者意味着什么
Benchpress 被归类在 Developer Tools 和 Artificial Intelligence 下,定位很清晰:它不是给终端用户用的扫描工具,而是给需要做技术选型的工程师准备的测试台。
这类工具的出现,反映出一个更广泛的趋势——文档 AI 的竞争已经从"能不能识别"进入"在你的场景里识别得怎么样"的阶段。随着模型数量增多,选型成本本身成了痛点。一个能快速做 A/B 测试的轻量工具,可能比又一个准确率高 0.5% 的模型更有实用价值。
当然,一页文档的测试样本量有限,无法覆盖长文档、复杂版式或特定行业的术语。把它当作初筛工具是合理的,用来做最终决策还需要更大规模的验证。Benchpress 目前只有 5 个投票和 2 条评论,产品仍处于早期,是否支持批量测试、结果导出或自定义评测指标,从现有信息中看不出来。
在工程实践中,OCR 选型通常还要考虑榜单数字之外的几个因素:一是延迟分布而非平均值,批量流水线更在意 P95/P99 尾延迟;二是并发与限流策略,很多 API 在免费额度下 QPS 很低;三是数据合规,发票、身份证等敏感文档能否上传到第三方服务往往受行业监管约束;四是模型的私有化部署能力。这些维度很难被一个轻量对比工具覆盖,Benchpress 提供的速度和成本信息更接近“公开定价下的粗略参考”,实际成本还要把重试、失败率和后处理人工成本算进去。
小结
OCR 选型的老办法是看论文、看榜单、然后祈祷。Benchpress 提供的替代方案很朴素:用你自己的文档说话。对于正在为文档处理流水线挑模型的开发者,这是一个值得放进工具箱的小工具,前提是对它的测试范围有清醒预期。
相关推荐
Cursor AI实战:用AI IDE加速编程的效率与成本权衡
深入解析 Cursor AI IDE 的界面布局、Agent/Plan/Debug/Ask 四种模式、模型选择与 Git 上下文集成,并结合实操演示讨论其订阅成本与直连 Claude 的性价比权衡。
免费落地页设计规则库:Claude Code与Cursor实测指南
Claude Code 与 Cursor 可用的免费落地页设计技能 Landing Page Design 介绍:MIT 协议、近 9000 星,先问 offer/受众/行动再规划 12 区块,字体与间距均为硬约束,配套 Redesign 技能改造存量页面,附动效技能下架与星数不代表质量的提醒。
Cursor总写错代码?问题可能出在上下文而非提示词
Cursor反复写错代码,问题可能不在提示词而在上下文。本文解析如何通过补充相关文件、完整报错与预期结果,配合先计划、小步改、跑测试的流程,减少AI编程错误,同时提醒代码审查仍是开发者的责任。