闭源贵7.8倍:美国科技巨头集体倒向中国开源AI

美国企业正大规模将AI工作负载从闭源模型切向开源模型,八个月内开源份额从7%升至56%,成本差距达7.8倍是核心驱动力。
根据金融时报、CNBC及AI网关平台的数据,美国企业正在经历一场真实发生的AI成本迁移:某网关上开源模型Token占比八个月从7%飙升至56%,OpenRouter上中国开源模型单周份额达57%-67%。驱动力首先是价格——闭源模型均价是开源的7.8倍,Tinder的AI账单半年从100万美元涨至1000万美元就是缩影。AT&T、PNC、西门子等巨头已将四成乃至更多工作负载切向开源,数据安全是另一硬性动机。企业普遍采用"开源微调+按敏感度混合路由"的成熟架构。供给端,DeepSeek、通义、智谱等中国公司领跑开源权重市场,尤其在编程等智能体任务上已具竞争力。这场迁移正在重演云计算替代自建机房的历史逻辑,而价格战才刚刚开打。
一场发生在生产环境里的迁移,正在改写AI的成本格局。这不再是开发者社区的口号,而是被写进美国企业财报会议的现实。根据金融时报、CNBC以及Fireworks(原文称"Verso")官方的第一手数据,一组可核验的数字勾勒出了美国企业的集体转向。
四个数字,说明一场真金白银的切换
第一个数字来自AI网关平台的统计:某网关上,开源模型贡献的Token占比已达56%,而此前该数字仅为7%,八个月翻了八倍。第二个数字来自OpenRouter——在9月中旬那一周,中国开源模型占据了57%到67%的用量。第三个数字最直接:同样一个Token,闭源模型的平均单价大约是开源模型的7.8倍。第四个数字来自交友应用Tinder,其AI账单在半年内从每年100万美元飙升至每年1000万美元。
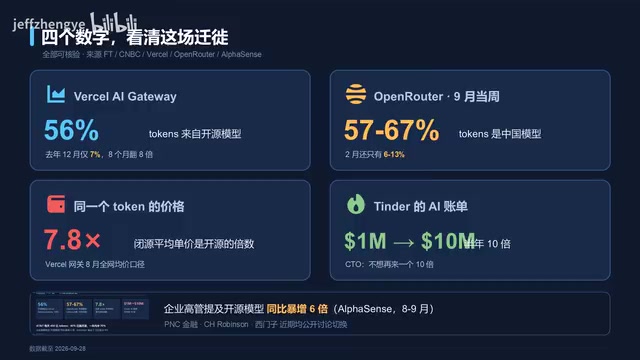
需要强调的是,OpenRouter的数据覆盖美国、欧洲以及82个发展中国家,美国企业贡献了全网约一半的用量。也就是说,这并非"中国用户在用中国模型"的地域现象,而是全球生产环境中的真实替换。企业高管在公开场合提及开源模型的次数,同比暴增了六倍——口头认可正在变成实际的调用量。
为什么切换?核心就一个字:贵
驱动这场迁移的首要动力是成本。同一个Token,闭源模型的均价是开源的7.8倍,这个差距在规模化调用下会被急剧放大。
Tinder的首席技术官把话说得很直白:1月份账单还是每年100万美元的量级,7月份已经爬到了每年1000万。他的判断更值得玩味——前沿模型的智能对九成的任务而言"已经够了",一旦开源模型在这些任务上追平,他可能就不再需要闭源模型。
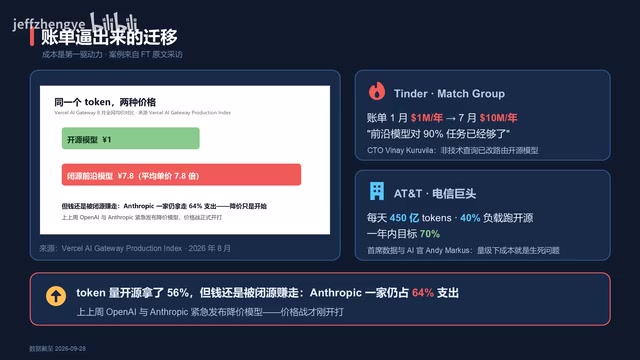
电信巨头AT&T的做法更激进。它每天处理约450亿个Token,目前已将四成工作负载切到开源模型,并计划在一年内冲到七成。不过有个耐人寻味的反差:虽然开源在用量上拿下了半壁江山,钱却仍被闭源厂商赚走——Anthropic一家就占据了64%的支出。正因如此,OpenAI和Anthropic在同一周紧急发布了降价模型,价格战才刚刚开打。
谁在切换?动机不止省钱
真金白银在做迁移的企业名单很有分量:电信的AT&T、金融的PNC、物流的C.H. Robinson、工业的西门子、数据中心运营商Digital Realty。
除了成本,数据安全是另一个硬性动机。Digital Realty的架构负责人说了一句很重的话:客户数据永远不进闭源前沿模型。他们已经用开源模型自建了内部对话界面,按任务的敏感程度混合调用两类模型。
切换的技术路径也已相当成熟:拿开源模型,用自有数据做微调,在特定任务上表现能追平甚至超过闭源模型,而成本只要一个零头。这套"开源微调+按敏感度混合路由"的打法,正在成为企业的标准配置。
"开源微调+按敏感度混合路由"这套打法的技术逻辑值得展开。微调(Fine-tuning)是指在一个已训练好的大模型基础上,用企业自有的领域数据进行二次训练,使其在特定任务上的表现显著优于通用版本,同时所需计算资源远低于从头训练。混合路由则是在应用层设置一个调度层,根据请求的类型、数据敏感程度或所需智能水平,自动决定将请求发送至本地开源模型还是云端闭源模型——敏感的客户数据走本地开源模型,需要最强推理能力的复杂任务才调用闭源前沿模型。这套架构使企业得以在合规、成本与能力之间找到动态平衡,而非非此即彼地选边站队。
一个月内,数据、政策与定调全部就位
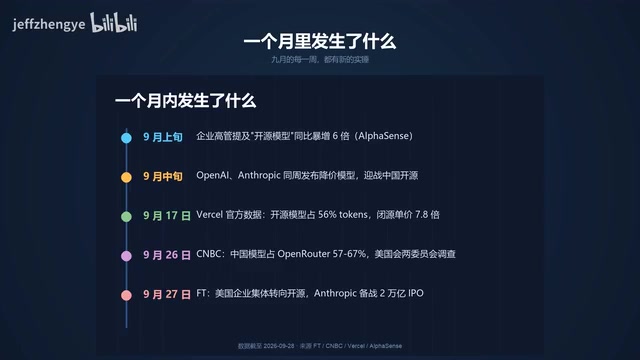
把9月的时间线连起来看,节奏快得惊人。9月上旬,企业高管提及开源模型的次数同比暴增六倍;9月中旬,OpenAI和Anthropic在同一周发布降价模型迎战中国开源;9月17日,AI网关官方数据显示开源占到56%的Token;9月26日,CNBC报道中国模型在OpenRouter上的份额,美国国会两个委员会随即开始调查;9月27日,金融时报发文定调"美国企业集体转向"。从数据、政策到舆论定调,一个月内全部齐备。
供给端:中国公司领跑开源权重市场
在开源权重大模型这一赛道,目前是中国公司领跑,主力包括DeepSeek广告、智谱、阿里通义(原文"阿里昆")三家,法国的Mistral和英伟达也在同一条赛道上。
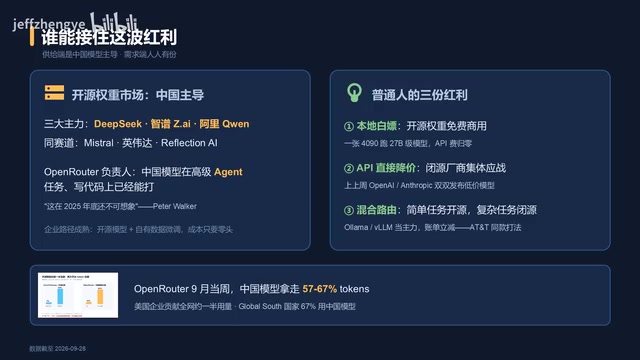
OpenRouter的洞察负责人评价,中国模型在高级智能体任务上、尤其是写代码方面已经"能打",而这在不久前还是不可想象的。这也解释了为什么企业敢于把编程等关键任务交给开源模型。
所谓"开源权重模型",指的是模型训练完成后,开发者将神经网络的参数权重(即模型"学到"的所有知识的数字化表示)以开放许可证的形式公开发布。与仅开放代码的传统开源软件不同,权重的公开意味着任何人都可以下载完整模型、在自有硬件上运行,也可以用私有数据进行微调,而全程无需向原始开发者支付调用费用。DeepSeek-R1、Qwen(通义)系列等模型均采用这一形式发布,这是它们能够被企业自部署并实现"接口费归零"的技术前提。与之对比,OpenAI的GPT系列和Anthropic的Claude系列仅提供API调用,用户无法获取权重,也无法在自有基础设施上独立运行,数据必须经由对方服务器处理——这正是Digital Realty等数据安全敏感企业选择开源路线的根本原因。
普通人能吃到哪些红利?
这场迁移和每个用AI的人的钱包都有关,普通人至少能拿到三份红利。
本地部署:开源权重免费商用,一张4090显卡就能跑起270亿参数级别的模型,接口费直接归零。
降价红利:闭源厂商集体降价,同样的预算能干更多的活。
混合路由:简单任务走开源、复杂任务走闭源,正是AT&T的同款打法,兼顾成本与能力。
结语:云计算的老剧本正在重演
八个月里,开源模型吃掉了网关一半的流量;闭源的价格是开源的7.8倍;美国巨头从口头认可变成了财报会议上的正式话题。AI的成本曲线,正在重演当年云计算替代自建机房的那套逻辑——而价格战才刚刚拉开序幕。
(本文数据截至2026年9月28日,来源:金融时报、CNBC及AI网关官方。部分企业与平台名称因原始素材音译存在不确定性。)
文章将这场迁移类比于云计算替代自建机房的历史进程,这一类比有其具体所指。2006年至2015年间,企业IT基础设施经历了从"自购服务器、自建机房"到"按需租用AWS/Azure/GCP算力"的大规模转移,核心驱动力同样是成本曲线的断崖式下降与技术能力的成熟化。而当前AI领域正在发生的,是这一逻辑的镜像:彼时是从高固定成本的自建转向灵活的云端,此时则是从高单价的闭源API转向可自部署的开源权重——两次迁移都在"够用即可"的性能门槛被跨越后加速。值得注意的是,云计算迁移历经近十年才完成,而此次AI成本切换在八个月内就完成了从7%到56%的跃升,技术扩散的速度已不可同日而语。
相关推荐

智能体变慢或出错时,用Traces在Foundry中精准排查
智能体响应慢或输出错误时该从哪排查?本文详解 Microsoft Foundry 的 Traces 追踪功能,涵盖连接 Application Insights、读懂 span 层级、查看元数据与多种视图,帮助开发者高效定位 AI 智能体问题。
18亿美元全球承诺:为AI准备生物数据意味着什么
一项18亿美元的全球资金承诺瞄准AI-ready生物数据,旨在解决AI驱动生命科学中的数据瓶颈。本文解析这笔投资的意义、潜在影响与现实挑战。

开源本地化照片管理工具:免费替代Adobe Lightroom
一款免费开源、完全本地化运行并集成AI的Adobe Lightroom替代工具在Hacker News发布。本文解析其本地化优势、AI照片管理能力及开源替代品面临的机会与挑战。