编程语言感知分词:让代码模型泛化能力提升的关键
扩展词表保留编程语言词法token边界,使代码模型HumanEval提升6.7个百分点。
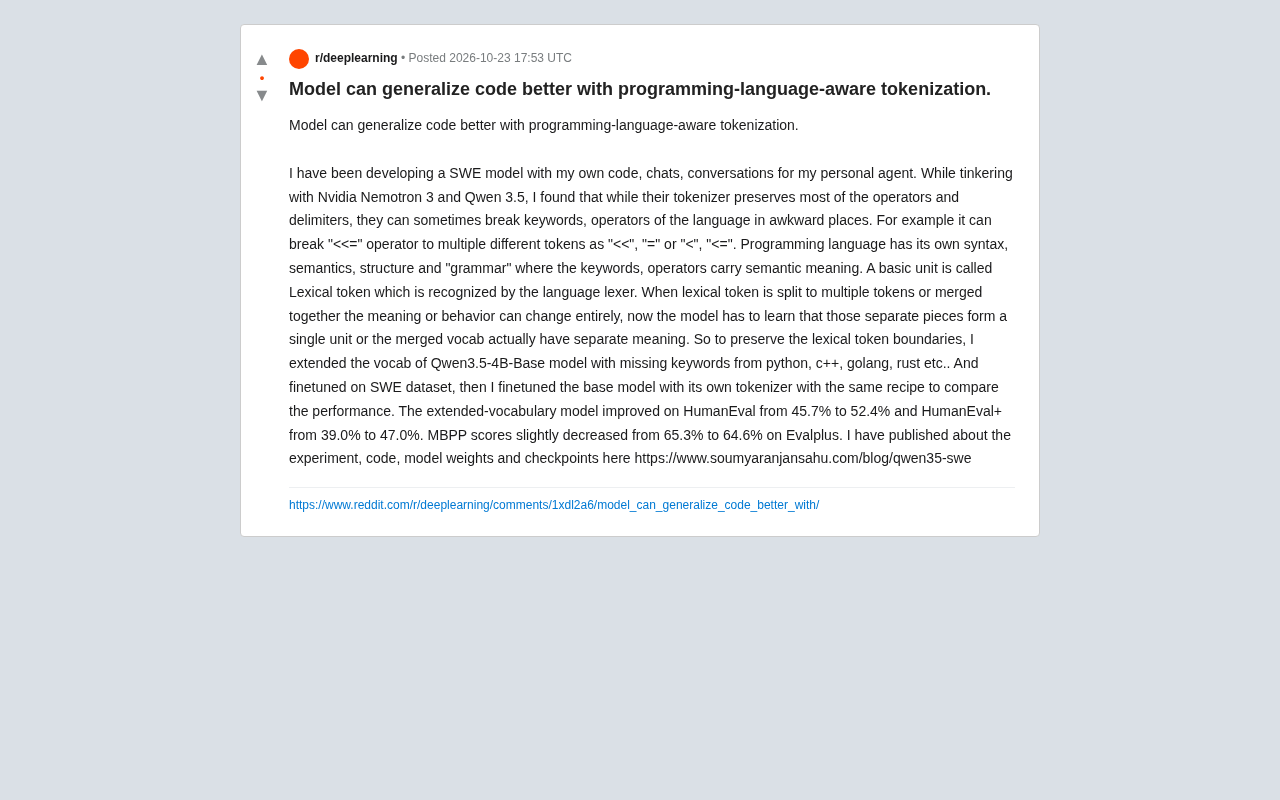
文章介绍了一位开发者在 Reddit 上分享的实验:针对代码模型分词器常将关键字和运算符在尴尬位置拆开的问题,他提出用编程语言感知的分词策略来保留词法 token 边界。实验在 Qwen3.5-4B-Base 上扩展词表,加入 Python、C++、Golang、Rust 等语言缺失的关键字,并在 SWE 数据集上微调,与使用原始分词器的模型进行控制变量对比。结果显示,扩展词表模型在 HumanEval 上从 45.7% 提升到 52.4%,HumanEval+ 从 39.0% 提升到 47.0%,但 MBPP 略微下降 0.7 个百分点。作者认为,保留词法边界能减少模型学习「碎片拼凑规则」的负担,是一种低成本、高回报的改进方向,其实验代码和模型权重已公开。
为什么代码模型的分词器需要「懂」编程语言
大型语言模型在处理代码时,分词器往往是一个被忽视的环节。一位开发者在 Reddit 上分享了他的实验:在开发个人智能体的软件工程模型时,他发现 Nvidia Nemotron 3 和 Qwen 3.5 的分词器虽然保留了大部分运算符和分隔符,但有时会在尴尬的位置拆开关键字或运算符。例如,<<= 运算符可能被拆成 <<、= 或 <、<= 等多个不同的 token。
编程语言有自己的语法、语义、结构和「文法」,关键字和运算符承载着语义含义。一个基本单元被称为词法 token,由语言词法分析器识别。当词法 token 被拆成多个 token 或合并在一起时,含义或行为可能完全改变。模型不得不额外学习「这些分离的片段其实构成一个单元」或者「这个合并的词表其实有独立含义」。这种额外的学习负担,直接影响了模型对代码的理解和生成能力。
词法 token(Lexical Token) 是编程语言编译流程中的基础概念。源代码在进入语法分析之前,会先经过词法分析器(Lexer)处理,被切分为一系列有意义的原子单元,如关键字(if、function)、标识符、运算符(<<=、+=)、字面量和分隔符。每个词法 token 是语言规范中定义的最小语义承载单位,编译器后续的语法树构建完全依赖这些边界的正确性。
值得注意的是,LLM 分词器使用的 BPE(Byte Pair Encoding)或 SentencePiece 等算法与编程语言的词法规则目标不同:前者以统计频率压缩文本为目标,后者以语法正确性为目标。这导致分词器可能将 <<= 拆分为 << 和 =,或把 function 切成 func 和 tion,破坏了词法 token 的完整性。模型因此需要额外学习「碎片重组规则」,增加了本不必要的学习负担。
实验设计:扩展词表 + 微调对比
为了保留词法 token 的边界,这位开发者采取了一种直接的方法:扩展 Qwen3.5-4B-Base 模型的词表,加入 Python、C++、Golang、Rust 等语言中缺失的关键字。然后,他在 SWE 数据集上对扩展词表后的模型进行微调。
为了公平比较,他还用相同的配方对原始基础模型(使用其自带分词器)进行了微调。两个模型在相同的训练数据和流程下训练,唯一的变量是分词器是否经过编程语言感知的扩展。这种控制变量的实验设计,使得性能差异可以归因于分词器的改进。
词表扩展(Vocabulary Expansion) 是指在已有预训练模型的分词器基础上,向词表中追加新 token 的技术。具体操作通常包括:识别目标领域中高频但未被现有分词器覆盖的字符串(如编程关键字),将其作为独立 token 加入词表,同时扩展模型对应的嵌入层(Embedding Layer)和输出层参数。新增参数的初始化通常采用已有 token 嵌入的均值或随机初始化。
词表扩展后需要微调,是因为新增 token 的嵌入向量尚未经过预训练,模型需要在下游任务中学习其表示。本实验在 SWE 数据集上微调,既让新增关键字 token 获得有意义的嵌入,也让模型适应新的分词边界。这种方法的优势在于保留了原模型的绝大部分能力,仅以较小代价引入领域适配。
性能提升:HumanEval 显著上涨,MBPP 略有下降
实验结果显示出明显的性能变化。扩展词表的模型在 HumanEval 上的通过率从 45.7% 提升到 52.4%,在 HumanEval+ 上从 39.0% 提升到 47.0%。这两个基准主要评估模型根据函数签名和文档字符串生成正确代码的能力,提升幅度分别达到 6.7 和 8.0 个百分点,说明编程语言感知的分词确实帮助模型更好地泛化到未见的代码任务。
不过,在 MBPP(Mostly Basic Programming Problems)基准上,Evalplus 版本的得分从 65.3% 略微下降到 64.6%。MBPP 的题目通常更短小、更基础,分词器改动带来的影响可能不同。这种轻微的下降值得关注,但整体来看,HumanEval 系列的大幅提升更具说服力。
HumanEval 和 MBPP 是两个广泛使用的代码生成基准,但设计取向不同。HumanEval 由 OpenAI 发布,包含 164 道手写编程题,每道题提供函数签名和文档字符串,要求模型补全函数体,评估指标为 pass@k(生成 k 个样本中至少一个通过单元测试的概率)。HumanEval+ 是 EvalPlus 团队对其的增强版本,扩充了测试用例数量,能更严格地检测代码的正确性。
MBPP(Mostly Basic Programming Problems)则包含约 1000 道入门级编程题,题目描述更简短、任务更基础。两者在难度和题型上的差异,可以解释为何分词器改进对 HumanEval 提升显著而对 MBPP 影响有限甚至轻微负面:HumanEval 的题目涉及更复杂的运算符和关键字组合,词法边界的完整性更为关键;而 MBPP 题目简短,模型对分词碎片的敏感度较低。
背后的逻辑:词法边界与模型学习负担
为什么保留词法 token 边界能带来这样的提升?核心在于减少了模型需要学习的「拼凑规则」。当分词器把 <<= 拆成 << 和 = 时,模型必须学会这两个 token 组合在一起表示左移赋值运算符。这种组合规则在训练数据中可能不够常见,导致模型在生成时犯错。而如果 <<= 本身就是一个 token,模型可以直接学习它的语义,无需额外组合。
同样,关键字被拆开也会增加学习难度。例如,function 被拆成 func 和 tion,模型需要理解这两个片段合起来是一个关键字。扩展词表将这些缺失的关键字作为独立 token 加入,让模型能够直接处理完整的词法单元。
这种方法与编程语言的设计哲学一致:词法分析是编译过程的第一步,识别出有意义的 token 是后续语法分析的基础。让模型的分词器模拟这一过程,相当于在输入层面就提供了更符合语言结构的表示。
实践启示与资源
这位开发者已经公开了实验细节、代码、模型权重和检查点,博客地址为 https://www.soumyaranjansahu.com/blog/qwen35-swe。对于想要复现或借鉴的开发者来说,这是一个宝贵的资源。
从更广的视角看,这项实验提示我们:在追求更大的模型和更多的数据之外,输入表示的优化同样重要。编程语言感知的分词器是一个低成本、高回报的改进方向,尤其对于代码生成和软件工程任务。未来,或许会有更多工作探索如何将编程语言的词法、语法甚至语义结构融入分词器设计,进一步提升代码模型的泛化能力。
当然,这项实验基于单一模型和特定数据集,结论的普适性需要更多验证。MBPP 的轻微下降也提醒我们,分词器改动可能带来权衡。但 HumanEval 上的显著提升足以说明,让分词器「懂」编程语言,是一条值得深入探索的路径。
相关推荐
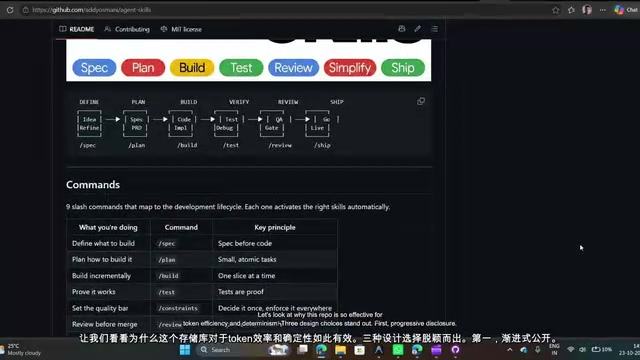
别再往CLAUDE.md塞两万行:10个技能砍掉上下文成本
与其往CLAUDE.md塞两万行规则,不如用渐进式披露的技能体系。本文拆解10个Claude Code技能:Addy Osmani Agent Skills、Graphify语义知识图谱、Superpowers子代理编排、LSP插件等,教你削减token成本并提升代码质量。

苹果iPhone Duo折叠屏开箱:万元级新物种值不值?
苹果首款折叠屏iPhone Duo开箱上手:顶配近5000加元,哑光内屏成最大亮点,折痕控制出色,护照式宽矮比例引领新形态。本文梳理屏幕、铰链、手感和价格的完整体验。
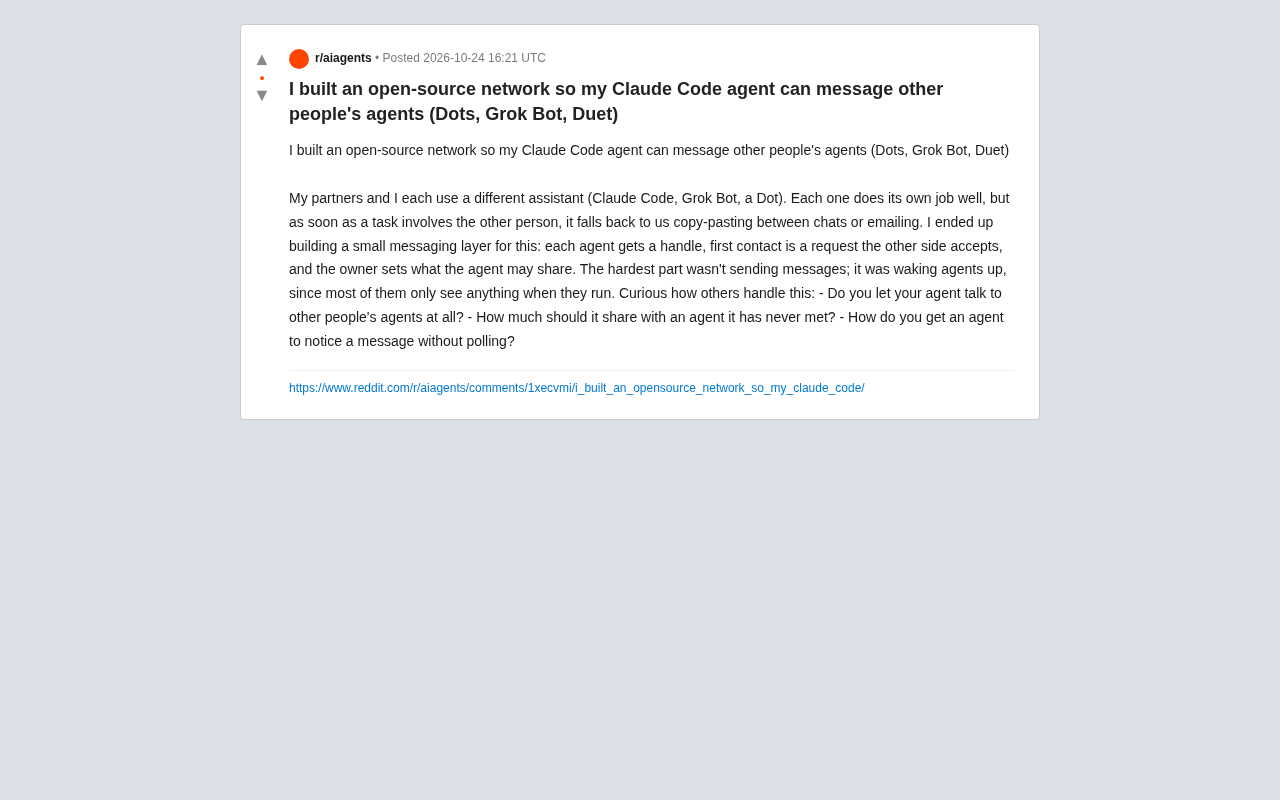
开源智能体消息网络:让Claude Code与其他AI助手直接对话
开发者构建开源消息层,让Claude Code、Grok Bot等AI智能体直接通信。项目采用句柄与握手机制控制权限,但唤醒休眠智能体成为最大技术挑战。探讨智能体互操作性的未来与信任边界。