编程智能体实战:三天迁官网、五天写Rust库背后的方法论

Lee Robinson 用三天迁 CMS、五天做 Rust 库,总结出用编程智能体高效工作的四条实战原则。
本文提炼了 Vercel 前副总裁、现 SpaceX 模型行为工程师 Lee Robinson 个人网站中与编程智能体最相关的实战经验。他用三天、260 美元将 Cursor 官网从无头 CMS 迁回代码,删除代码量是新增的七倍多;又用五天、287 美元在完全不手写代码的情况下做出了一个零依赖 Rust 图片压缩库,编译为 159KB WebAssembly。两个项目的共同经验是:把内容和配置放回代码让智能体可直接操作,以及用测试、格式检查等可自动验证的输出让智能体得以长时间自主运行。他还指出模型只在训练阶段更新权重,要智能体「记住」某件事必须写成规则文件,并主张文档应做到 AI 原生,支持 MCP 和一键复制 Markdown,将知识主动送达智能体。
斯坦福 CS146S 第三周的嘉宾是 Lee Robinson——曾在 Vercel 任职副总裁、后加入 Cursor、如今在 SpaceX 做模型行为方向的工程师。由于这节课的课件和文字稿没有公开,本文换了个思路:把他的个人网站从头读一遍,再翻了翻他链接的开源仓库,提炼出几件和「编程智能体」最相关的实战经验。需要说明的是,以下所有数字都是作者本人的自述,图片压缩库的仓库我只看了文件,没有编译运行。
三天把 Cursor 官网从 CMS 迁回代码
Cursor 官网改版后,所有内容都塞进了无头 CMS。Lee Robinson 的判断很直接:有了编程智能体,多一层抽象的代价从来没这么高。 以前一句话就能让 Cursor 改网页,现在却要回后台一层层点菜单。
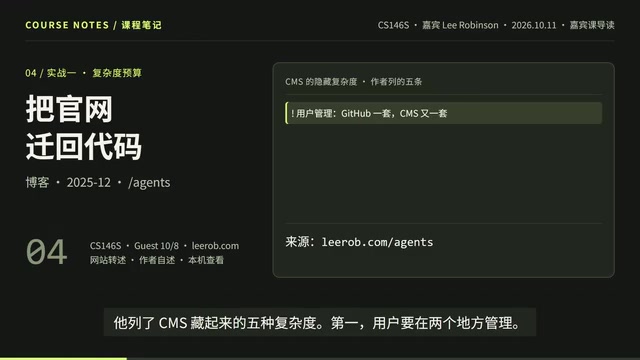
他列出了 CMS 隐藏的五种复杂度:用户要在两个地方管理内容;网站需要静态预渲染,预览草稿得另开一套机制;每种语言都要一份内容,还专门请人写了插件;成本高——上线以来 CDN 用量就花了五万六千多美元;最关键的是,内容存在网络那头,人和智能体都没法直接搜索、直接修改。
以导航栏为例,原来要请求 CMS 拿回一段 JSON,代码根本不知道有哪些链接;改成直接写在组件里之后,想改哪个链接,对智能体说一句话就够了。
迁移的执行很有参考价值:他先用 Opus 4.5 做迁移计划,智能体建议写脚本直接从接口导出内容,大约十次运行就完成了八成,剩下两成最花时间。对不上的页面,让智能体用浏览器截图和线上版本对比,一直改到一致;还用子智能体并行重构,顺手删掉几乎没用的 Storybook。
原本估计要一到两周、还可能请外包,实际只用了三天。费用 260 美元,消耗近 3 亿 token(大部分命中缓存),344 次智能体请求、67 个提交,删掉的代码是新增的 7 倍多。他的结论是:花点 token 把复杂度删掉,这笔钱很值。
五天、287 美元,不手写代码做出 Rust 压缩库
有人质疑迁官网靠的是他熟悉 React 和 Next.js,换个领域还行吗?于是他故意挑了两件以为智能体会吃力的事——更底层的 Rust 和压缩算法。目标苛刻:零运行时依赖、所有算法从头实现,而且全程不手写代码。
假期里花了五天,他做出了一个 Rust 图片压缩库:520 个智能体会话、3.5 亿 token、一共 287 美元。测试代码占了一半以上,964 个测试、覆盖率 86%,编译成 WebAssembly 只有 159KB,浏览器里就能压图片。他说性能接近一个三十年的老牌 C 语言库——这些都是他本人的说法。
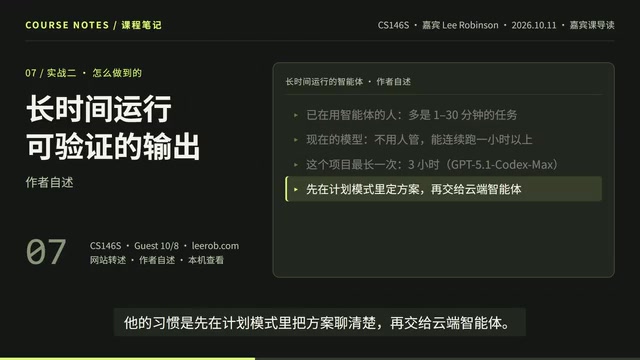
一个关键观察是:现在大多数人用智能体做的还是 1 到 30 分钟的任务,但模型已经能不用人管连续跑一个小时以上,这个项目里最长的一次跑了三个小时。他的习惯是先在计划模式里把方案聊清楚,再交给云端智能体——不少工作是他离开电脑时完成的,手机发起、几小时后回来合并。两个模型也有分工:Codex 适合跑很久的任务,Opus 写文字明显更好。
让智能体「跑得久」的核心:可验证的输出
能跑这么久不出乱子,关键在于给它可以验证的输出。项目一开始他就让智能体加上自动检查——格式、代码规范和测试,检查没过智能体就读报错接着改,全部通过才提交 PR。大部分代码他自己也审了,PR 还交给 Bugbot 再审一遍。
他特别提醒:别过度优化工作流。一开始他一条规则都没写,等模型犯了几次错(比如用错检查命令),才补了一份简短的规则文件和几段常用提示词,后来打包成一个九步的发布命令,从写更新日志到打标签发布,每一步都要求自动执行而非只提醒用户。这和课程里讲的「技能」是同一个思路:把反复做的流程写成文件。
「可验证的输出」这个概念在智能体工程中有更正式的叫法:可观测性约束(observability constraints)。其核心逻辑是:智能体在自主运行时无法像人类一样依靠直觉判断「这步走对了没有」,因此必须把「对」的标准外化成机器可检查的信号。常见的信号层次从低到高依次是:编译通过(静态正确性)、lint/格式检查(风格一致性)、单元测试通过(行为正确性)、端到端测试或视觉对比(集成正确性)。层次越高,信号越接近真实需求,但执行成本也越高。Lee Robinson 在 Rust 压缩库项目中选择的是「格式 + 代码规范 + 测试」三层叠加,这种组合的优点是每一层都能完全自动判定对错,不需要再回问人类,智能体可以自行完成「执行 → 读取报错 → 修正 → 再执行」的闭环。这也是为什么测试代码最终占了整个项目一半以上——测试不只是保证质量的手段,更是给智能体提供「路标」的基础设施。
从模型训练到持续学习
Lee Robinson 现在做的是模型行为方向。他把模型比作同事:好同事会沟通,知道什么时候该问人,还能啃下说不清楚的问题。第一步是把这种理想行为写成文档——有人叫模型规范,有人叫宪法。
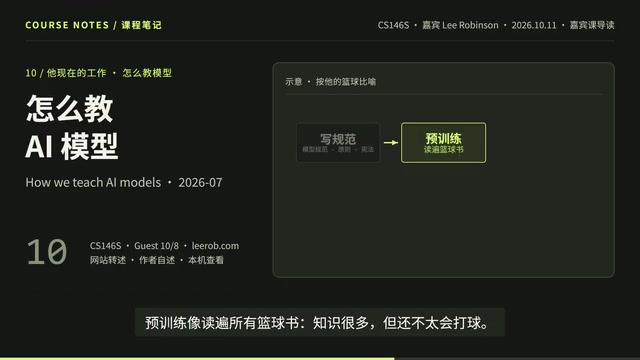
他用篮球打了个比方:预训练像读遍所有篮球书,知识很多但还不太会打球;接着给它看大量好示范,像看高手比赛录像照着学;再让它上场打模拟比赛,打得好就给奖励,这就是强化学习。评分有两种——能对答案的练习题,和从没见过的期末考,有的题自动判(比如测试过没过),有的交给另一个模型按标准打分。
光聪明还不够,研究员会和训练中的模型大量聊天,记下它的怪癖(比如动不动用套话,或为了简短把话说得别人看不懂),然后惩罚这些坏习惯,再上线做对照实验看用户更喜欢哪个。
关于持续学习,他的观点很值得注意:今天的模型只在训练时学习,你和它聊得再多也不会让模型本身变聪明。 要它记住什么,就得写成规则或技能文件,让智能体读进上下文。他说这种「拿文件当记忆」的办法出奇地好用,但离新同事那样真正学习还远。
这正好接上课程后续安排:讲技能、讲给智能体的规则,以及 Claude Code 作者 Boris Cherny 的嘉宾课。Boris 举过训练编程智能体的例子——从懂代码的开源模型起步,用代码数据再训练一轮,强化学习的奖励可以自动给(能不能编译、测试过没过、问题解决没有),训练环境要和真实产品一样,用同一套读文件、搜代码、跑终端的工具。他说 Cursor 训练 Composer 就是这么做的。
Lee Robinson 提到的训练流程在学术上对应RLHF(从人类反馈中强化学习,Reinforcement Learning from Human Feedback)及其衍生范式。其基本步骤是:先用大规模文本做预训练得到基础模型,再通过有监督微调(SFT)让模型学会指令跟随,最后用强化学习阶段根据奖励信号进一步对齐人类偏好。他提到的「好示范录像」对应 SFT 阶段,「上场打模拟赛、打得好给奖励」对应 RL 阶段。奖励来源分为两类:一类是可自动判定的奖励(如测试是否通过、代码是否编译),另一类是模型打分奖励,即用一个独立的「奖励模型」来评估输出质量,这个奖励模型本身是用人类标注数据训练出来的。值得注意的是,他强调今天的模型在推理阶段不更新权重,这意味着用户在对话中提供的任何反馈都只影响当次上下文,不会持久化到模型参数里——这正是「要它记住的就写成文件」这一实践建议的技术根源。
文档、社区与「个人软件」
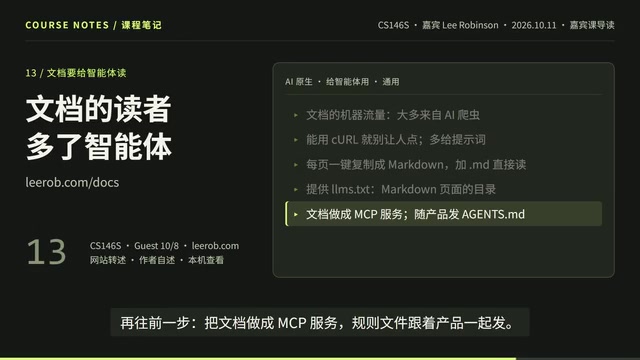
Lee Robinson 的笔记里有一篇专讲文档,列了好文档的十个标准。大部分是老规矩——要快、好读、有用、精致、本地化、无障碍。最特别的是两条新的:人工智能原生和给智能体用。他说现在访问文档的机器流量大多来自智能体,所以能用命令解决的就别让人去点按钮;每一页都能一键复制成 Markdown,换个后缀就能直接读原文;还要提供一个给大模型看的目录文件,列出所有页面;再往前一步,把文档做成 MCP 服务,甚至发布评测告诉用户哪个模型最适合用你的产品。这和课程里讲的 MCP 是同一个方向——把知识送到智能体手边。
他管过开发者关系,把开发者体验归成三件事:社区是长期投资,九成互动应该在帮人,只有一成才提要求;教育是最好的营销,仅次于客户自己的好评;产品工程师应从想要的体验倒推需要什么技术,工具帮不上忙就删掉——这和前面删 CMS 是同一个思路。
还有一篇叫《个人软件》:有了 AI,人人都能做只给自己用的软件。他刚当父亲时就给自家做了个记录宝宝睡觉和吃奶的小应用,还打了个比方——做软件会像做饭,自己下过厨反而更懂得欣赏好餐厅。
MCP(Model Context Protocol) 是 Anthropic 于 2024 年底发布的开放协议,旨在为大语言模型提供标准化的外部工具和数据接入方式。类比 USB-C 的角色:在 MCP 之前,每个 AI 产品接入外部数据源(数据库、文档、API)都要单独开发适配层;MCP 定义了统一的「服务器—客户端」通信规范,让任何遵循协议的工具都能被任何支持 MCP 的模型直接调用,无需重复集成。把文档做成 MCP 服务,意味着智能体在编写代码时可以主动「查阅」文档,而不是依赖训练时记住的过时知识。Lee Robinson 提到的「给大模型看的目录文件」通常以 llms.txt 命名,这是一个正在形成中的非正式行业惯例——在网站根目录放置一份结构化的纯文本索引,列出所有页面及其简短描述,供爬取文档的智能体快速定位相关内容,功能上类似于 robots.txt 之于搜索引擎爬虫。
读完网站,和这门课最相关的四点
- 把内容和配置放回代码里,智能体看得见,才改得动;
- 给它测试、检查和基准这种能验证的输出,它才能放心跑很久;
- 写代码不再稀缺,稀缺的是判断——做什么、不做什么;
- 模型不会从对话里学习,要它记住的就写成规则或技能文件。
再强调一次,本文总结的是他的个人网站,而非那节讲座内容;文中数字均为作者自述,图片压缩库的仓库我只看了文件、没有运行。他的文章大多不长,很值得读一读原文。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。